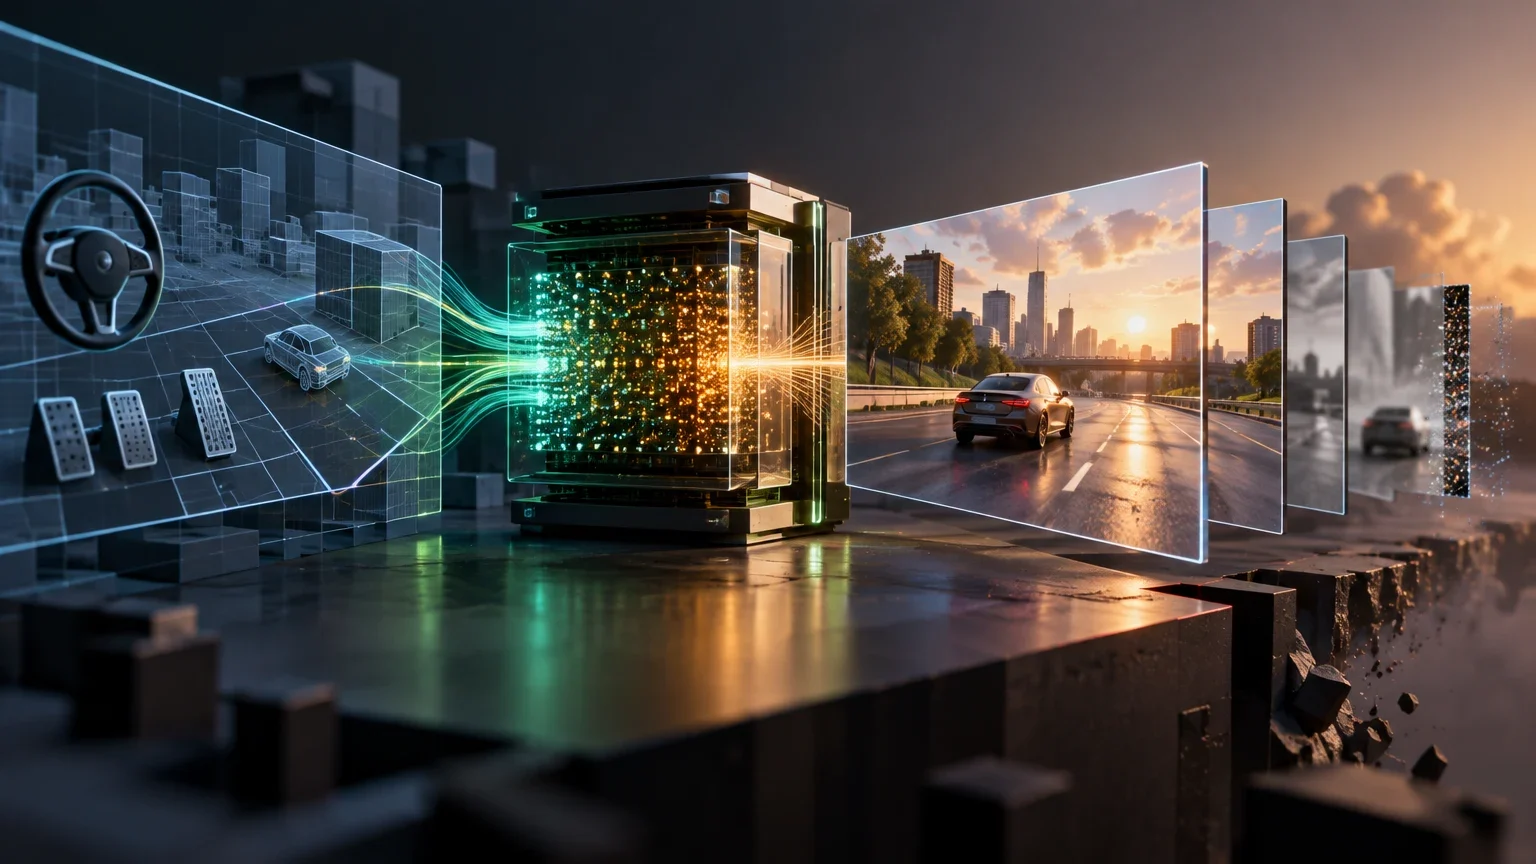
Ce que fait exactement Cosmos3-Nano-Sim-Transfer
Cosmos3-Nano-Sim-Transfer est un modèle de fondation pour l'IA physique développé par NVIDIA, publié le 20 octobre 2026. Sa fonction principale n'est pas de simuler la physique du monde, mais de générer l'apparence visuelle (vidéo RGB) à partir de contrôles structurels fournis par un simulateur classique. Il accepte des entrées textuelles et des contrôles visuels tels que des cartes de profondeur, des segmentations, des contours ou des flous, et produit des séquences vidéo imitant l'apparence photographique de la scène simulée.
Il est crucial de distinguer ce modèle d'un moteur de physique : la géométrie, la permanence des objets et les lois physiques restent la responsabilité du simulateur traditionnel. Le réseau neuronal apporte la couche visuelle. Par conséquent, ce n'est pas une politique qui génère des actions pour des robots ni un outil de certification de sécurité, mais un générateur de données synthétiques visuelles pour entraîner et évaluer des modèles de perception.
Cette distinction architecturale est fondamentale pour comprendre la chaîne de valeur du modèle. En séparant strictement la simulation physique, qui reste le domaine du moteur classique, de la synthèse visuelle, le modèle permet de découpler les coûts de calcul. Les simulateurs physiques traditionnels sont souvent limités par la complexité des interactions et la résolution des maillages, tandis que la génération neuronale peut produire des rendus haute fidélité sans recalculer les équations différentielles sous-jacentes à chaque frame. Cela signifie que l'équipe d'ingénierie peut itérer sur l'apparence des matériaux, l'éclairage ou les textures sans modifier la logique de simulation, accélérant ainsi le cycle de développement des jeux de données pour l'entraînement des réseaux de perception.
Le rôle de générateur de données synthétiques implique également une réflexion sur la diversité des scénarios. En fournissant des contrôles structurels variés, il est possible de générer des variations visuelles massives de la même scène physique, ce qui est difficile à obtenir par la capture réelle. Cette capacité à augmenter les données par la synthèse visuelle aide à réduire le sur-apprentissage des modèles de perception, en leur exposant à des conditions de luminosité, de météo ou d'occlusion qui sont physiquement cohérentes mais visuellement variées. L'objectif final reste l'amélioration de la robustesse des algorithmes de vision par ordinateur, et non la création d'un monde virtuel autonome.
Architecture et modalités d'entrée et de sortie
Le modèle utilise une architecture Transformer avec Mixture-of-Transformers (MoT), une technique permettant de gérer efficacement plusieurs modalités. La variante Nano compte 16 milliards de paramètres entraînables, se situant entre la version Edge (4B) et la Super (64B) de la famille Cosmos3.
Les modalités d'entrée incluent le texte (prompts de description), la vidéo (contrôles de transfert ou références) et des paramètres d'action dans certains modes. La sortie principale est une vidéo au format MP4 avec piste VP9. Pour la variante Sim-Transfer, les contrôles typiques sont des cartes de profondeur, des segmentations sémantiques, des contours et des flous, qui guident la génération visuelle en maintenant la cohérence avec la structure physique sous-jacente.
L'adoption de l'architecture Mixture-of-Transformers (MoT) répond au défi spécifique de la multimodalité dans la génération vidéo. Contrairement aux architectures standard qui traitent les tokens de manière uniforme, MoT permet de spécialiser des sous-réseaux pour différentes modalités d'entrée, comme le texte ou les cartes de profondeur. Cette spécialisation améliore l'efficacité du calcul en évitant de traiter inutilement des informations redondantes, ce qui est crucial pour un modèle de 16 milliards de paramètres. La position intermédiaire de la variante Nano dans la famille Cosmos3 offre un compromis entre la capacité de représentation et la charge computationnelle, la rendant accessible pour des équipes disposant d'un cluster GPU modéré mais nécessitant une qualité supérieure à celle des modèles plus petits.
La sortie en format MP4 avec piste VP9 est un choix technique orienté vers l'intégration directe dans les pipelines de traitement vidéo standard. VP9 est un codec open source qui offre une bonne compression pour les flux vidéo, réduisant ainsi les coûts de stockage et de bande passante lors du transfert des données générées. La disponibilité de résolutions allant de 256p à 720p permet d'adapter la granularité des données selon les besoins du modèle de perception aval. Par exemple, une résolution plus basse peut suffire pour l'entraînement de détecteurs d'objets globaux, tandis qu'une résolution plus élevée est nécessaire pour des tâches de segmentation fine ou de reconnaissance de textures. Cette flexibilité de sortie facilite l'intégration du modèle dans des workflows hétérogènes.
Modalités et paramètres clés de Cosmos3-Nano
Résumé des capacités d'entrée et de sortie selon la documentation officielle de NVIDIA.
| Composant | Détail |
|---|---|
| Architecture | Transformer MoT (Mixture-of-Transformers) |
| Paramètres | 16B (Nano) |
| Entrées | Texte, Vidéo (contrôles), Paramètres d'action |
| Sortie | Vidéo MP4 (VP9), Image JPEG |
| Résolutions | 256p, 480p, 720p (aspects 16:9, 1:1, etc.) |
Benchmarks publiés et méthodologie d'évaluation
NVIDIA publie des résultats dans le benchmark PAI-Bench-C, spécifiquement dans la section TransferBench. Il est important de noter que ces données proviennent du fournisseur et n'ont pas été répliquées de manière indépendante par Inferama ni par des tiers vérifiés au moment de cette analyse. Les métriques incluent DOVER (qualité technique de la vidéo), mIoU (segmentation) et SI-RMSE (erreur de profondeur).
Les valeurs publiées pour ce checkpoint spécifique sont : DOVER de 10,175942, mIoU de segmentation de 0,73776 et SI-RMSE de profondeur de 0,619426. Ces métriques mesurent la fidélité visuelle et la cohérence avec les contrôles d'entrée, mais ne garantissent pas la précision physique de la simulation. Un DOVER élevé indique une vidéo visuellement propre, pas que les objets se déplacent selon les lois de Newton.
L'absence de réplique indépendante des benchmarks PAI-Bench-C impose une prudence dans l'interprétation des métriques. Les valeurs de DOVER, mIoU et SI-RMSE sont des indicateurs de performance interne du fournisseur, qui peuvent être optimisés pour des conditions de test spécifiques. Par conséquent, ces chiffres doivent être considérés comme des points de référence relatifs plutôt que comme des garanties absolues de performance dans des environnements de production variés. Les équipes qui intègrent ce modèle dans leurs pipelines doivent prévoir une phase de validation empirique sur leurs propres données de contrôle, afin de vérifier que la cohérence visuelle et la fidélité structurelle annoncées se maintiennent dans leurs cas d'usage spécifiques.
La métrique SI-RMSE, qui mesure l'erreur de reconstruction de la profondeur, est particulièrement pertinente pour les applications de robotique où la perception 3D est essentielle. Une valeur basse indique que le modèle parvient à maintenir une correspondance spatiale précise entre les pixels générés et les données de profondeur d'entrée. Cependant, comme souligné précédemment, cette précision ne se traduit pas par une dynamique physique correcte. Un objet peut être positionné correctement dans l'espace 3D à un instant t, mais son mouvement à t+1 peut être incohérent avec les lois de la physique. Cette dissociation entre la géométrie instantanée et la dynamique temporelle est une caractéristique inhérente à la nature générative du modèle, qui optimise la vraisemblance visuelle plutôt que la rigueur physique.
Métriques de TransferBench (PAI-Bench-C)
Valeurs publiées par NVIDIA pour Cosmos3-Nano-Sim-Transfer. Plus c'est bas, mieux c'est pour SI-RMSE ; plus c'est haut, mieux c'est pour DOVER et mIoU.
| Métrique | Valeur | Interprétation |
|---|---|---|
| DOVER | 10,175942 | Qualité technique de la vidéo générée |
| Segmentation mIoU | 0,73776 | Précision de la segmentation sémantique |
| Depth SI-RMSE | 0,619426 | Erreur de reconstruction de la profondeur |
Exigences de déploiement et coût d'infrastructure
Le modèle est distribué sous la licence OpenMDW-1.1, ce qui permet son usage commercial et non commercial, à condition de respecter les termes de la licence. Les poids sont disponibles publiquement sur Hugging Face et le code sur GitHub. Cependant, il n'existe pas de tarif d'API directe publié par NVIDIA pour ce checkpoint spécifique dans les sources primaires vérifiées ; le coût repose sur l'infrastructure propre de l'utilisateur.
Pour l'inférence, du matériel GPU de NVIDIA est requis, spécifiquement les architectures Blackwell (GB200) ou Hopper (H100, H200, H20). Les performances varient considérablement selon la résolution, le nombre de frames et le parallélisme. Par exemple, générer 201 frames à 480p sur un seul GPU H100 peut prendre plusieurs minutes, tandis qu'en configurations multi-GPU, le temps est réduit significativement. Le coût doit budgéter GPU, mémoire, stockage et opération, car les poids gratuits n'éliminent pas le coût computationnel.
La dépendance exclusive aux architectures GPU NVIDIA Blackwell et Hopper reflète l'optimisation profonde du code et des bibliothèques d'inférence, telles que vLLM-Omni, pour ces microarchitectures spécifiques. Cette contrainte matérielle élimine la possibilité de déploiement sur des processeurs graphiques d'autres fabricants ou sur des unités de traitement central (CPU), ce qui limite la portabilité du modèle. Pour les organisations qui ne disposent pas d'infrastructures NVIDIA de dernière génération, le coût d'entrée est significatif, non seulement en termes d'achat de matériel, mais aussi en termes de compétences techniques nécessaires pour configurer et maintenir ces environnements. La licence OpenMDW-1.1, bien que permissive, ne réduit pas cette barrière à l'entrée infrastructurelle.
Le processus de déploiement local, qui implique la configuration de PyTorch et la gestion des poids sur Hugging Face, nécessite une expertise en ingénierie des modèles. La décodification de la réponse base64 en fichier MP4 est une étape critique qui doit être intégrée de manière fluide dans le pipeline de données. Toute latence ou erreur dans cette étape de post-traitement peut impacter la productivité globale du système de génération de données. De plus, la gestion de la mémoire GPU est un facteur limitant majeur, car les 16 milliards de paramètres du modèle Nano occupent une part importante de la mémoire vidéo, réduisant la capacité à traiter des lots de données simultanés ou des résolutions élevées sans partitionnement de mémoire.
Processus de déploiement local
Étapes de base pour exécuter le modèle sur une infrastructure propre.
- 01Télécharger les poids depuis Hugging Face (nvidia/Cosmos3-Nano-Sim-Transfer).
- 02Configurer un environnement avec PyTorch et vLLM-Omni compatible avec GPU NVIDIA.
- 03Démarrer le serveur d'inférence en spécifiant la classe de pipeline appropriée.
- 04Envoyer des requêtes avec des contrôles de simulation (profondeur, segmentation) et des prompts texte.
- 05Décoder la réponse base64 en un fichier MP4 pour un usage ultérieur.
Limites, sécurité et alternatives
La principale limite est le manque de précision physique garantie. La génération peut présenter des incohérences temporelles, un mouvement instable ou des interactions physiques imprécises. NVIDIA avertit explicitement que le modèle n'est pas conçu pour des applications critiques de sécurité où l'échec pourrait causer des blessures ou des dommages catastrophiques. Il nécessite une validation indépendante et une analyse de sécurité au niveau système.
En matière de sécurité, les médias d'entrée sont soumis à un cribage obligatoire de matériel d'abus sexuel sur mineurs (CSAM) et à d'autres garde-fous de contenu. Les sorties visuelles portent un filigrane SynthID, bien que les tableaux de données d'action numériques ne soient pas marqués visuellement. En alternative, la variante Cosmos3-Nano-Transfer-Auto se spécialise dans la conduite autonome avec LiDAR, tandis que Sim-Transfer se concentre sur la simulation générale de robotique et industrielle.
Les garde-fous de sécurité, notamment le criblage CSAM et le filigrane SynthID, sont des composants intégrés au pipeline de génération et non optionnels. Le filigrane SynthID est conçu pour être imperceptible à l'œil nu mais détectable par des algorithmes, permettant de tracer l'origine synthétique des contenus visuels. Cette mesure est essentielle pour distinguer les données générées par IA des captures réelles, ce qui est crucial dans les contextes où l'intégrité des données est un enjeu, comme dans la recherche ou l'audit. L'absence de marquage sur les tableaux de données d'action numériques souligne que la sécurité se concentre sur la sortie visuelle, laissant la responsabilité de la sécurité des données structurelles à l'utilisateur.
La distinction entre Sim-Transfer et Transfer-Auto est un critère de sélection important pour les équipes spécialisées. Transfer-Auto est optimisé pour les données LiDAR, ce qui le rend plus adapté aux véhicules autonomes qui dépendent fortement de la perception 3D par laser. Sim-Transfer, en revanche, est conçu pour une simulation générale, couvrant une gamme plus large de scénarios robotiques et industriels. Cette spécialisation signifie que les équipes doivent évaluer précisément leurs besoins en termes de modalités de capteurs avant de choisir la variante appropriée, afin d'éviter les coûts de développement inutiles ou les performances sous-optimales.
Critères pratiques pour le choix du modèle
La décision d'utiliser Cosmos3-Nano-Sim-Transfer dépend de la nécessité de générer des données synthétiques visuelles à grande échelle pour entraîner des modèles de perception, et de la disponibilité de l'infrastructure GPU requise. Si l'objectif est de simuler une physique précise pour un contrôle en temps réel, ce modèle n'est pas adapté ; il doit être utilisé comme complément visuel à un simulateur physique classique.
Pour les équipes aux ressources limitées, la variante Edge (4B) pourrait être plus viable, bien qu'avec une qualité moindre. Pour les applications de conduite autonome avec capteurs LiDAR, la variante Transfer-Auto est plus spécifique. Le choix doit se baser sur l'équilibre entre qualité visuelle, coût computationnel et besoin de cohérence physique, en maintenant toujours la validation humaine et technique des résultats.
L'équilibre entre la qualité visuelle et le coût computationnel est le facteur déterminant dans le choix de la variante du modèle. La variante Edge (4B) offre une alternative plus légère pour les équipes avec des ressources limitées, mais elle peut souffrir d'une moindre fidélité dans les détails fins ou la cohérence temporelle. Pour les applications où la précision des textures ou des interactions visuelles est critique, la variante Nano (16B) ou Super (64B) sera préférable, à condition que l'infrastructure GPU puisse supporter la charge. Cette décision doit être prise en tenant compte du volume de données à générer et de la fréquence des itérations, car les coûts cumulés de l'inférence peuvent rapidement dépasser le budget initial.
La validation humaine et technique des résultats reste une étape indispensable, indépendamment de la variante choisie. Les métriques automatiques ne capturent pas toutes les nuances de la qualité perçue ou de la cohérence sémantique. Une revue par des experts du domaine permet d'identifier des artefacts subtils ou des incohérences contextuelles qui pourraient échapper aux algorithmes d'évaluation. Cette approche hybride, combinant l'efficacité de la génération neuronale et la rigueur de la validation humaine, est la clé pour tirer le meilleur parti de Cosmos3-Nano-Sim-Transfer dans des applications professionnelles exigeantes.
Tableau de décision : Quand utiliser Sim-Transfer ?
Guide rapide pour déterminer l'adéquation du modèle selon le cas d'usage.
| Cas d'usage | Adéquation | Motif |
|---|---|---|
| Générer des données synthétiques pour entraîner la vision par ordinateur | Haute | Génère une vidéo RGB réaliste à partir de contrôles structurels. |
| Simulation physique précise pour le contrôle de robots | Basse | Ce n'est pas un moteur de physique ; la précision physique n'est pas garantie. |
| Conduite autonome avec LiDAR | Moyenne/Basse | Utiliser Transfer-Auto pour le LiDAR ; Sim-Transfer est plus généraliste. |
| Déploiement sur CPU ou GPU de faible coût | Basse | Requiert un GPU NVIDIA haute performance (Hopper/Blackwell). |
Questions ouvertes
- Aucun tarif d'API directe de NVIDIA pour ce checkpoint spécifique n'a été vérifié ; les coûts sont ceux de l'infrastructure propre.
- Les benchmarks de PAI-Bench-C proviennent du fournisseur et n'ont pas été répliqués de manière indépendante.
- Les performances exactes sur un matériel spécifique non fourni par l'utilisateur peuvent varier selon la configuration de parallélisme et la charge du système.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction