Was genau Cosmos3-Nano-Sim-Transfer leistet
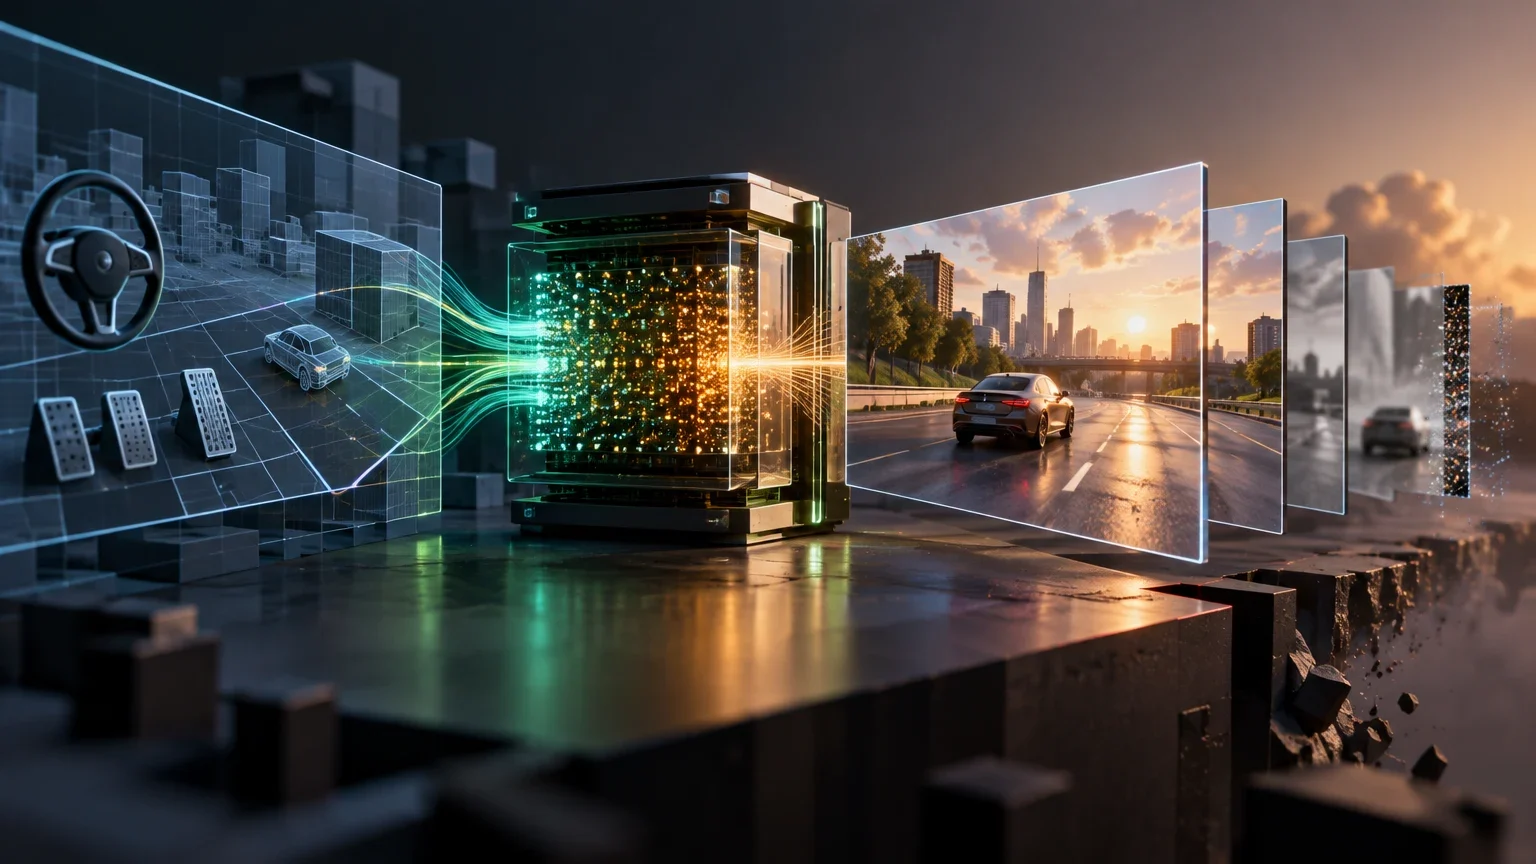
Cosmos3-Nano-Sim-Transfer ist ein Foundation-Modell für Physical AI, entwickelt von NVIDIA und am 20. Oktober 2026 veröffentlicht. Seine Hauptaufgabe besteht nicht darin, die Physik der Welt zu simulieren, sondern visuelle Erscheinungen (RGB-Videos) auf der Grundlage strukturierter Steuerungen zu generieren, die von einem klassischen Simulator bereitgestellt werden. Es akzeptiert Texteingaben und visuelle Steuerungen wie Tiefenkarten, Segmentierungen, Kanten oder Unschärfe und erzeugt Videosequenzen, die das fotografische Aussehen der simulierten Szene nachahmen.
Es ist entscheidend, dieses Modell von einem Physik-Engine zu unterscheiden: Geometrie, Objektpermanenz und physikalische Gesetze bleiben die Verantwortung des traditionellen Simulators. Das neuronale Netz liefert die visuelle Schicht. Daher ist es keine Policy, die Aktionen für Roboter erzeugt, noch ein Werkzeug zur Sicherheitszertifizierung, sondern ein Generator für synthetische visuelle Daten, um Wahrnehmungsmodelle zu trainieren und zu evaluieren.
Die Trennung zwischen der physikalischen Berechnung und der visuellen Darstellung ist der Kern dieses Ansatzes. Während der klassische Simulator die mathematischen Grundlagen für die Position und Bewegung der Objekte liefert, übernimmt das neuronale Netz die Aufgabe, diese abstrakten Daten in eine für das menschliche Auge oder für visuelle Algorithmen verständliche Form zu übersetzen. Dies bedeutet, dass die Integrität der simulierten Welt von der Qualität des zugrunde liegenden Simulators abhängt, während die ästhetische und texturale Qualität vom Modell bestimmt wird. Eine Fehlfunktion in der Physik wird nicht vom Modell korrigiert, sondern lediglich in ein realistisches Bild übersetzt, was die Notwendigkeit einer präzisen Eingabe unterstreicht.
Der Fokus auf die Generierung von RGB-Videos statt auf die Berechnung von Kräften ermöglicht eine hohe Flexibilität bei der Anpassung der visuellen Umgebung. Durch die Verwendung von Texteingaben können Szenarien beschrieben werden, die im klassischen Simulator schwer zu modellieren wären, wie etwa spezifische Wetterbedingungen oder Materialtexturen. Die Kombination aus strukturierten Steuerungen und textuellen Beschreibungen erlaubt es, eine breite Palette visueller Stile zu erzeugen, die für das Training von Wahrnehmungsmodellen unter variierenden Bedingungen nützlich sind. Diese Vielseitigkeit macht das Modell zu einem wertvollen Werkzeug für die Erstellung synthetischer Datensätze, die in der realen Welt schwer zu sammeln wären.
Architektur und Eingabe-/Ausgabemodalitäten
Das Modell verwendet eine Transformer-Architektur mit Mixture-of-Transformers (MoT), einer Technik, die es ermöglicht, mehrere Modalitäten effizient zu verarbeiten. Die Nano-Variante verfügt über 16 Milliarden trainierbare Parameter und positioniert sich zwischen der Edge-Version (4B) und der Super-Version (64B) der Cosmos3-Familie.
Die Eingabemodalitäten umfassen Text (Beschreibungs-Prompts), Video (Transfer-Steuerungen oder Referenzen) und Aktionsparameter in bestimmten Modi. Die Hauptausgabe ist Video im MP4-Format mit VP9-Track. Für die Sim-Transfer-Variante sind die typischen Steuerungen Tiefenkarten, semantische Segmentierung, Kanten und Unschärfe, die die visuelle Generierung leiten und die Kohärenz mit der zugrunde liegenden physikalischen Struktur aufrechterhalten.
Die Mixture-of-Transformers-Architektur ist entscheidend für die effiziente Verarbeitung der verschiedenen Eingabemodalitäten. Anstatt separate Netzwerke für Text, Bild und Video zu verwenden, integriert MoT diese Informationen in einem gemeinsamen Rahmen, was die Kohärenz zwischen den verschiedenen Datenströmen fördert. Die 16 Milliarden Parameter der Nano-Variante stellen einen Kompromiss zwischen Rechenlast und Leistungsfähigkeit dar, der es ermöglicht, das Modell auf Hochleistungs-GPUs auszuführen, ohne die extreme Infrastruktur der größeren Super-Variante zu benötigen. Diese Positionierung innerhalb der Cosmos3-Familie macht es zu einer praktischen Wahl für Teams, die eine ausgewogene Leistung bei akzeptablen Hardwarekosten suchen.
Die Unterstützung für verschiedene Auflösungen, von 256p bis 720p, bietet Flexibilität bei der Datenerstellung. Niedrigere Auflösungen können für schnelle Iterationen oder das Training von Modellen mit geringerer Auflösung verwendet werden, während höhere Auflösungen für die Erstellung hochwertiger synthetischer Daten geeignet sind. Die Ausgabe im MP4-Format mit VP9-Codec gewährleistet eine effiziente Kompression, die den Speicherbedarf und die Übertragungszeiten reduziert. Diese technischen Details sind für die Integration in bestehende Pipelines wichtig, da sie die Kompatibilität mit Standard-Videoverarbeitungswerkzeugen sicherstellen und die nahtlose Weiterverarbeitung der generierten Daten ermöglichen.
Modalitäten und Schlüsselparameter von Cosmos3-Nano
Zusammenfassung der Eingabe- und Ausgabefähigkeiten gemäß der offiziellen NVIDIA-Dokumentation.
| Komponente | Detail |
|---|---|
| Architektur | Transformer MoT (Mixture-of-Transformers) |
| Parameter | 16B (Nano) |
| Eingaben | Text, Video (Steuerungen), Aktionsparameter |
| Ausgabe | Video MP4 (VP9), Bild JPEG |
| Auflösungen | 256p, 480p, 720p (Seitenverhältnisse 16:9, 1:1 usw.) |
Veröffentlichte Benchmarks und Evaluationsmethodik
NVIDIA veröffentlicht Ergebnisse im Benchmark PAI-Bench-C, speziell im Abschnitt TransferBench. Es ist wichtig zu beachten, dass diese Daten vom Anbieter stammen und zum Zeitpunkt dieser Analyse weder von Inferama noch von verifizierten Dritten unabhängig repliziert wurden. Die Metriken umfassen DOVER (technische Videoqualität), mIoU (Segmentierung) und SI-RMSE (Tiefenfehler).
Die veröffentlichten Werte für diesen spezifischen Checkpoint sind: DOVER von 10,175942, Segmentierungs-mIoU von 0,73776 und Tiefen-SI-RMSE von 0,619426. Diese Metriken messen die visuelle Treue und die Kohärenz mit den Eingabesteuerungen, garantieren aber nicht die physikalische Genauigkeit der Simulation. Ein hoher DOVER-Wert zeigt ein visuell sauberes Video an, nicht dass sich Objekte gemäß den Newtonschen Gesetzen bewegen.
Die Interpretation der Benchmarks erfordert ein kritisches Verständnis der jeweiligen Metriken. DOVER misst die wahrgenommene Qualität des Videos, was bedeutet, dass ein hoher Wert auf ein scharfes, rauscharmes Bild hindeutet, aber nichts über die physikalische Plausibilität aussagt. mIoU bewertet, wie gut die semantische Segmentierung des generierten Videos mit der Eingabe übereinstimmt, was für die Konsistenz der Objekterkennung wichtig ist. SI-RMSE misst den Fehler in der Tiefenrekonstruktion, wobei ein niedrigerer Wert eine genauere räumliche Darstellung anzeigt. Diese Metriken sind nützlich, um die technische Qualität der Ausgabe zu bewerten, ersetzen aber keine umfassende Validierung der physikalischen Genauigkeit.
Da die Daten vom Anbieter stammen und nicht unabhängig repliziert wurden, sollten sie als Referenzwerte und nicht als absolute Wahrheiten betrachtet werden. Die tatsächliche Leistung kann je nach den spezifischen Eingabedaten und der Hardwarekonfiguration variieren. Es ist ratsam, eigene Tests durchzuführen, um die Eignung des Modells für den jeweiligen Anwendungsfall zu bestätigen. Die Veröffentlichung dieser Benchmarks dient der Transparenz und ermöglicht es Nutzern, eine erste Einschätzung der Leistungsfähigkeit zu erhalten, bevor sie in die Infrastruktur investieren. Dennoch bleibt die unabhängige Validierung ein wesentlicher Schritt im Entwicklungsprozess.
TransferBench-Metriken (PAI-Bench-C)
Von NVIDIA veröffentlichte Werte für Cosmos3-Nano-Sim-Transfer. Für SI-RMSE ist niedriger besser; für DOVER und mIoU ist höher besser.
| Metrik | Wert | Interpretation |
|---|---|---|
| DOVER | 10,175942 | Technische Qualität des generierten Videos |
| Segmentierung mIoU | 0,73776 | Genauigkeit der semantischen Segmentierung |
| Tiefe SI-RMSE | 0,619426 | Fehler bei der Tiefenrekonstruktion |
Deployment-Anforderungen und Infrastrukturkosten
Das Modell wird unter der Lizenz OpenMDW-1.1 vertrieben, was eine kommerzielle und nicht-kommerzielle Nutzung erlaubt, sofern die Lizenzbedingungen eingehalten werden. Die Gewichte sind öffentlich auf Hugging Face verfügbar und der Code auf GitHub. Es gibt jedoch keine von NVIDIA für diesen spezifischen Checkpoint in den verifizierten Primärquellen veröffentlichte direkte API-Gebühr; die Kosten liegen bei der eigenen Infrastruktur des Nutzers.
Für die Inferenz ist NVIDIA-GPU-Hardware erforderlich, speziell Architekturen wie Blackwell (GB200) oder Hopper (H100, H200, H20). Die Leistung variiert je nach Auflösung, Frame-Anzahl und Parallelisierung drastisch. Beispielsweise kann die Generierung von 201 Frames bei 480p auf einer einzelnen H100-GPU mehrere Minuten dauern, während die Zeit in Multi-GPU-Konfigurationen signifikant reduziert wird. Die Kosten müssen GPU, Speicher, Speicherung und Betrieb einplanen, da kostenlose Gewichte die Rechenkosten nicht eliminieren.
Die Abhängigkeit von NVIDIA-GPU-Hardware, insbesondere von den Architekturen Blackwell und Hopper, stellt eine erhebliche Hürde für die breite Adoption dar. Diese GPUs sind teuer und in begrenzter Verfügbarkeit, was die Kosten für die Infrastruktur erheblich erhöht. Die Notwendigkeit, eigene Hardware zu betreiben, bedeutet auch, dass Teams über die technischen Fähigkeiten verfügen müssen, um die Umgebung zu konfigurieren und zu warten. Die Lizenz OpenMDW-1.1 erlaubt zwar die kommerzielle Nutzung, beseitigt aber nicht die hohen initialen Investitionskosten für die Hardware. Dies macht das Modell vor allem für Organisationen mit bestehenden GPU-Clustern oder für Forschungseinrichtungen mit Zugang zu Rechenzentren attraktiv.
Die Variabilität der Leistung je nach Auflösung und Frame-Anzahl erfordert eine sorgfältige Planung der Ressourcen. Die Generierung von langen Videosequenzen in hoher Auflösung kann erhebliche Rechenzeit in Anspruch nehmen, was die Durchsatzrate der Datenerstellung begrenzt. Multi-GPU-Konfigurationen können diese Zeit reduzieren, erfordern aber eine komplexe Orchestrierung und zusätzliche Hardware. Die Kosten für Speicher und Betrieb müssen ebenfalls berücksichtigt werden, da die generierten Videodateien schnell große Datenmengen erzeugen können. Eine genaue Kalkulation dieser Faktoren ist entscheidend, um die Wirtschaftlichkeit des Einsatzes des Modells sicherzustellen.
Prozess des lokalen Deployments
Grundlegende Schritte zur Ausführung des Modells auf eigener Infrastruktur.
- 01Gewichte von Hugging Face herunterladen (nvidia/Cosmos3-Nano-Sim-Transfer).
- 02Eine Umgebung mit PyTorch und vLLM-Omni einrichten, die mit NVIDIA-GPUs kompatibel ist.
- 03Den Inferenzserver starten und die geeignete Pipeline-Klasse angeben.
- 04Anfragen mit Simulationssteuerungen (Tiefe, Segmentierung) und Text-Prompts senden.
- 05Die Base64-Antwort in eine MP4-Datei decodieren, um sie weiterzuverwenden.
Einschränkungen, Sicherheit und Alternativen
Die Hauptbeschränkung ist das Fehlen einer garantierten physikalischen Genauigkeit. Die Generierung kann zeitliche Inkonsistenzen, instabile Bewegung oder ungenaue physikalische Interaktionen aufweisen. NVIDIA warnt ausdrücklich, dass das Modell nicht für sicherheitskritische Anwendungen konzipiert ist, bei denen ein Fehler Verletzungen oder katastrophale Schäden verursachen könnte. Es erfordert unabhängige Validierung und systemweite Sicherheitsanalysen.
Was die Sicherheit betrifft, werden Medieneingaben einem obligatorischen Screening auf Material sexuellen Kindesmissbrauchs (CSAM) und anderen Inhalts-Schutzmaßnahmen unterzogen. Visuelle Ausgaben tragen ein SynthID-Wasserzeichen, während numerische Aktionsarrays jedoch nicht visuell markiert sind. Als Alternative spezialisiert sich die Variante Cosmos3-Nano-Transfer-Auto auf autonomes Fahren mit LiDAR, während Sim-Transfer sich auf allgemeine Robotik- und Industriesimulation konzentriert.
Die Sicherheitsmaßnahmen, einschließlich des CSAM-Screenings und des SynthID-Wasserzeichens, sind wichtige Bestandteile der verantwortungsvollen Nutzung des Modells. Das Screening dient dazu, die Verbreitung schädlicher Inhalte zu verhindern, während das Wasserzeichen die Herkunft der synthetischen Daten kennzeichnet. Dies ist besonders wichtig in einem Umfeld, in dem die Unterscheidung zwischen realen und generierten Inhalten zunehmend schwierig wird. Die Tatsache, dass numerische Aktionsarrays nicht visuell markiert sind, unterstreicht die Notwendigkeit, die Metadaten und die Provenienz der Daten sorgfältig zu verwalten. Nutzer müssen sicherstellen, dass sie die Richtlinien für die Verwendung synthetischer Daten in ihren eigenen Anwendungen einhalten.
Die Warnung vor der Verwendung in sicherheitskritischen Anwendungen ist ein zentraler Aspekt der Dokumentation. Die mangelnde Garantie für physikalische Genauigkeit bedeutet, dass Fehler in der Simulation zu falschen Entscheidungen in autonomen Systemen führen können. Dies erfordert eine umfassende Validierung und die Implementierung von Sicherheitsmechanismen, die unabhängig vom Modell funktionieren. Die Alternative, die Transfer-Auto-Variante, ist für spezifische Anwendungsfälle wie autonomes Fahren mit LiDAR optimiert, was die Notwendigkeit der Auswahl des richtigen Modells für den jeweiligen Zweck hervorhebt. Eine sorgfältige Bewertung der Einschränkungen und der Sicherheitsanforderungen ist unerlässlich, um Risiken zu minimieren.
Praktische Kriterien für die Modellwahl
Die Entscheidung, Cosmos3-Nano-Sim-Transfer zu verwenden, hängt davon ab, ob große Mengen synthetischer visueller Daten zur Schulung von Wahrnehmungsmodellen benötigt werden und ob die erforderliche GPU-Infrastruktur vorhanden ist. Wenn das Ziel die Simulation präziser Physik für Echtzeitsteuerung ist, ist dieses Modell nicht geeignet; es sollte als visuelle Ergänzung zu einem klassischen physikalischen Simulator verwendet werden.
Für Teams mit begrenzten Ressourcen könnte die Edge-Variante (4B) praktikabler sein, albeit mit geringerer Qualität. Für Anwendungen im autonomen Fahren mit LiDAR-Sensoren ist die Transfer-Auto-Variante spezifischer. Die Wahl sollte auf dem Gleichgewicht zwischen visueller Qualität, Rechenkosten und dem Bedarf an physikalischer Kohärenz basieren, wobei immer die menschliche und technische Validierung der Ergebnisse aufrechterhalten werden muss.
Die Entscheidung für Cosmos3-Nano-Sim-Transfer sollte auf einer gründlichen Analyse der spezifischen Anforderungen des Projekts basieren. Wenn das Hauptziel die Erstellung großer Mengen synthetischer visueller Daten für das Training von Computer-Vision-Modellen ist, bietet das Modell einen wertvollen Vorteil durch seine Fähigkeit, realistische Videos aus strukturierten Eingaben zu generieren. Die Verfügbarkeit der Gewichte und der Code unter einer offenen Lizenz erleichtert die Integration in bestehende Workflows. Allerdings muss die Infrastruktur für die Inferenz vorhanden sein, was die Kosten und die technische Komplexität erhöht. Für Teams ohne Zugang zu Hochleistungs-GPUs könnte die Nutzung von Cloud-Diensten oder die Verwendung der kleineren Edge-Variante eine praktikablere Alternative sein.
Die Abwägung zwischen visueller Qualität, Rechenkosten und physikalischer Kohärenz ist ein kontinuierlicher Prozess, der an die sich entwickelnden Anforderungen angepasst werden muss. Die menschliche und technische Validierung der Ergebnisse bleibt ein unverzichtbarer Schritt, um die Zuverlässigkeit der synthetischen Daten sicherzustellen. Die Wahl des richtigen Modells innerhalb der Cosmos3-Familie, sei es Nano, Edge oder Super, hängt von den verfügbaren Ressourcen und den spezifischen Zielen des Projekts ab. Eine klare Definition der Anforderungen und eine realistische Einschätzung der Infrastrukturkosten sind entscheidend für den erfolgreichen Einsatz des Modells in der Praxis.
Entscheidungstabelle: Wann Sim-Transfer verwenden?
Schnelle Anleitung zur Bestimmung der Eignung des Modells anhand des Anwendungsfalls.
| Anwendungsfall | Eignung | Grund |
|---|---|---|
| Generierung synthetischer Daten für das Training von Computer Vision | Hoch | Erzeugt realistisches RGB-Video aus strukturierten Steuerungen. |
| Präzise physikalische Simulation für Robotiksteuerung | Niedrig | Kein Physik-Engine; physikalische Genauigkeit ist nicht garantiert. |
| Autonomes Fahren mit LiDAR | Mittel/Niedrig | Transfer-Auto für LiDAR verwenden; Sim-Transfer ist allgemeiner. |
| Deployment auf CPU oder kostengünstiger GPU | Niedrig | Erfordert leistungsstarke NVIDIA-GPUs (Hopper/Blackwell). |
Offene Fragen
- Eine direkte API-Gebühr von NVIDIA für diesen spezifischen Checkpoint wurde nicht verifiziert; die Kosten liegen bei der eigenen Infrastruktur.
- Die PAI-Bench-C-Benchmarks stammen vom Anbieter und wurden nicht unabhängig repliziert.
- Die genaue Leistung auf spezifischer Hardware kann je nach Parallelisierungseinstellung und Systemlast variieren.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen