Cosa fa esattamente Cosmos3-Nano-Sim-Transfer
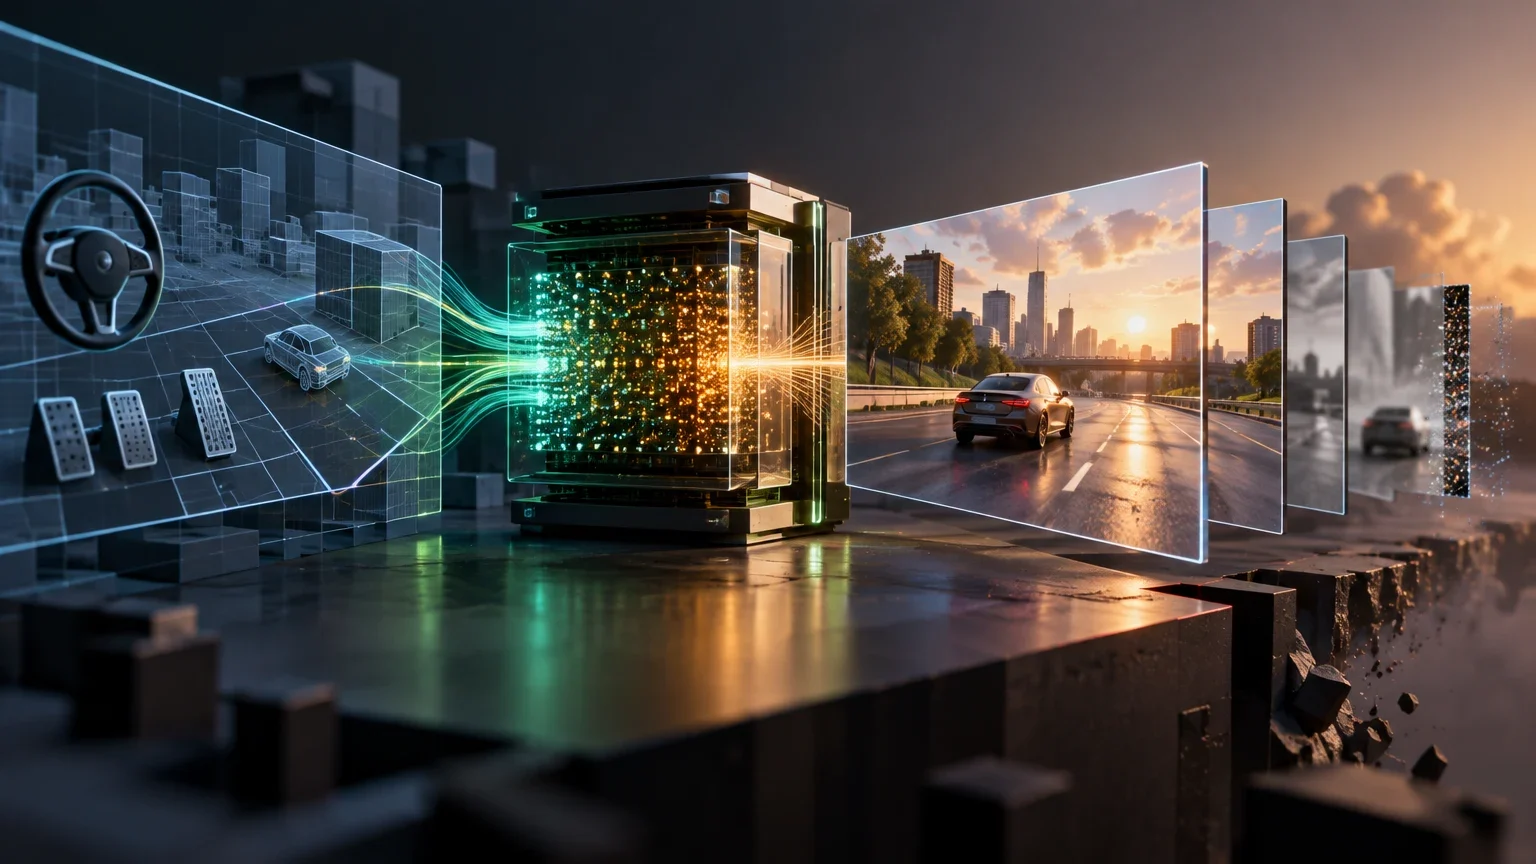
Cosmos3-Nano-Sim-Transfer è un modello di fondazione per l'IA fisica sviluppato da NVIDIA, pubblicato il 20 ottobre 2026. La sua funzione principale non è simulare la fisica del mondo, ma generare l'aspetto visivo (video RGB) a partire da controlli strutturali forniti da un simulatore classico. Accetta input di testo e controlli visivi come mappe di profondità, segmentazione, bordi o sfocatura, e produce sequenze video che imitano l'aspetto fotografico della scena simulata.
È cruciale distinguere questo modello da un motore fisico: la geometria, la permanenza degli oggetti e le leggi fisiche restano di responsabilità del simulatore tradizionale. La rete neurale apporta lo strato visivo. Pertanto, non è una policy che genera azioni per robot né uno strumento di certificazione di sicurezza, ma un generatore di dati sintetici visivi per addestrare e valutare modelli di percezione.
La distinzione tra simulazione fisica e generazione visiva è fondamentale per comprendere il ruolo di Cosmos3-Nano-Sim-Transfer nei flussi di lavoro di addestramento. Il simulatore classico fornisce la 'ground truth' strutturale, definendo la posizione esatta degli oggetti, le loro interazioni e la dinamica temporale secondo leggi fisiche deterministiche. Il modello di IA, invece, opera come un traduttore di dominio, trasformando questi dati astratti e strutturati in rappresentazioni fotorealistiche. Questo processo è essenziale perché i modelli di percezione, come le reti neurali convoluzionali o i transformer per la visione, sono tipicamente addestrati su dati visivi grezzi e non su mappe di profondità o etichette di segmentazione. Senza questo passaggio di trasferimento, i modelli di percezione non sarebbero in grado di generalizzare correttamente quando applicati a scenari reali, dove l'input è sempre un'immagine o un video RGB. La capacità di generare video che imitano l'aspetto fotografico permette di creare dataset sintetici su larga scala, coprendo scenari rari o pericolosi che sarebbero difficili o costosi da acquisire nel mondo reale, mantenendo al contempo la coerenza strutturale imposta dal simulatore sottostante.
Architettura e modalità di input e output
Il modello utilizza un'architettura Transformer con Mixture-of-Transformers (MoT), una tecnica che consente di gestire più modalità in modo efficiente. La variante Nano conta 16 miliardi di parametri addestrabili, posizionandosi tra la versione Edge (4B) e la Super (64B) della famiglia Cosmos3.
Le modalità di input includono testo (prompt di descrizione), video (controlli di trasferimento o riferimenti) e parametri di azione in determinate modalità. L'output principale è un video in formato MP4 con traccia VP9. Per la variante Sim-Transfer, i controlli tipici sono mappe di profondità, segmentazione semantica, bordi e sfocatura, che guidano la generazione visiva mantenendo la coerenza con la struttura fisica sottostante.
L'architettura Mixture-of-Transformers (MoT) rappresenta un approccio avanzato per gestire la complessità computazionale associata alla fusione di multiple modalità di input. A differenza dei transformer standard che trattano tutte le token in modo uniforme, la MoT consente di specializzare sottogruppi di parametri per diverse modalità, come testo, video o parametri di azione, migliorando l'efficienza dell'addestramento e dell'inferenza. Questa specializzazione è cruciale per un modello come Cosmos3-Nano, che deve integrare prompt testuali descrittivi con controlli visivi strutturati come mappe di profondità e segmentazione. La variante Nano, con i suoi 16 miliardi di parametri, è progettata per bilanciare la capacità di rappresentazione e il costo computazionale, posizionandosi strategicamente nella famiglia Cosmos3. Questa dimensione consente di ottenere una qualità visiva superiore rispetto alla versione Edge (4B), che potrebbe soffrire di artefatti o incoerenze in scenari complessi, pur rimanendo più gestibile in termini di requisiti di memoria rispetto alla versione Super (64B). L'uso di questa architettura permette di mantenere la coerenza temporale e spaziale nel video generato, un aspetto critico quando si lavora con sequenze di fotogrammi che devono riflettere accuratamente la dinamica fisica sottostante.
Modalità e parametri chiave di Cosmos3-Nano
Riepilogo delle capacità di input e output secondo la documentazione ufficiale di NVIDIA.
| Componente | Dettaglio |
|---|---|
| Architettura | Transformer MoT (Mixture-of-Transformers) |
| Parametri | 16B (Nano) |
| Input | Testo, Video (controlli), Parametri di azione |
| Output | Video MP4 (VP9), Immagine JPEG |
| Risoluzioni | 256p, 480p, 720p (aspetti 16:9, 1:1, ecc.) |
Benchmark pubblicati e metodologia di valutazione
NVIDIA pubblica risultati nel benchmark PAI-Bench-C, specificamente nella sezione TransferBench. È importante sottolineare che questi dati provengono dal fornitore e non sono stati replicati in modo indipendente da Inferama né da terzi verificati al momento di questa analisi. Le metriche includono DOVER (qualità tecnica del video), mIoU (segmentazione) e SI-RMSE (errore di profondità).
I valori pubblicati per questo checkpoint specifico sono: DOVER di 10,175942, mIoU di segmentazione di 0,73776 e SI-RMSE di profondità di 0,619426. Queste metriche misurano la fedeltà visiva e la coerenza con i controlli di input, ma non garantiscono l'accuratezza fisica della simulazione. Un alto DOVER indica un video visivamente pulito, non che gli oggetti si muovano secondo le leggi di Newton.
La metodologia di valutazione basata su PAI-Bench-C e la sezione TransferBench offre uno sguardo dettagliato su come viene misurata la qualità del trasferimento visivo. La metrica DOVER (Deep Video Quality Evaluator) si concentra sulla qualità tecnica del video, valutando aspetti come la nitidezza, la luminosità e l'assenza di artefatti di compressione o generazione. Un valore elevato di DOVER indica che il video generato è visivamente pulito e gradevole, ma non fornisce alcuna garanzia sulla correttezza fisica del contenuto. Ad esempio, un oggetto potrebbe apparire nitido e ben definito, ma muoversi in modo non realistico o violare le leggi della gravità. La metrica mIoU (mean Intersection over Union) misura la precisione della segmentazione semantica, verificando quanto bene il modello riesce a mantenere le etichette degli oggetti coerenti con l'input di segmentazione fornito. Un alto mIoU suggerisce che il modello non 'allucina' oggetti o non confonde le categorie semantiche, il che è fondamentale per l'addestramento di modelli di percezione che dipendono da etichette accurate. Infine, la SI-RMSE (Scale-Invariant Root Mean Square Error) valuta l'errore nella ricostruzione della profondità, misurando quanto la mappa di profondità generata si discosti da quella di riferimento. Un valore basso indica una buona preservazione della struttura spaziale, ma, ancora una volta, non garantisce che la dinamica degli oggetti sia fisicamente corretta. Queste metriche, prese singolarmente o in combinazione, forniscono un quadro della fedeltà visiva e strutturale, ma devono essere interpretate con cautela, ricordando che il modello non è un motore fisico.
Metriche di TransferBench (PAI-Bench-C)
Valori pubblicati da NVIDIA per Cosmos3-Nano-Sim-Transfer. Più basso è meglio per SI-RMSE; più alto è meglio per DOVER e mIoU.
| Metrica | Valore | Interpretazione |
|---|---|---|
| DOVER | 10,175942 | Qualità tecnica del video generato |
| Segmentation mIoU | 0,73776 | Precisione della segmentazione semantica |
| Depth SI-RMSE | 0,619426 | Errore di ricostruzione della profondità |
Requisiti di deployment e costi infrastrutturali
Il modello è distribuito sotto la licenza OpenMDW-1.1, che ne consente l'uso commerciale e non commerciale, a condizione che vengano rispettati i termini della licenza. I pesi sono pubblicamente disponibili su Hugging Face e il codice su GitHub. Tuttavia, non esiste una tariffa API diretta pubblicata da NVIDIA per questo checkpoint specifico nelle fonti primarie verificate; il costo ricade sull'infrastruttura propria dell'utente.
Per l'inferenza, è richiesto hardware GPU di NVIDIA, specificamente architetture Blackwell (GB200) o Hopper (H100, H200, H20). Le prestazioni variano drasticamente a seconda della risoluzione, del numero di fotogrammi e del parallelismo. Ad esempio, generare 201 fotogrammi a 480p su una singola GPU H100 può richiedere diversi minuti, mentre in configurazioni multi-GPU il tempo si riduce significativamente. Il costo deve prevedere GPU, memoria, archiviazione e operazioni, poiché i pesi gratuiti non eliminano il costo computazionale.
I requisiti infrastrutturali per il deployment di Cosmos3-Nano-Sim-Transfer riflettono la complessità computazionale intrinseca dei modelli di fondazione per l'IA fisica. La necessità di GPU NVIDIA di fascia alta, come le architetture Hopper (H100, H200, H20) o Blackwell (GB200), è dettata dalla quantità di memoria e dalla potenza di calcolo richiesta per gestire i 16 miliardi di parametri e le operazioni di inferenza su video ad alta risoluzione. La licenza OpenMDW-1.1, sebbene permetta l'uso commerciale e non commerciale, non elimina i costi associati all'infrastruttura. Gli utenti devono considerare non solo il costo delle GPU, ma anche la memoria di sistema, l'archiviazione dei pesi e dei dati di input/output, e i costi operativi per l'energia e il raffreddamento. La disponibilità dei pesi su Hugging Face e del codice su GitHub facilita l'accesso, ma richiede competenze tecniche avanzate per la configurazione dell'ambiente, inclusa la gestione delle dipendenze come PyTorch e vLLM-Omni. Inoltre, l'assenza di una tariffa API diretta significa che gli utenti devono gestire l'intero ciclo di vita del deployment, dalla configurazione iniziale alla manutenzione continua. Questo approccio è adatto a organizzazioni con risorse IT dedicate e competenze in machine learning, ma potrebbe essere proibitivo per team più piccoli o per progetti con budget limitati. La variabilità delle prestazioni in base alla risoluzione, al numero di fotogrammi e al parallelismo richiede una pianificazione attenta per ottimizzare il rapporto tra costo e qualità del video generato.
Processo di deployment locale
Passaggi base per eseguire il modello su infrastruttura propria.
- 01Scaricare i pesi da Hugging Face (nvidia/Cosmos3-Nano-Sim-Transfer).
- 02Configurare un ambiente con PyTorch e vLLM-Omni compatibile con GPU NVIDIA.
- 03Avviare il server di inferenza specificando la classe di pipeline appropriata.
- 04Inviare richieste con controlli di simulazione (profondità, segmentazione) e prompt di testo.
- 05Decodificare la risposta base64 in un file MP4 per l'uso successivo.
Limitazioni, sicurezza e alternative
La principale limitazione è la mancanza di accuratezza fisica garantita. La generazione può presentare incoerenze temporali, movimento instabile o interazioni fisiche imprecise. NVIDIA avverte esplicitamente che il modello non è progettato per applicazioni critiche per la sicurezza in cui il fallimento potrebbe causare lesioni o danni catastrofici. Richiede validazione indipendente e analisi di sicurezza a livello di sistema.
Per quanto riguarda la sicurezza, gli input multimediali sono sottoposti a screening obbligatorio per materiale di abuso sessuale infantile (CSAM) e altre salvaguardie di contenuto. Gli output visivi portano un watermark SynthID, sebbene gli array di azione numerici non siano marcati visivamente. Come alternativa, la variante Cosmos3-Nano-Transfer-Auto si specializza nella guida autonoma con LiDAR, mentre Sim-Transfer si concentra sulla simulazione generale di robotica e industriale.
Le limitazioni legate all'accuratezza fisica e alla sicurezza sono aspetti critici da considerare quando si integra Cosmos3-Nano-Sim-Transfer in pipeline di addestramento o valutazione. La generazione di video può presentare incoerenze temporali, dove gli oggetti cambiano forma o posizione in modo non realistico tra un fotogramma e l'altro, o movimento instabile che non rispetta le leggi della fisica. Queste incoerenze possono introdurre rumore nei dati sintetici, compromettendo la qualità dell'addestramento dei modelli di percezione. NVIDIA avverte esplicitamente che il modello non è progettato per applicazioni critiche per la sicurezza, come il controllo diretto di robot o veicoli autonomi, dove un errore potrebbe avere conseguenze gravi. L'uso del modello in tali contesti richiederebbe una validazione indipendente rigorosa e un'analisi di sicurezza a livello di sistema, oltre a meccanismi di fallback e monitoraggio continuo. In termini di sicurezza dei contenuti, lo screening obbligatorio per materiale di abuso sessuale infantile (CSAM) e altre salvaguardie di contenuto è un requisito fondamentale per garantire un uso responsabile del modello. Il watermark SynthID applicato agli output visivi aiuta a tracciare l'origine dei contenuti generati, riducendo il rischio di uso improprio o di diffusione di contenuti falsi. Tuttavia, gli array di azione numerici non sono marcati visivamente, il che potrebbe richiedere ulteriori misure di sicurezza per garantire la tracciabilità di questi dati. La variante Transfer-Auto, specializzata nella guida autonoma con LiDAR, offre un'alternativa più specifica per quel dominio, mentre Sim-Transfer rimane una scelta più generalista per la simulazione di robotica e industriale.
Criteri pratici per la scelta del modello
La decisione di utilizzare Cosmos3-Nano-Sim-Transfer dipende dalla necessità di generare dati sintetici visivi su larga scala per addestrare modelli di percezione e dalla disponibilità dell'infrastruttura GPU necessaria. Se l'obiettivo è simulare fisica precisa per il controllo in tempo reale, questo modello non è adatto; deve essere usato come complemento visivo a un simulatore fisico classico.
Per team con risorse limitate, la variante Edge (4B) potrebbe essere più fattibile, sebbene con qualità inferiore. Per applicazioni di guida autonoma con sensori LiDAR, la variante Transfer-Auto è più specifica. La scelta deve basarsi sul bilanciamento tra qualità visiva, costo computazionale e necessità di coerenza fisica, mantenendo sempre la validazione umana e tecnica dei risultati.
La scelta di Cosmos3-Nano-Sim-Transfer deve essere guidata da una valutazione attenta dei requisiti specifici del progetto e delle risorse disponibili. Per team che necessitano di generare grandi quantità di dati sintetici visivi per addestrare modelli di percezione, questo modello offre un vantaggio significativo in termini di scala e varietà, permettendo di coprire scenari complessi e rari. Tuttavia, la disponibilità dell'infrastruttura GPU di fascia alta è un prerequisito fondamentale, e i costi associati devono essere bilanciati con i benefici attesi. Se l'obiettivo è simulare fisica precisa per il controllo in tempo reale, questo modello non è adatto, poiché non garantisce l'accuratezza fisica e potrebbe introdurre incoerenze che comprometterebbero la stabilità del sistema. In tali casi, è preferibile utilizzare un simulatore fisico classico, eventualmente integrato con un generatore visivo per migliorare la realistica dei dati di addestramento. Per team con risorse limitate, la variante Edge (4B) potrebbe essere un'opzione più fattibile, sebbene con una qualità visiva inferiore e una capacità di generalizzazione ridotta. Per applicazioni di guida autonoma con sensori LiDAR, la variante Transfer-Auto è più specifica e ottimizzata per quel dominio, offrendo una migliore coerenza con i dati LiDAR. La decisione finale deve basarsi su un bilanciamento tra qualità visiva, costo computazionale e necessità di coerenza fisica, mantenendo sempre una validazione umana e tecnica dei risultati per garantire l'affidabilità e la sicurezza dei dati generati.
Tabella di decisione: Quando usare Sim-Transfer?
Guida rapida per determinare l'idoneità del modello in base al caso d'uso.
| Caso d'uso | Idoneità | Motivo |
|---|---|---|
| Generare dati sintetici per addestrare la computer vision | Alta | Genera video RGB realistici a partire da controlli strutturali. |
| Simulazione fisica precisa per il controllo di robot | Bassa | Non è un motore fisico; l'accuratezza fisica non è garantita. |
| Guida autonoma con LiDAR | Media/Bassa | Usare Transfer-Auto per LiDAR; Sim-Transfer è più generalista. |
| Deployment su CPU o GPU a basso costo | Bassa | Richiede GPU NVIDIA ad alte prestazioni (Hopper/Blackwell). |
Questioni aperte
- Non è stata verificata una tariffa API diretta di NVIDIA per questo checkpoint specifico; i costi sono di infrastruttura propria.
- I benchmark di PAI-Bench-C sono del fornitore e non sono stati replicati in modo indipendente.
- Le prestazioni esatte su hardware specifico non fornito dall'utente possono variare a seconda della configurazione di parallelismo e del carico del sistema.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione