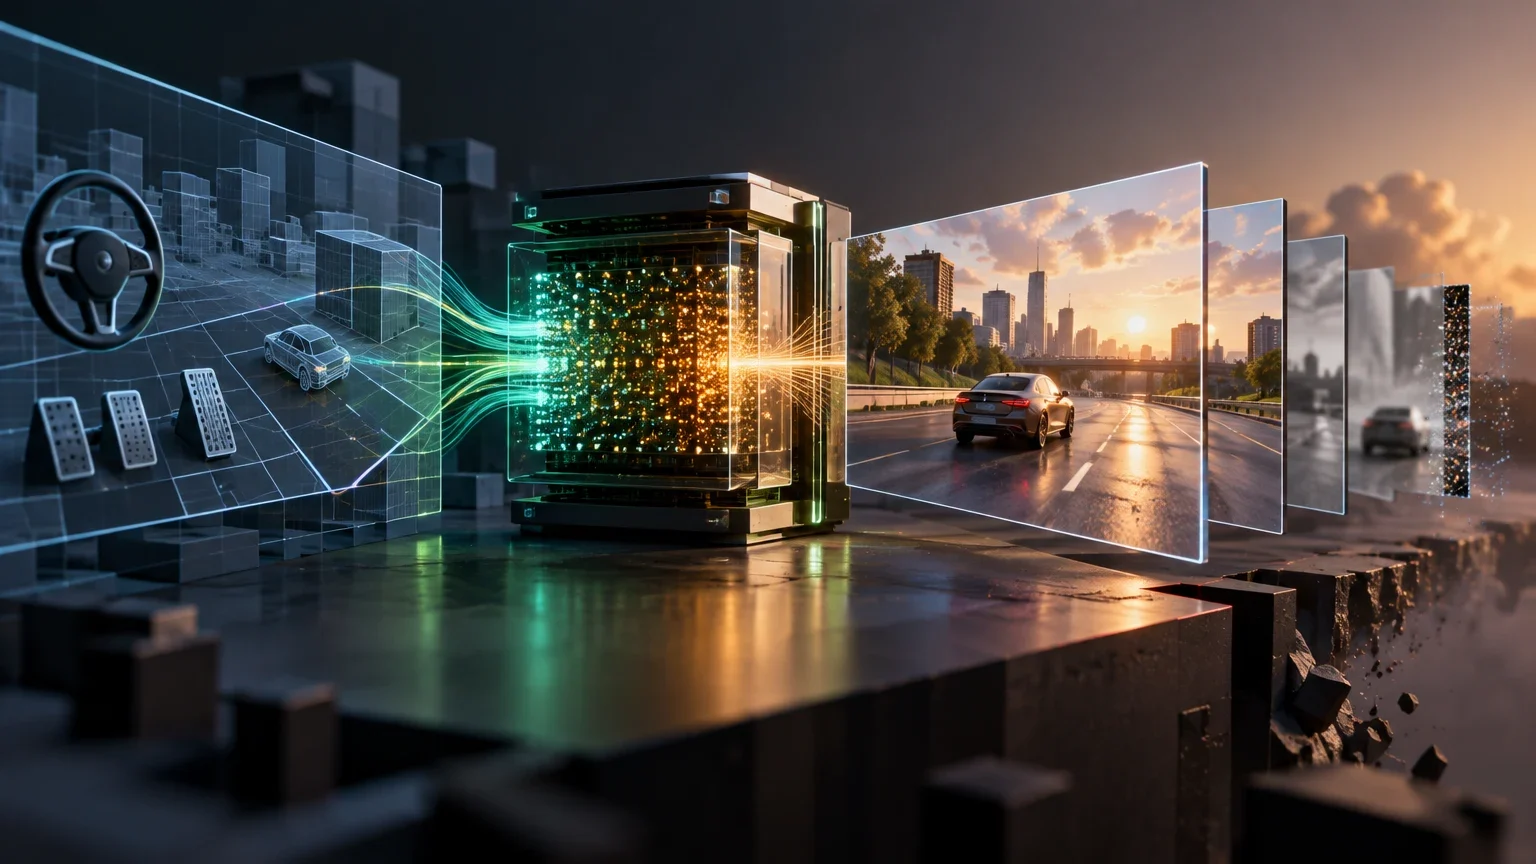
O que o Cosmos3-Nano-Sim-Transfer faz exatamente
O Cosmos3-Nano-Sim-Transfer é um modelo de fundação para IA física desenvolvido pela NVIDIA, publicado em 20 de outubro de 2026. Sua função principal não é simular a física do mundo, mas gerar aparência visual (vídeo RGB) a partir de controles estruturais fornecidos por um simulador clássico. Aceita entradas de texto e controles visuais como mapas de profundidade, segmentação, bordas ou desfoque, e produz sequências de vídeo que imitam a aparência fotográfica da cena simulada.
É crucial distinguir este modelo de um motor de física: a geometria, a permanência de objetos e as leis físicas continuam sendo responsabilidade do simulador tradicional. A rede neural fornece a camada visual. Portanto, não é uma política que gera ações para robôs nem uma ferramenta de certificação de segurança, mas um gerador de dados sintéticos visuais para treinar e avaliar modelos de percepção.
A distinção entre a camada de simulação física e a camada de geração visual é fundamental para compreender o escopo de aplicação do Cosmos3-Nano-Sim-Transfer. Enquanto o simulador clássico garante que a geometria dos objetos e as leis de movimento permaneçam consistentes ao longo do tempo, a rede neural atua exclusivamente na tradução desses dados estruturais em pixels fotorealistas. Isso significa que a integridade da cena depende inteiramente da precisão do simulador de origem, e não da capacidade do modelo de IA de inferir a física ausente. A função do modelo é, portanto, puramente estética e perceptual, servindo para enriquecer a saída visual sem alterar a dinâmica subjacente.
Ao operar como um gerador de dados sintéticos, o modelo permite que equipes de pesquisa e desenvolvimento criem grandes volumes de vídeos com variações visuais controladas, mantendo a coerência com os parâmetros de entrada. Essa abordagem é particularmente útil para treinar modelos de percepção que precisam generalizar para diferentes condições de iluminação, texturas e ângulos de câmera, sem a necessidade de capturar dados reais em cada cenário. A separação clara entre a lógica física e a aparência visual facilita a iteração rápida de cenários, pois alterações na aparência podem ser feitas sem recalcular a física complexa da simulação.
Arquitetura e modalidades de entrada e saída
O modelo utiliza uma arquitetura Transformer com Mixture-of-Transformers (MoT), uma técnica que permite lidar com múltiplas modalidades de forma eficiente. A variante Nano possui 16 bilhões de parâmetros treináveis, situando-se entre a versão Edge (4B) e a Super (64B) da família Cosmos3.
As modalidades de entrada incluem texto (prompts de descrição), vídeo (controles de transferência ou referências) e parâmetros de ação em certos modos. A saída principal é vídeo em formato MP4 com pista VP9. Para a variante Sim-Transfer, os controles típicos são mapas de profundidade, segmentação semântica, bordas e desfoque, que guiam a geração visual mantendo a coerência com a estrutura física subjacente.
A arquitetura Mixture-of-Transformers (MoT) é projetada para processar eficientemente a combinação de diferentes tipos de dados, como texto, vídeo e parâmetros numéricos, dentro de um único framework. Essa capacidade multimodal é essencial para o funcionamento do Sim-Transfer, que precisa integrar prompts descritivos com controles visuais estruturados para produzir uma saída coerente. A variante Nano, com seus 16 bilhões de parâmetros, representa um ponto de equilíbrio na família Cosmos3, oferecendo uma capacidade de processamento significativa sem os requisitos computacionais extremos das versões maiores, o que a torna mais acessível para implementações em escala média.
Os controles de entrada, como mapas de profundidade e segmentação semântica, funcionam como guias rígidos para a geração do vídeo, garantindo que a estrutura espacial da cena seja preservada. O desfoque e as bordas adicionais permitem ajustar a nitidez e os contornos dos objetos, oferecendo flexibilidade para simular diferentes condições de captura de imagem. A saída em formato MP4 com pista VP9 é otimizada para a distribuição e o processamento posterior, facilitando a integração em pipelines de treinamento de modelos de visão computacional que exigem arquivos de vídeo padronizados e de alta qualidade.
Modalidades e parâmetros-chave do Cosmos3-Nano
Resumo das capacidades de entrada e saída conforme a documentação oficial da NVIDIA.
| Componente | Detalhe |
|---|---|
| Arquitetura | Transformer MoT (Mixture-of-Transformers) |
| Parâmetros | 16B (Nano) |
| Entradas | Texto, Vídeo (controles), Parâmetros de ação |
| Saída | Vídeo MP4 (VP9), Imagem JPEG |
| Resoluções | 256p, 480p, 720p (aspectos 16:9, 1:1, etc.) |
Benchmarks publicados e metodologia de avaliação
A NVIDIA publica resultados no benchmark PAI-Bench-C, especificamente na seção TransferBench. É importante notar que esses dados provêm do fornecedor e não foram replicados de forma independente pela Inferama nem por terceiros verificados no momento desta análise. As métricas incluem DOVER (qualidade técnica de vídeo), mIoU (segmentação) e SI-RMSE (erro de profundidade).
Os valores publicados para este checkpoint específico são: DOVER de 10,175942, mIoU de segmentação de 0,73776 e SI-RMSE de profundidade de 0,619426. Essas métricas medem a fidelidade visual e a coerência com os controles de entrada, mas não garantem a precisão física da simulação. Um alto DOVER indica um vídeo visualmente limpo, não que os objetos se movam de acordo com as leis de Newton.
A metodologia de avaliação baseada no PAI-Bench-C foca em métricas que quantificam a qualidade técnica e a fidelidade estrutural do vídeo gerado. O DOVER avalia a nitidez e a ausência de artefatos visuais, enquanto o mIoU mede a precisão com que a segmentação semântica é mantida na saída. O SI-RMSE, por sua vez, verifica o erro na reconstrução da profundidade, indicando quão bem o modelo respeita a estrutura tridimensional fornecida como entrada. É fundamental interpretar esses valores como indicadores de desempenho visual e estrutural, e não como validação da precisão física dos movimentos ou interações representados no vídeo.
A natureza dos dados publicados pelo fornecedor exige cautela ao utilizá-los para comparações diretas com outros modelos ou para decisões críticas de projeto. Como não houve replicação independente por terceiros, os valores devem ser considerados como referência inicial, sujeitos a variação conforme a configuração específica do hardware e os parâmetros de inferência utilizados. A análise crítica desses benchmarks deve sempre considerar o contexto de aplicação, reconhecendo que a alta pontuação em métricas visuais não elimina a necessidade de validação física separada para aplicações que dependam de precisão dinâmica.
Métricas do TransferBench (PAI-Bench-C)
Valores publicados pela NVIDIA para o Cosmos3-Nano-Sim-Transfer. Menor é melhor para SI-RMSE; maior é melhor para DOVER e mIoU.
| Métrica | Valor | Interpretação |
|---|---|---|
| DOVER | 10,175942 | Qualidade técnica do vídeo gerado |
| Segmentation mIoU | 0,73776 | Precisão da segmentação semântica |
| Depth SI-RMSE | 0,619426 | Erro de reconstrução de profundidade |
Requisitos de implantação e custo de infraestrutura
O modelo é distribuído sob a licença OpenMDW-1.1, o que permite seu uso comercial e não comercial, desde que os termos da licença sejam cumpridos. Os pesos estão disponíveis publicamente no Hugging Face e o código no GitHub. No entanto, não existe uma tarifa de API direta publicada pela NVIDIA para este checkpoint específico nas fontes primárias verificadas; o custo recai sobre a infraestrutura própria do usuário.
Para a inferência, é necessário hardware GPU da NVIDIA, especificamente arquiteturas Blackwell (GB200) ou Hopper (H100, H200, H20). O desempenho varia drasticamente conforme a resolução, o número de quadros e o paralelismo. Por exemplo, gerar 201 quadros a 480p em uma única GPU H100 pode levar vários minutos, enquanto em configurações multi-GPU o tempo é significativamente reduzido. O custo deve prever GPU, memória, armazenamento e operação, pois os pesos gratuitos não eliminam o custo computacional.
A disponibilidade dos pesos sob a licença OpenMDW-1.1 facilita o acesso e a experimentação, mas impõe a responsabilidade total pela infraestrutura de computação ao usuário. A ausência de uma tarifa de API direta significa que o custo de operação é diretamente proporcional ao consumo de energia e à capacidade de processamento das GPUs utilizadas. Para equipes que não possuem acesso a hardware de alto desempenho, como as arquiteturas Blackwell ou Hopper, a implantação local pode se tornar um obstáculo significativo, exigindo investimentos substanciais em equipamentos ou a utilização de serviços de nuvem especializados.
O processo de implantação local requer uma configuração cuidadosa do ambiente de software, incluindo a compatibilidade entre o PyTorch e o vLLM-Omni com as GPUs disponíveis. A decodificação da resposta base64 em arquivos MP4 é um passo essencial para a utilização prática dos dados gerados, mas o tempo de processamento pode variar consideravelmente dependendo da resolução e do número de quadros solicitados. O planejamento financeiro deve incluir não apenas o custo das GPUs, mas também a memória de armazenamento para os grandes volumes de dados sintéticos gerados e a manutenção do sistema de inferência.
Processo de implantação local
Passos básicos para executar o modelo em infraestrutura própria.
- 01Baixar os pesos do Hugging Face (nvidia/Cosmos3-Nano-Sim-Transfer).
- 02Configurar um ambiente com PyTorch e vLLM-Omni compatível com GPU NVIDIA.
- 03Iniciar o servidor de inferência especificando a classe de pipeline adequada.
- 04Enviar requisições com controles de simulação (profundidade, segmentação) e prompts de texto.
- 05Decodificar a resposta base64 em um arquivo MP4 para uso posterior.
Limitações, segurança e alternativas
A principal limitação é a falta de precisão física garantida. A geração pode apresentar inconsistências temporais, movimento instável ou interações físicas imprecisas. A NVIDIA adverte explicitamente que o modelo não foi projetado para aplicações críticas de segurança onde a falha poderia causar lesões ou danos catastróficos. Requer validação independente e análise de segurança em nível de sistema.
Em termos de segurança, as mídias de entrada são submetidas a uma triagem obrigatória de material de abuso sexual infantil (CSAM) e outras salvaguardas de conteúdo. As saídas visuais carregam uma marca d'água SynthID, embora os arrays de ação numéricos não estejam marcados visualmente. Como alternativa, a variante Cosmos3-Nano-Transfer-Auto se especializa em direção autônoma com LiDAR, enquanto o Sim-Transfer se concentra em simulação geral de robótica e industrial.
As limitações físicas do modelo são intrínsecas à sua arquitetura, que prioriza a geração visual sobre a simulação dinâmica. Inconsistências temporais e movimentos instáveis podem ocorrer, especialmente em cenas complexas com múltiplos objetos interagentes, o que reforça a necessidade de validação independente antes de qualquer uso em sistemas críticos. A advertência da NVIDIA sobre a inadequação para aplicações de segurança crítica é um lembrete importante de que a aparência realista não deve ser confundida com a correção física, exigindo sempre uma análise de segurança a nível de sistema.
As salvaguardas de segurança, incluindo a triagem de conteúdo e a marca d'água SynthID, são mecanismos importantes para garantir a integridade e a origem dos dados gerados. A presença da marca d'água nas saídas visuais ajuda a distinguir conteúdo sintético de conteúdo real, o que é crucial para a transparência e a ética no uso de dados de IA. A comparação com a variante Transfer-Auto destaca a especialização do Sim-Transfer para cenários gerais de robótica e industrial, enquanto a outra variante atende a necessidades específicas de direção autônoma com sensores LiDAR, oferecendo uma escolha mais direcionada para esse domínio.
Critérios práticos para a escolha do modelo
A decisão de usar o Cosmos3-Nano-Sim-Transfer depende de se é necessário gerar dados sintéticos visuais em grande escala para treinar modelos de percepção e se há infraestrutura GPU disponível. Se o objetivo é simular física precisa para controle em tempo real, este modelo não é adequado; deve ser usado como complemento visual a um simulador físico clássico.
Para equipes com recursos limitados, a variante Edge (4B) pode ser mais viável, embora com menor qualidade. Para aplicações de direção autônoma com sensores LiDAR, a variante Transfer-Auto é mais específica. A escolha deve basear-se no equilíbrio entre qualidade visual, custo computacional e a necessidade de coerência física, mantendo sempre a validação humana e técnica dos resultados.
A escolha do Cosmos3-Nano-Sim-Transfer deve ser guiada pela necessidade específica de gerar dados visuais sintéticos para treinamento de modelos de percepção, em vez de simular física para controle em tempo real. Para equipes que buscam complementar simuladores físicos clássicos com uma camada visual realista, este modelo oferece uma solução eficaz, desde que a infraestrutura GPU necessária esteja disponível. A variante Edge pode ser uma alternativa viável para recursos limitados, embora com uma redução na qualidade visual, enquanto a Transfer-Auto é a escolha preferida para aplicações de direção autônoma com LiDAR.
O equilíbrio entre a qualidade visual, o custo computacional e a necessidade de coerência física deve ser avaliado cuidadosamente em cada caso de uso. A validação humana e técnica dos resultados é um passo indispensável para garantir que os dados sintéticos gerados sejam adequados para o propósito pretendido. A decisão final deve considerar não apenas as métricas de desempenho publicadas, mas também a capacidade da equipe de gerenciar a infraestrutura de implantação e de validar a saída do modelo em contextos de aplicação específicos.
Tabela de decisão: Quando usar o Sim-Transfer?
Guia rápido para determinar a adequação do modelo conforme o caso de uso.
| Caso de uso | Adequação | Motivo |
|---|---|---|
| Gerar dados sintéticos para treinar visão computacional | Alta | Gera vídeo RGB realista a partir de controles estruturais. |
| Simulação física precisa para controle de robôs | Baixa | Não é um motor de física; a precisão física não é garantida. |
| Direção autônoma com LiDAR | Média/Baixa | Usar Transfer-Auto para LiDAR; Sim-Transfer é mais generalista. |
| Implantação em CPU ou GPU de baixo custo | Baixa | Requer GPU NVIDIA de alto desempenho (Hopper/Blackwell). |
Questões em aberto
- Não foi verificada uma tarifa de API direta da NVIDIA para este checkpoint específico; os custos são de infraestrutura própria.
- Os benchmarks do PAI-Bench-C são do fornecedor e não foram replicados de forma independente.
- O desempenho exato em hardware específico não fornecido pelo usuário pode variar conforme a configuração de paralelismo e a carga do sistema.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção