Ce qu’une trace d’IA permet de résoudre — et ce qu’elle ne prouve pas
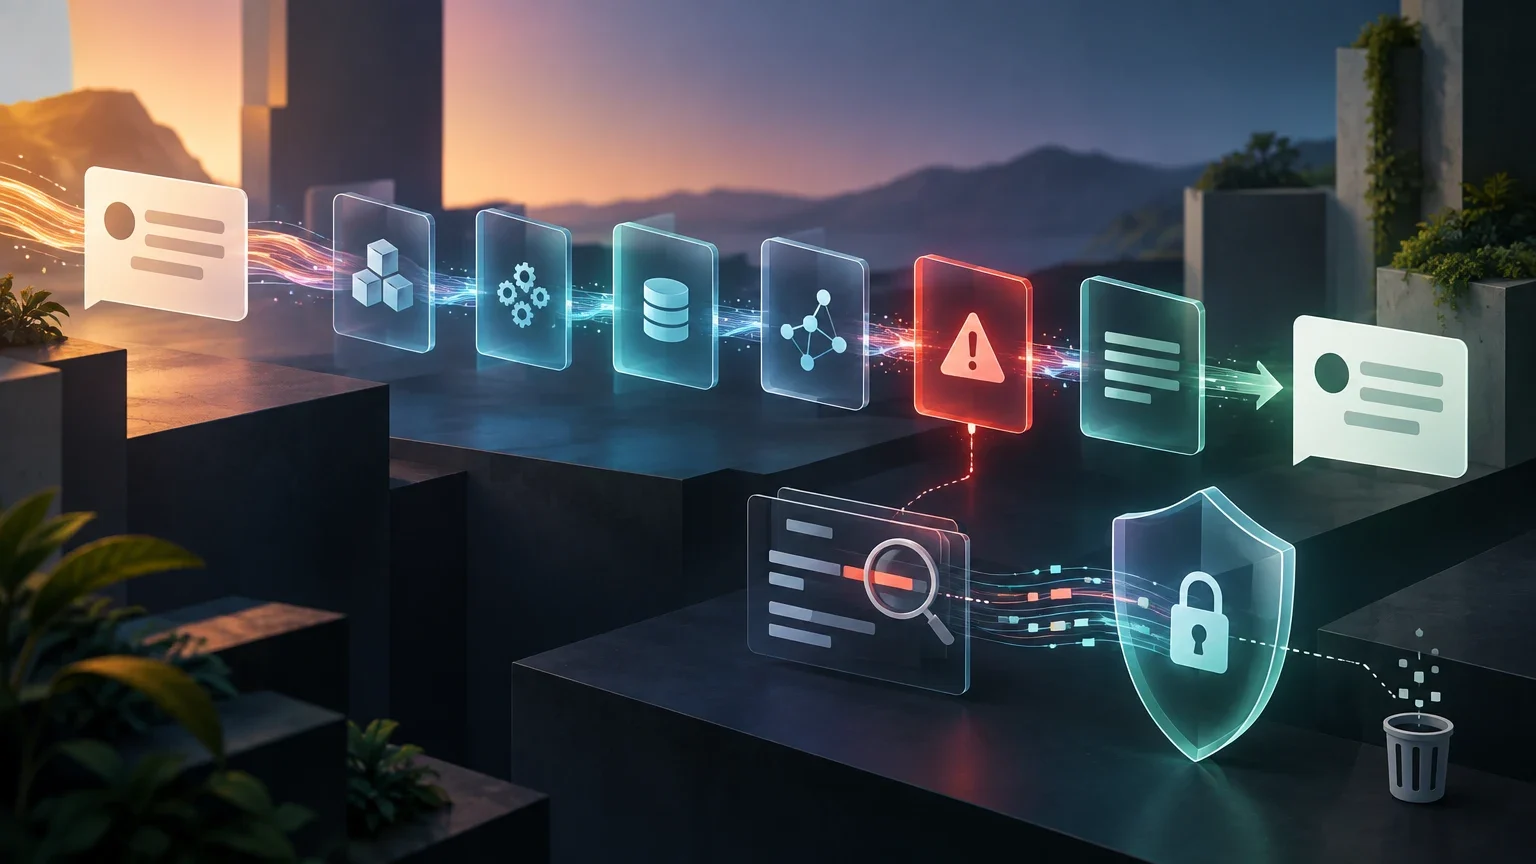
Une trace permet d’observer les opérations qui composent une requête et les relations entre elles. Dans une application d’IA, elle peut relier l’entrée reçue par le service, la récupération de documents, un ou plusieurs appels au modèle, l’exécution d’outils, les validations et la réponse fournie. Son utilité principale est de reconstituer le parcours technique : les étapes qui ont eu lieu, leur ordre et l’endroit où une lenteur, une erreur ou un résultat inattendu est apparu.
À elle seule, une trace ne prouve pas pourquoi un modèle a généré une phrase donnée, que la réponse est correcte ni qu’une prochaine exécution produira le même résultat. Elle représente ce que le système instrumenté a observé et choisi d’enregistrer. Si des spans, des attributs ou des événements manquent, le parcours peut être incomplet. Si le contenu sensible est exclu, il peut aussi être impossible d’inspecter littéralement l’entrée ou la réponse ; cela peut relever d’un choix délibéré en matière de confidentialité, et non d’un défaut de la trace.
Il est utile de distinguer les faits observés des hypothèses. « L’appel à l’outil s’est terminé par une erreur » est une observation susceptible de figurer dans la télémétrie. « Cette erreur a provoqué la réponse incorrecte » est une interprétation qui nécessite d’examiner le flux et, si possible, de la confronter à d’autres exécutions. Le traçage aide à repérer une cause probable ; il ne remplace ni les tests, ni l’évaluation de la qualité, ni l’examen des données et des instructions système.
Traces, métriques et journaux : des signaux différents
Une trace représente une exécution reliée de bout en bout. Ses spans décrivent des opérations et peuvent être organisés en relations parent-enfant ; par exemple, une opération de réponse peut contenir une récupération et une génération, laquelle peut inclure un appel à un outil. Les événements associés à un span ajoutent des faits ponctuels. Cette structure permet de parcourir une requête sans dépendre uniquement de la recherche de messages textuels similaires.
Une métrique résume des mesures servant à observer des tendances ou des états agrégés, comme la durée ou le nombre d’erreurs. Elle permet de détecter des changements et de comparer des groupes d’exécutions, mais n’explique généralement pas à elle seule ce qui s’est passé lors d’une requête particulière. Évitez d’utiliser des identifiants uniques d’utilisateur, de requête ou de document comme dimensions de métriques : ils entraînent une forte cardinalité et compliquent la gestion d’agrégations maîtrisables. Utilisez les traces pour examiner les détails et des métriques aux dimensions limitées pour la surveillance agrégée.
Un journal est un événement ou un message indépendant, par exemple un avertissement de validation. Il peut inclure le contexte de trace afin de le relier à une exécution, sans nécessairement préserver la structure hiérarchique de toutes les étapes. En pratique, les trois signaux se complètent : les métriques servent à détecter une anomalie, les traces à parcourir une exécution et les journaux à apporter un contexte ponctuel. Aucun n’impose d’enregistrer intégralement le contenu d’une conversation.
Quel signal consulter en premier ?
Règle pratique : choisissez le signal en fonction de la question et limitez les attributs identifiants à ce qui est réellement nécessaire.
| Question | Signal principal | Utilisation recommandée |
|---|---|---|
| La latence ou le nombre d’erreurs a-t-il augmenté ? | Métrique | Observer les tendances agrégées et délimiter la période concernée. |
| Quelles opérations cette requête a-t-elle parcourues ? | Trace | Examiner les spans, leurs relations, leur durée et leur résultat. |
| Quel avertissement un validateur a-t-il émis ? | Journal ou événement | Consulter le fait et le relier à la trace lorsqu’un contexte est disponible. |
Cartographier le parcours d’une requête
Avant d’instrumenter, cartographiez le flux réel de l’application, et non celui qu’on suppose qu’elle suit. Un parcours simple peut commencer par le service d’entrée, vérifier la requête, récupérer des documents, construire le contexte, appeler le modèle, exécuter un outil si nécessaire, valider la sortie puis renvoyer une réponse. Il peut comporter des tentatives répétées, des branches, des appels parallèles ou une seconde génération après l’utilisation d’un outil ; ces opérations doivent être représentées séparément lorsqu’elles sont utiles au diagnostic.
Une hiérarchie lisible pourrait comprendre un span racine pour l’opération de l’application, puis des spans enfants pour la récupération, la génération, l’outil et la validation. La relation parent-enfant indique quelle opération en contient une autre ; des liens de contexte peuvent relier des opérations qui ne s’inscrivent pas clairement dans une hiérarchie simple. Il n’est pas nécessaire de créer un span pour chaque instruction interne : instrumentez les frontières où une décision est prise, où une dépendance est appelée ou où une opération peut échouer.
Attribuez un identifiant de corrélation à l’exécution et propagez-le aux opérations qui y participent, y compris aux services internes qui acceptent le contexte de trace. N’intégrez pas cet identifiant au nom du span ni comme dimension de métrique. Les noms doivent décrire des opérations de manière stable et avec une cardinalité limitée ; les valeurs uniques appartiennent, si elles sont nécessaires et sûres, aux attributs d’une trace protégée par des contrôles d’accès.
Champs minimaux pour reconstituer le flux
Le schéma minimal doit permettre de répondre à quatre questions : quelle opération a eu lieu ? À quelle exécution appartient-elle ? Combien de temps a-t-elle duré ? Comment s’est-elle terminée ? Des noms d’opérations stables, les relations entre spans, des horodatages ou des durées, un état et une catégorie d’erreur sont généralement utiles à cette fin. Ajoutez des attributs à cardinalité maîtrisée permettant, par exemple, de distinguer le type d’opération ou l’environnement. Les attributs retenus doivent correspondre à l’instrumentation et aux conventions réellement adoptées par l’équipe.
Pour les appels de génération, il peut également être utile de collecter des informations opérationnelles comme le fournisseur ou le modèle configuré, la durée, l’état et les compteurs d’utilisation disponibles. La disponibilité et la signification de ces champs dépendent de l’intégration : ne partez pas du principe que deux instrumentations nomment le même élément de la même manière ou le calculent de façon identique. Enregistrez aussi si une récupération, un outil, une nouvelle tentative ou une validation a eu lieu, avec des états qui distinguent « non exécuté » de « exécuté et en échec ».
Pour localiser un résultat défectueux sans conserver le prompt ou chaque document, combinez les métadonnées de flux, les quantités et les états : nombre de résultats récupérés, résultat de la validation, type d’erreur, version identifiable de l’application et durées par opération. S’il est nécessaire de comparer des entrées, envisagez des empreintes ou des références internes à accès restreint, tout en évaluant leur réversibilité ou leur capacité à relier des données personnelles. Une empreinte n’est pas automatiquement anonyme. Évitez d’enregistrer par commodité des noms, des adresses, des jetons d’accès, des arguments d’outils complets ou des documents entiers.
Collecte minimale et collecte de contenu
La colonne « collecte minimale » constitue un point de départ technique, et non un ensemble universellement obligatoire.
| Besoin de diagnostic | Collecte minimale envisageable | Risque lié à une collecte plus large |
|---|---|---|
| Repérer l’étape lente | Durée par span et nom de l’opération | Des arguments complets peuvent révéler du contenu sans améliorer la mesure. |
| Savoir si la récupération a renvoyé des résultats | État et nombre de résultats | L’enregistrement des documents entiers expose leur contenu et des données personnelles. |
| Comprendre l’échec d’un outil | Type d’outil, état et catégorie d’erreur | Les arguments peuvent contenir des secrets, des identifiants ou du texte fourni par l’utilisateur. |
| Comparer le comportement des générations | Configuration identifiable, état et usage disponible | Les prompts et réponses complets augmentent l’exposition et le coût de protection. |
Contenu sensible : réduire, expurger et contrôler
Les prompts, les réponses, les documents récupérés et les arguments d’outils peuvent contenir des données personnelles, des informations confidentielles ou des secrets opérationnels. Considérez-les comme potentiellement sensibles, même si l’application ne les classe pas ainsi. Pour les diagnostics habituels, l’option la plus sûre consiste à ne pas les collecter par défaut. Si un cas d’usage précis nécessite des fragments, définissez lesquels, qui peut les consulter, pendant combien de temps et selon quelle procédure d’approbation.
L’expurgation peut supprimer ou remplacer des valeurs avant leur exportation ; le filtrage peut écarter les données ou les événements qui ne doivent pas quitter le processus. Déterminez à quel endroit ils s’appliquent et vérifiez leur effet avec des données de test. Une transformation ultérieure dans le Collector peut réduire ou modifier la télémétrie avant son exportation, mais cela ne signifie pas que le contenu n’a pas été généré, capturé ou stocké avant d’atteindre ce composant. Examinez chaque étape de la chaîne : instrumentation, tampon, Collector, exportateur et stockage.
Limitez l’accès aux traces selon les fonctions et consignez les accès lorsque la plateforme le permet. Définissez une durée de conservation courte, adaptée au temps nécessaire à l’analyse des incidents, et vérifiez que les copies, les exportations et les tampons respectent cette politique. L’échantillonnage peut réduire le volume, mais ne remplace pas la protection de chaque trace conservée. Prévoyez une procédure contrôlée pour augmenter temporairement le niveau de détail pendant une enquête, avec autorisation, périmètre limité et date de fin.
Processus de réduction avant l’exportation
Appliquez ces contrôles comme modèle de conception et vérifiez leur emplacement dans l’implémentation concrète.
- 01Inventorier les champs produits par chaque instrumentation, notamment les arguments, entrées, sorties et exceptions.
- 02Classer les champs : indispensables à l’exploitation, utiles uniquement lors d’enquêtes particulières ou superflus.
- 03Désactiver la collecte de contenu non nécessaire et expurger ou filtrer les champs approuvés avant leur exportation.
- 04Tester avec des valeurs factices que l’expurgation couvre les spans, les événements, les journaux et les chemins d’erreur, et pas seulement le scénario nominal.
- 05Vérifier les destinations, les autorisations, les tampons et les délais de suppression ; documenter les personnes autorisées à augmenter le niveau de collecte.
Lire une trace pour repérer le composant défaillant
Commencez par le span racine et vérifiez qu’il représente l’exécution que vous cherchez à examiner. Contrôlez son état et parcourez les spans enfants dans l’ordre chronologique. Repérez les interruptions entre opérations, les spans sans résultat ou les dépendances dont la durée est anormale par rapport à leur historique. Une durée totale élevée ne permet pas, à elle seule, d’identifier le composant concerné : elle peut venir d’une récupération lente, d’un appel au modèle, de l’attente d’un outil, de nouvelles tentatives ou d’un travail non instrumenté.
Si la réponse ne contient pas des informations qui auraient dû être récupérées, examinez d’abord l’état et le nombre de résultats, les filtres de récupération et la construction du contexte. Si le contexte semble adéquat mais que la génération échoue ou prend du temps, examinez le span du modèle, son état et les tentatives répétées. Si le modèle demande une action mais que le résultat final est incorrect, suivez le span de l’outil et vérifiez s’il a échoué, renvoyé des données inattendues ou été écarté du flux. Si la réponse a été générée mais n’est pas parvenue à l’utilisateur, examinez la validation et l’opération qui construit la sortie.
Ces parcours sont des hypothèses de travail, et non des règles permettant d’attribuer automatiquement la faute. Un outil peut renvoyer une réponse valide que l’application traite mal ; un validateur peut rejeter une sortie correcte en raison de sa configuration ; une trace incomplète peut masquer une opération intermédiaire. Notez les éléments qui étayent chaque conclusion et les informations manquantes. Si le diagnostic exige l’examen du contenu, demandez une collecte temporaire et approuvée lors d’une exécution de test, plutôt que d’activer sans discernement l’enregistrement des prompts des utilisateurs.
Répéter n’est pas reproduire à l’identique
Relancer une requête peut aider à comparer des changements, mais ne garantit pas la reproduction de la réponse d’origine. Le modèle peut produire des variations ; en outre, l’état de l’application, les documents récupérables, la version de l’index, le contenu d’un outil externe ou la configuration du service peuvent changer. Une répétition ultérieure peut parcourir des spans similaires sans constituer pour autant une reproduction exacte.
Pour rendre une comparaison plus informative, consignez de manière sûre et limitée la version de l’application, la configuration pertinente, les identifiants de modèle exposés par l’intégration, l’état ou la version de l’index lorsqu’ils sont connus, ainsi que les versions des outils internes. Notez également l’heure et l’environnement. Si l’objectif le permet, gardez les entrées de test sous contrôle et utilisez du contenu synthétique ou autorisé. Si une dépendance externe ne fournit ni version ni instantané, indiquez cette limite dans l’analyse.
Faites la distinction entre relancer une requête sur le système actuel et reproduire une exécution historique avec les mêmes dépendances et le même état. La première démarche permet d’observer le comportement présent ; la seconde exige de conserver et de pouvoir rétablir davantage de conditions, ce qui peut être impraticable ou inapproprié si cela implique de retenir des données sensibles. Ne qualifiez pas un test de « reproductible » au seul motif qu’il réutilise le même texte d’entrée. Décrivez ce qui est resté identique, ce qui a pu changer et les comparaisons qui restent justifiables.
OpenTelemetry GenAI : une base utile, encore en développement
OpenTelemetry publie des conventions sémantiques pour les systèmes d’IA générative couvrant les événements, les exceptions, les métriques et les spans liés aux modèles et aux agents. Elles ont pour intérêt de proposer un vocabulaire commun et de faciliter la représentation d’opérations comparables par différentes instrumentations. La documentation du projet indique que ces conventions sont au stade « Development ». Elles constituent donc une référence utile pour évaluer les noms et les attributs, mais pas un contrat universel dont la stabilité ou l’adoption complète pourrait être tenue pour acquise.
Avant de baser des tableaux de bord, des alertes ou des exportations sur des attributs précis, vérifiez la version des conventions et l’implémentation utilisée par chaque SDK. Contrôlez les champs émis, leur nommage, l’éventuelle inclusion de contenu et les paramètres qui modifient la collecte. Deux instrumentations peuvent couvrir des hiérarchies comparables tout en différant par leurs noms, leurs valeurs, leurs options d’expurgation, leur exportation ou leur gestion des tampons. Cette variabilité impose de tester l’interopérabilité et de documenter les correspondances, plutôt que de la présumer.
La documentation de l’OpenAI Agents SDK décrit une hiérarchie de spans pour les agents, les générations et les outils, ainsi que des options concernant les données sensibles, l’exportation, la mise en tampon et l’expurgation. Elle indique également que la désactivation du traçage ne supprime pas nécessairement les données déjà placées dans un tampon. Cet exemple illustre une précaution générale : une option d’arrêt ne doit pas être considérée comme un mécanisme d’effacement rétroactif. Vérifiez le comportement de la version utilisée et prenez en compte tous les endroits où les données peuvent subsister.
Les sources disponibles ne permettent pas d’affirmer quelles données sont capturées par défaut par chaque SDK ou instrumentation officielle, ni de comparer exhaustivement deux implémentations et leurs options. Il faut obtenir cette réponse dans la documentation de la version déployée et par un test contrôlé. Dans l’attente de cette vérification, adoptez l’approche prudente : inspectez le contenu exporté et configurez explicitement la réduction des données.
Points à vérifier avant d’adopter une convention
La convention guide le schéma ; seul un test de l’implémentation confirme son comportement effectif.
| Aspect | Vérification pratique | Précaution |
|---|---|---|
| État et version | Identifier la version des conventions et du SDK. | Le stade de développement peut impliquer des changements. |
| Couverture | Comparer les spans, événements, métriques et exceptions émis. | Le nom d’une catégorie ne garantit pas que toutes les instrumentations l’implémentent. |
| Contenu sensible | Examiner une exportation de test et tester l’expurgation. | Ne pas déduire les valeurs par défaut d’une description générale. |
| Exportation et tampon | Vérifier ce qui est exporté et ce qui peut être stocké temporairement. | Désactiver le traçage n’équivaut pas à supprimer les données déjà stockées. |
Liste de contrôle pour instrumenter une application
Commencez par un cas d’usage opérationnel concret : localiser une latence, des échecs de récupération, des erreurs d’outils ou des rejets lors de la validation. Cartographiez le parcours et convenez de noms de spans stables. Vérifiez que le contexte est propagé entre les composants internes et que la trace permet de suivre la requête complète sans inclure d’identifiants uniques dans les noms ou les métriques. Commencez par enregistrer les états et les durées avant d’envisager de collecter du contenu.
Pour chaque attribut, posez une question simple : quelle décision opérationnelle permettra-t-il de prendre ? Contient-il des informations sensibles ? Combien de temps doit-il être conservé ? Qui pourra le consulter ? En l’absence de réponse claire, omettez-le. Définissez l’expurgation et le filtrage aux endroits appropriés du pipeline, puis testez aussi les exceptions, les tentatives répétées et les échecs d’exportation. Configurez les autorisations, la durée de conservation et l’échantillonnage de manière cohérente avec les risques et les besoins de diagnostic.
Enfin, réalisez des tests contrôlés avec une récupération vide, une erreur d’outil simulée, une réponse rejetée par la validation et un cas normal. Vérifiez que les spans distinguent ces résultats et qu’aucun secret ni contenu non approuvé n’apparaît dans les exportations. Documentez les limites connues, notamment l’impossibilité de répéter exactement une exécution lorsque les dépendances changent. Réexaminez régulièrement la politique : une instrumentation adaptée à un flux peut ne plus l’être après l’ajout d’agents, d’outils ou de nouveaux types de données.
Contrôle opérationnel avant le déploiement
Utilisez cette liste comme étape de validation et conservez les preuves des tests réalisés.
- 01Le parcours couvre l’entrée, la récupération, la génération, les outils, la validation et la sortie lorsqu’ils sont présents.
- 02Chaque span important a un nom stable, une relation compréhensible, une durée et un état.
- 03Les métriques utilisent des dimensions limitées ; elles n’incluent pas d’identifiants uniques d’exécution ou d’utilisateur.
- 04La collecte des prompts, des documents et des arguments est désactivée, sauf besoin justifié et approuvé.
- 05L’expurgation et le filtrage sont testés avant l’exportation, y compris sur les chemins d’erreur.
- 06Les responsables et les limites d’accès, de conservation, de tampon, de destination et d’échantillonnage sont documentés.
- 07Le test distingue les faits observés des hypothèses et indique les dépendances qui empêchent de reproduire exactement une exécution.
Questions ouvertes
- Les sources fournies ne permettent pas d’établir quelles données sont capturées par défaut par chaque SDK ou instrumentation, ni de comparer exhaustivement deux implémentations officielles ; il faut consulter la documentation de la version déployée et tester ses exportations.
- La disponibilité, le nom et la signification des attributs relatifs aux jetons, au modèle, à la récupération ou aux outils dépendent de l’intégration et de la version des conventions adoptée.
- Une reproduction exacte ne peut être garantie lorsque le modèle ou les dépendances externes ne fournissent pas une version ou un état susceptible d’être conservé et rétabli.
- L’emplacement effectif de l’expurgation dépend de l’architecture : une transformation du Collector peut agir avant l’exportation depuis ce composant, mais ne prouve pas que les données n’ont pas été capturées ou stockées auparavant.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction