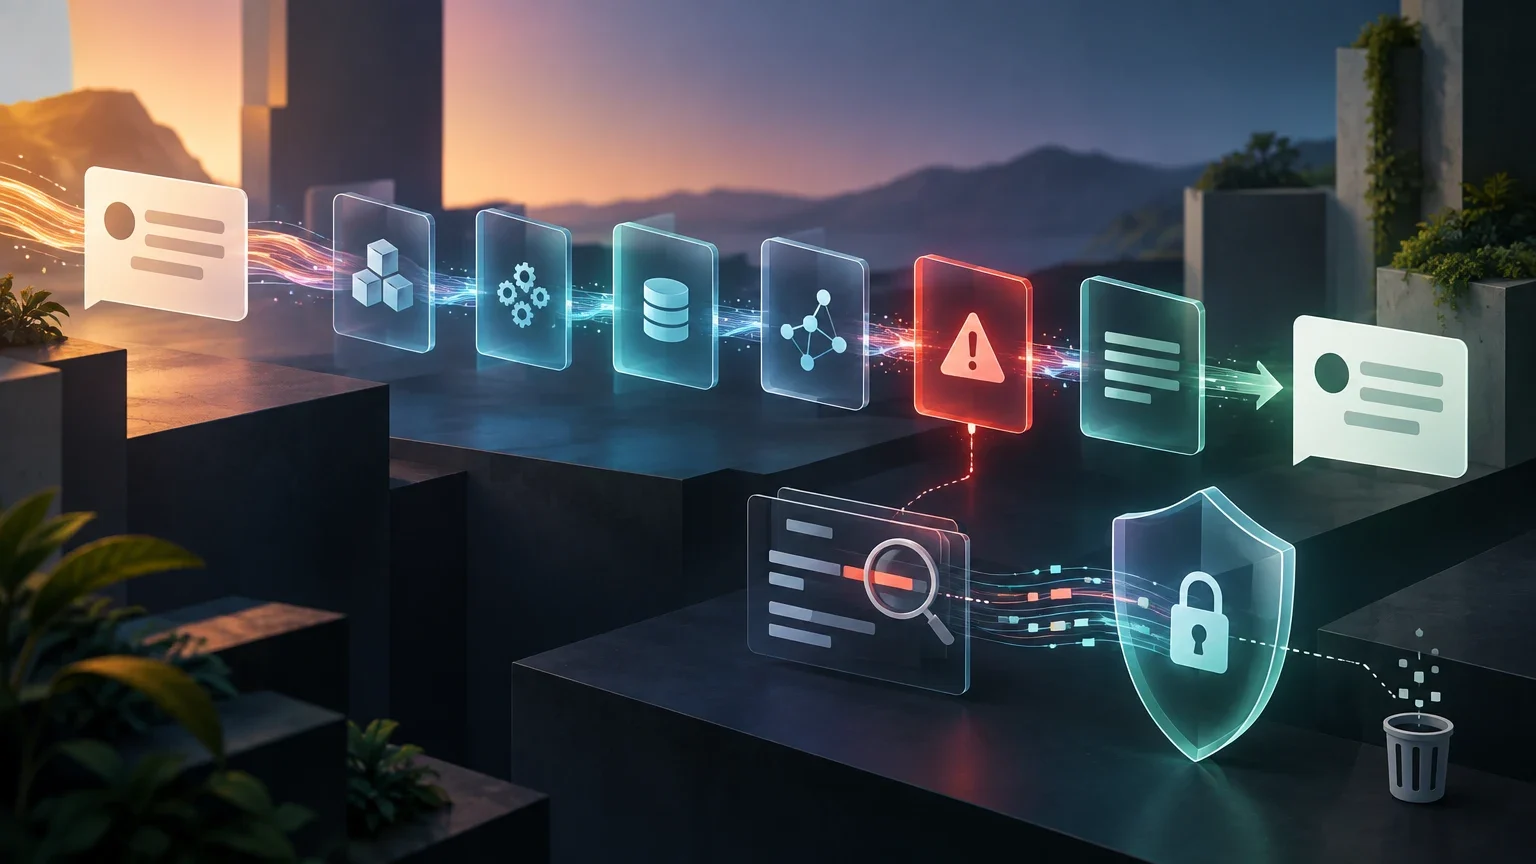
Che cosa risolve una traccia di IA e che cosa non dimostra
Una traccia permette di osservare le operazioni che compongono una richiesta e le relazioni tra di esse. In un’applicazione di IA può collegare l’input ricevuto dal servizio, il recupero dei documenti, una o più chiamate al modello, l’esecuzione degli strumenti, le convalide e la risposta restituita. La sua utilità principale è ricostruire il percorso tecnico: quali passaggi sono avvenuti, in quale ordine e dove si è verificato un ritardo, un errore o un risultato inatteso.
Una traccia, da sola, non dimostra perché un modello abbia generato una determinata frase, che la risposta sia corretta o che una futura esecuzione la ripeterà. È una rappresentazione di ciò che il sistema strumentato ha osservato e ha deciso di registrare. Se mancano span, attributi o eventi, il percorso può risultare incompleto. Se si esclude il contenuto sensibile, potrebbe non essere possibile esaminare alla lettera l’input o la risposta: può trattarsi di una scelta deliberata a tutela della privacy, non di un difetto della traccia.
È utile distinguere i fatti osservati dalle ipotesi. «La chiamata allo strumento è terminata con un errore» è un’osservazione che può comparire nella telemetria. «Quell’errore ha causato la risposta errata» è un’interpretazione che richiede di esaminare il flusso e, se possibile, confrontarlo con altre esecuzioni. La tracciabilità aiuta a individuare una causa probabile; non sostituisce i test, la valutazione della qualità o l’analisi dei dati e delle istruzioni di sistema.
Tracce, metriche e log: segnali diversi
Una traccia rappresenta un’esecuzione collegata dall’inizio alla fine. I suoi span descrivono le operazioni e possono avere relazioni padre-figlio; per esempio, un’operazione di risposta può contenere un recupero e una generazione, e quest’ultima può includere una chiamata a uno strumento. Gli eventi associati a uno span aggiungono informazioni su singoli avvenimenti. Questa struttura consente di seguire una richiesta senza affidarsi soltanto alla ricerca di messaggi di testo simili.
Una metrica riassume misure utili per osservare tendenze o stati aggregati, come la durata o il numero di errori. Serve a rilevare variazioni e confrontare gruppi di esecuzioni, ma normalmente non spiega da sola che cosa sia accaduto in una richiesta specifica. Evita di usare identificativi univoci di utente, richiesta o documento come dimensioni delle metriche: producono un’elevata cardinalità e rendono più difficile mantenere aggregazioni gestibili. Usa le tracce per i dettagli e metriche con dimensioni limitate per il monitoraggio aggregato.
Un log è un evento o un messaggio autonomo, per esempio un avviso di convalida. Può includere il contesto della traccia per collegarsi a un’esecuzione, ma non necessariamente conserva la struttura gerarchica di tutti i passaggi. Nella pratica, i tre segnali si integrano: le metriche aiutano a scoprire un’anomalia, le tracce a seguire un’esecuzione e i log ad aggiungere contesto puntuale. Nessuno dei tre richiede di conservare per intero il contenuto di una conversazione.
Quale segnale consultare per primo
Indicazione pratica: scegli il segnale in base alla domanda e limita gli attributi identificativi a ciò che serve davvero.
| Domanda | Segnale principale | Uso consigliato |
|---|---|---|
| Sono aumentati la latenza o gli errori? | Metrica | Osservare le tendenze aggregate e circoscrivere il periodo interessato. |
| Quali operazioni ha attraversato questa richiesta? | Traccia | Esaminare span, relazioni, durata e risultato. |
| Quale avviso ha emesso un validatore? | Log o evento | Consultare l’evento e collegarlo alla traccia quando è disponibile il contesto. |
Disegnare la mappa di una richiesta
Prima di strumentare, disegna il flusso effettivo dell’applicazione, non quello che si presume segua. Un percorso semplice potrebbe iniziare dal servizio di ingresso, verificare la richiesta, recuperare documenti, costruire il contesto, chiamare il modello, eseguire uno strumento se richiesto, convalidare l’output e restituire una risposta. Potrebbero esserci tentativi ripetuti, diramazioni, chiamate parallele o una seconda generazione dopo l’uso di uno strumento: quando sono rilevanti per la diagnosi, vanno rappresentati come operazioni distinte.
Una gerarchia leggibile potrebbe avere uno span radice per l’operazione dell’applicazione e span figli per recupero, generazione, strumento e convalida. La relazione padre-figlio spiega quale operazione ne contiene un’altra; i collegamenti di contesto possono mettere in relazione operazioni che non si inseriscono facilmente in una gerarchia semplice. Non è necessario creare uno span per ogni istruzione interna: strumenta i confini in cui si prendono decisioni, si chiama una dipendenza o un’operazione può fallire.
Assegna un identificativo di correlazione all’esecuzione e propagalo alle operazioni che vi partecipano, compresi i servizi interni che accettano il contesto della traccia. Non inserire quell’identificativo nel nome dello span né usarlo come dimensione di una metrica. I nomi devono descrivere operazioni in modo stabile e con cardinalità limitata; se necessari e sicuri, i valori univoci appartengono agli attributi di una traccia protetta da adeguati controlli di accesso.
Campi minimi per ricostruire il flusso
Lo schema minimo deve permettere di rispondere a quattro domande: quale operazione è avvenuta? A quale esecuzione appartiene? Quanto è durata? Come si è conclusa? A questo scopo sono spesso utili nomi stabili delle operazioni, relazioni tra span, marcature temporali o durata, stato e una categoria di errore. Aggiungi attributi con cardinalità limitata che permettano, per esempio, di distinguere il tipo di operazione o l’ambiente. Gli attributi concreti devono corrispondere alla strumentazione e alle convenzioni effettivamente adottate dal team.
Per le chiamate di generazione può essere utile raccogliere anche informazioni operative, come provider o modello configurato, durata, stato e contatori di utilizzo disponibili. La disponibilità e il significato di questi campi dipendono dall’integrazione: non dare per scontato che due strumenti chiamino allo stesso modo lo stesso dato o lo calcolino nello stesso modo. Registra anche se sono avvenuti recupero, uso di uno strumento, nuovo tentativo o convalida, con stati che distinguano «non eseguito» da «eseguito ma non riuscito».
Per individuare un risultato difettoso senza conservare il prompt o ogni documento, combina metadati del flusso, quantità e stati: numero di risultati recuperati, esito della convalida, tipo di errore, versione identificabile dell’applicazione e tempi per operazione. Se serve confrontare gli input, valuta impronte digitali o riferimenti interni ad accesso limitato, ma considera se siano reversibili o se consentano di collegare dati personali. Un’impronta non è automaticamente anonima. Per comodità, evita di registrare nomi, indirizzi, token di accesso, argomenti completi degli strumenti e documenti integrali.
Acquisizione minima e acquisizione del contenuto
La colonna sull’acquisizione minima è un punto di partenza ingegneristico, non un insieme universale di requisiti.
| Esigenza diagnostica | Possibile acquisizione minima | Rischio di un’acquisizione più ampia |
|---|---|---|
| Individuare il passaggio lento | Durata per span e nome dell’operazione | Gli argomenti completi possono rivelare contenuti senza migliorare la misurazione. |
| Sapere se il recupero ha restituito risultati | Stato e numero di risultati | Registrare documenti interi espone contenuti e dati personali. |
| Capire un errore dello strumento | Tipo di strumento, stato e categoria di errore | Gli argomenti possono contenere segreti, identificativi o testo dell’utente. |
| Confrontare il comportamento delle generazioni | Configurazione identificabile, stato e utilizzo disponibile | Prompt e risposte completi aumentano l’esposizione e i costi di protezione. |
Contenuti sensibili: ridurre, oscurare e controllare
Prompt, risposte, documenti recuperati e argomenti degli strumenti possono contenere dati personali, informazioni riservate o segreti operativi. Considerali contenuti potenzialmente sensibili anche se l’applicazione non li classifica come tali. Per la diagnosi ordinaria, l’opzione più sicura è non acquisirli per impostazione predefinita. Se un caso d’uso specifico richiede dei frammenti, stabilisci quali, chi può consultarli, per quanto tempo e con quale procedura di approvazione.
L’oscuramento può eliminare o sostituire valori prima dell’esportazione; il filtraggio può scartare dati o eventi che non devono uscire dal processo. Decidi in quale punto applicarli e verifica il risultato con dati di prova. Una trasformazione successiva nel Collector può ridurre o modificare la telemetria prima di esportarla, ma non va confusa con l’impedire che il contenuto sia stato generato, acquisito o memorizzato prima di raggiungere quel componente. Esamina ogni fase del percorso: strumentazione, buffer, Collector, esportatore e archiviazione.
Limita l’accesso alle tracce in base alle funzioni lavorative e, se la piattaforma lo consente, registra gli accessi. Definisci un periodo di conservazione breve, commisurato al tempo necessario per indagare gli incidenti, e verifica che copie, esportazioni e buffer rispettino la policy. Il campionamento può ridurre i volumi, ma non sostituisce la protezione di ogni traccia conservata. Mantieni una procedura controllata per aumentare temporaneamente il livello di dettaglio durante un’indagine, con autorizzazione, ambito limitato e data di conclusione.
Procedura per ridurre i dati prima dell’esportazione
Applica questi controlli come modello di riferimento e verifica dove si trovano nella specifica implementazione.
- 01Inventaria i campi prodotti da ogni strumento, inclusi argomenti, input, output ed eccezioni.
- 02Classifica i campi: necessari per l’operatività, utili soltanto in indagini specifiche oppure superflui.
- 03Disattiva l’acquisizione dei contenuti non necessari e oscura o filtra i campi approvati prima dell’esportazione.
- 04Verifica con valori fittizi che l’oscuramento copra span, eventi, log e percorsi di errore, non soltanto il caso normale.
- 05Controlla destinazioni, autorizzazioni, buffer e scadenze di eliminazione; documenta chi può aumentare il livello di acquisizione.
Leggere una traccia per individuare il componente che ha fallito
Inizia dallo span radice e verifica che rappresenti l’esecuzione che vuoi indagare. Controllane lo stato e percorri i figli in ordine temporale. Cerca intervalli vuoti tra le operazioni, span senza risultato o dipendenze che abbiano impiegato un tempo anomalo rispetto alla loro cronologia. Una durata complessiva elevata non identifica da sola il componente: può dipendere da un recupero lento, da una chiamata al modello, dall’attesa di uno strumento, da nuovi tentativi o da attività non strumentate.
Se la risposta non contiene informazioni che avrebbe dovuto recuperare, esamina prima lo stato e il numero di risultati, i filtri di recupero e la costruzione del contesto. Se il contesto sembra adeguato ma la generazione non riesce o impiega troppo tempo, controlla lo span del modello, il suo stato e gli eventuali nuovi tentativi. Se il modello richiede un’azione ma il risultato finale è errato, segui lo span dello strumento e verifica se è fallito, ha restituito dati inattesi o è rimasto fuori dal flusso. Se la risposta è stata generata ma non è arrivata all’utente, esamina la convalida e l’operazione che costruisce l’output.
Questi percorsi sono ipotesi di lavoro, non regole per attribuire automaticamente la colpa. Uno strumento può restituire una risposta valida che l’applicazione elabora male; un validatore può rifiutare un output corretto a causa della configurazione; una traccia incompleta può nascondere un’operazione intermedia. Annota quali prove sostengono ogni conclusione e quali informazioni mancano. Se la diagnosi richiede di esaminare il contenuto, richiedi un’acquisizione temporanea e approvata in un’esecuzione di test, invece di attivare indiscriminatamente la registrazione dei prompt degli utenti.
Ripetere non significa riprodurre esattamente
Eseguire di nuovo una richiesta può aiutare a confrontare modifiche, ma non garantisce che venga riprodotta la risposta originale. Il modello può produrre variazioni; inoltre, possono cambiare lo stato dell’applicazione, i documenti disponibili per il recupero, la versione dell’indice, il contenuto di uno strumento esterno o la configurazione del servizio. Una ripetizione successiva può attraversare span simili e tuttavia non costituire una riproduzione esatta.
Per rendere più informativo un confronto, registra in modo sicuro e limitato la versione dell’applicazione, la configurazione pertinente, gli identificativi del modello esposti dall’integrazione, lo stato o la versione dell’indice quando noti e le versioni degli strumenti interni. Annota anche l’ora e l’ambiente. Se l’obiettivo lo consente, mantieni input di test controllati, con contenuti sintetici o autorizzati. Se una dipendenza esterna non fornisce una versione o un’istantanea, dichiara questa limitazione nell’analisi.
Distingui tra ripetere una richiesta sul sistema attuale e riprodurre un’esecuzione storica con le stesse dipendenze e lo stesso stato. La prima serve a osservare il comportamento corrente; la seconda richiede di conservare e poter ripristinare più condizioni e può essere impraticabile o inopportuna se comporta la conservazione di dati sensibili. Non definire «riproducibile» un test solo perché riutilizza lo stesso testo di input. Descrivi che cosa è rimasto invariato, che cosa potrebbe essere cambiato e quale confronto è effettivamente sostenibile.
OpenTelemetry GenAI: una base utile, ancora in sviluppo
OpenTelemetry pubblica convenzioni semantiche per i sistemi di IA generativa che coprono eventi, eccezioni, metriche e span relativi a modelli e agenti. La loro utilità consiste nell’offrire un vocabolario condiviso e nel facilitare la rappresentazione di operazioni comparabili da parte di strumenti diversi. La documentazione del progetto indica che queste convenzioni sono in stato «Development». Sono quindi un riferimento utile per valutare nomi e attributi, non un contratto universale di cui si possa presumere la stabilità o l’adozione completa.
Prima di basare dashboard, avvisi o esportazioni su attributi specifici, controlla la versione delle convenzioni e l’implementazione usata da ciascun SDK. Verifica quali campi vengono emessi, come sono denominati, se includono contenuti e quali impostazioni modificano l’acquisizione. Due strumenti possono coprire gerarchie simili ma differire per nomi, valori, opzioni di oscuramento, esportazione o gestione dei buffer. Questa variabilità richiede di provare l’interoperabilità e documentare le mappature, invece di darla per scontata.
La documentazione dell’SDK OpenAI Agents descrive una gerarchia di span per agenti, generazioni e strumenti, insieme a opzioni relative ai dati sensibili, all’esportazione, al buffering e all’oscuramento. Avverte inoltre che disattivare il tracciamento non elimina necessariamente i dati già presenti in un buffer. È un esempio di una cautela generale: un’opzione di disattivazione non va trattata come un meccanismo di cancellazione retroattiva. Verifica il comportamento della versione concreta e considera tutti i punti in cui i dati possono rimanere memorizzati.
Le fonti disponibili non forniscono informazioni sufficienti per affermare che cosa venga acquisito per impostazione predefinita da ogni SDK o strumento ufficiale, né per confrontare in modo esaustivo due implementazioni e le relative opzioni. Occorre ricavare la risposta dalla documentazione della versione distribuita e da un test controllato. Fino a tale verifica, adotta l’ipotesi prudente: esamina il contenuto esportato e configura esplicitamente la riduzione dei dati.
Che cosa verificare prima di adottare una convenzione
La convenzione orienta lo schema; il test dell’implementazione conferma il comportamento effettivo.
| Aspetto | Verifica pratica | Cautela |
|---|---|---|
| Stato e versione | Individuare la versione delle convenzioni e dell’SDK. | Lo stato di sviluppo può comportare cambiamenti. |
| Copertura | Confrontare span, eventi, metriche ed eccezioni emessi. | Una categoria nominata non garantisce che tutti gli strumenti la implementino. |
| Contenuti sensibili | Esaminare un’esportazione di prova e testare l’oscuramento. | Non dedurre i valori predefiniti da una descrizione generale. |
| Esportazione e buffer | Verificare che cosa viene esportato e che cosa può restare temporaneamente memorizzato. | Disattivare il tracciamento non equivale a cancellare i dati già memorizzati. |
Lista di controllo per strumentare un’applicazione
Inizia da un caso d’uso operativo concreto: individuare la latenza, gli errori di recupero, i problemi degli strumenti o i rifiuti della convalida. Disegna il percorso e concorda nomi stabili per gli span. Verifica che il contesto si propaghi tra i componenti interni e che sia possibile seguire l’intera richiesta senza inserire identificativi univoci nei nomi o nelle metriche. Registra stati e durate prima di prendere in considerazione l’acquisizione di contenuti.
Esamina ogni attributo con alcune domande semplici: quale decisione operativa consentirà di prendere? Contiene informazioni sensibili? Per quanto tempo va conservato? Chi lo vedrà? Se non c’è una risposta chiara, omettilo. Definisci oscuramento e filtraggio nei punti adeguati della pipeline e testa anche eccezioni, nuovi tentativi ed errori di esportazione. Configura autorizzazioni, conservazione e campionamento in modo coerente con i rischi e le esigenze diagnostiche.
Infine, esegui test controllati con un recupero vuoto, un errore simulato dello strumento, una risposta rifiutata dalla convalida e un caso normale. Verifica che gli span distinguano i risultati e che nelle esportazioni non compaiano segreti o contenuti non approvati. Documenta le limitazioni note, inclusa l’impossibilità di ripetere esattamente esecuzioni con dipendenze variabili. Rivedi periodicamente la policy: una strumentazione adatta a un flusso può non esserlo più quando si aggiungono agenti, strumenti o tipi di dati.
Revisione operativa prima della distribuzione
Usa questa lista come fase di approvazione e conserva le prove dei test eseguiti.
- 01Il percorso include input, recupero, generazione, strumenti, convalida e output, quando presenti.
- 02Ogni span importante ha un nome stabile, una relazione comprensibile, una durata e uno stato.
- 03Le metriche usano dimensioni con cardinalità limitata; non includono identificativi univoci di esecuzione o utente.
- 04L’acquisizione di prompt, documenti e argomenti è disattivata, salvo esigenze motivate e approvate.
- 05L’oscuramento e il filtraggio sono testati prima dell’esportazione, anche nei percorsi di errore.
- 06Responsabili e limiti di accesso, conservazione, buffer, destinazioni e campionamento sono documentati.
- 07Il test distingue i fatti osservati dalle ipotesi e registra quali dipendenze impediscono di riprodurre esattamente un’esecuzione.
Questioni aperte
- Le fonti fornite non permettono di stabilire quali contenuti vengano acquisiti per impostazione predefinita da ogni SDK o strumento, né di confrontare in modo esaustivo due implementazioni ufficiali; occorre consultare la documentazione della versione distribuita e testarne le esportazioni.
- Disponibilità, nome e significato degli attributi relativi a token, modello, recupero o strumenti dipendono dall’integrazione e dalla versione delle convenzioni adottata.
- Non è possibile garantire una riproduzione esatta quando il modello o le dipendenze esterne non offrono una versione o uno stato che possa essere conservato e ripristinato.
- Il punto effettivo in cui avviene l’oscuramento dipende dall’architettura: una trasformazione nel Collector può intervenire prima dell’esportazione da quel componente, ma non dimostra che il dato non sia stato acquisito o memorizzato in precedenza.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione