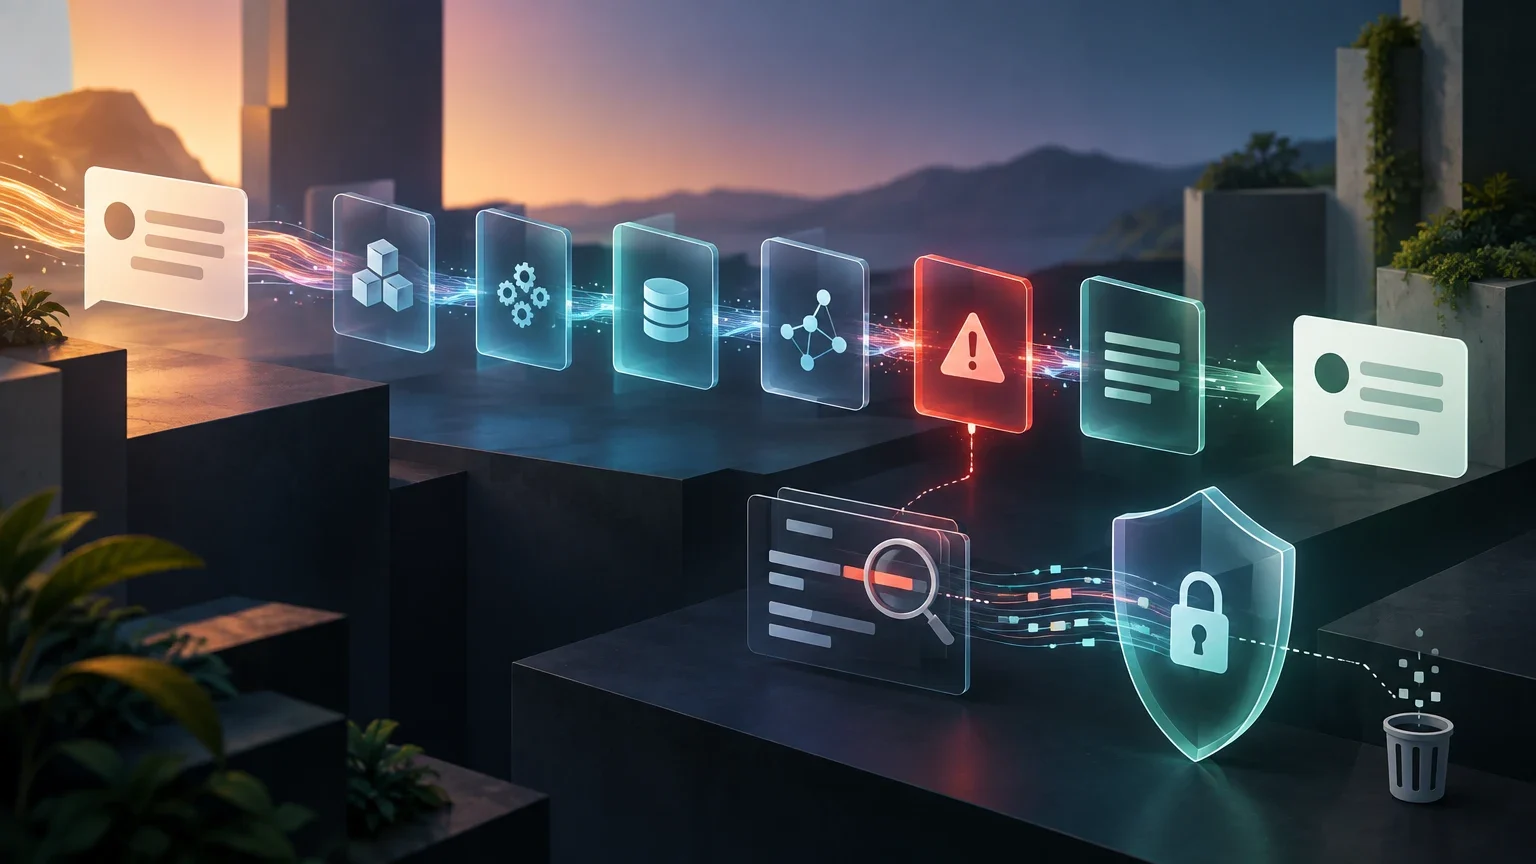
O que o rastreamento de IA resolve — e o que não comprova
Um rastreamento permite observar as operações que compõem uma solicitação e as relações entre elas. Em uma aplicação com IA, ele pode conectar a entrada recebida pelo serviço, a recuperação de documentos, uma ou mais chamadas ao modelo, a execução de ferramentas, as validações e a resposta entregue. Sua principal utilidade é reconstruir o percurso técnico: quais etapas ocorreram, em que ordem e onde houve demora, erro ou resultado inesperado.
Um rastreamento, por si só, não comprova por que um modelo gerou determinada frase, que a resposta está correta ou que uma execução futura vai repeti-la. Ele representa aquilo que o sistema instrumentado observou e decidiu registrar. Se faltarem spans, atributos ou eventos, o percurso poderá ficar incompleto. Se o conteúdo sensível for excluído, talvez também não seja possível inspecionar literalmente a entrada ou a resposta. Isso pode ser uma decisão deliberada de privacidade, e não um defeito do rastreamento.
É importante separar os fatos observados das hipóteses. “A chamada à ferramenta terminou com erro” é uma observação que pode constar da telemetria. “Esse erro causou a resposta incorreta” é uma interpretação que exige analisar o fluxo e, se possível, compará-lo com outras execuções. O rastreamento ajuda a localizar uma causa provável; não substitui testes, avaliações de qualidade nem a revisão dos dados e das instruções do sistema.
Rastreamentos, métricas e logs: sinais diferentes
Um rastreamento representa uma execução relacionada de ponta a ponta. Seus spans descrevem operações e podem ter relações de pai e filho. Por exemplo, uma operação de resposta pode conter uma recuperação e uma geração, e esta última pode incluir uma chamada a uma ferramenta. Os eventos associados a um span acrescentam ocorrências pontuais. Essa estrutura permite percorrer uma solicitação sem depender apenas da busca por mensagens de texto semelhantes.
Uma métrica resume medidas para acompanhar tendências ou estados agregados, como duração ou quantidade de erros. Ela serve para detectar mudanças e comparar grupos de execuções, mas normalmente não explica, por si só, o que aconteceu em uma solicitação específica. Evite usar identificadores exclusivos de usuário, solicitação ou documento como dimensões de métricas: eles geram alta cardinalidade e dificultam manter agregações administráveis. Use o rastreamento para obter detalhes e métricas com dimensões limitadas para o monitoramento agregado.
Um log é um evento ou uma mensagem independente, como um aviso de validação. Ele pode incluir o contexto do rastreamento para ser relacionado a uma execução, mas não necessariamente preserva a estrutura hierárquica de todas as etapas. Na prática, os três sinais se complementam: métricas para detectar uma anomalia, rastreamentos para percorrer uma execução e logs para fornecer contexto pontual. Nenhum deles exige que o conteúdo integral de uma conversa seja armazenado.
Qual sinal consultar primeiro
Decisão prática: escolha o sinal de acordo com a pergunta e limite os atributos identificáveis ao que for realmente necessário.
| Pergunta | Sinal principal | Uso recomendado |
|---|---|---|
| A latência ou os erros aumentaram? | Métrica | Observar tendências agregadas e delimitar o período afetado. |
| Quais operações esta solicitação percorreu? | Rastreamento | Inspecionar spans, relações, duração e resultado. |
| Que aviso um validador emitiu? | Log ou evento | Consultar a ocorrência e relacioná-la ao rastreamento quando houver contexto. |
Desenhe o mapa de uma solicitação
Antes de instrumentar, desenhe o fluxo real da aplicação, não aquele que se supõe que ela segue. Um percurso simples poderia começar no serviço de entrada, validar a solicitação, recuperar documentos, montar o contexto, chamar o modelo, executar uma ferramenta se necessário, validar a saída e devolver uma resposta. Pode haver novas tentativas, ramificações, chamadas paralelas ou uma segunda geração após o uso de uma ferramenta; quando forem relevantes para o diagnóstico, elas devem aparecer como operações distintas.
Uma hierarquia legível poderia ter um span raiz para a operação da aplicação e spans filhos para recuperação, geração, ferramenta e validação. A relação de pai e filho explica qual operação contém a outra; links de contexto podem relacionar operações que não se encaixam perfeitamente em uma hierarquia simples. Não é necessário criar um span para cada instrução interna: instrumente os limites em que decisões são tomadas, uma dependência é chamada ou uma operação pode falhar.
Atribua um identificador de correlação à execução e propague-o para as operações que participam dela, inclusive para serviços próprios que aceitem contexto de rastreamento. Não transforme esse identificador em parte do nome do span nem em dimensão de métrica. Os nomes devem descrever operações de maneira limitada e estável; valores exclusivos pertencem, se forem necessários e seguros, a atributos de um rastreamento sujeito a controles de acesso.
Campos mínimos para reconstruir o fluxo
O esquema mínimo deve permitir responder a quatro perguntas: que operação ocorreu? A qual execução ela pertence? Quanto tempo levou? Como terminou? Para isso, costuma ser útil registrar nomes estáveis de operações, relações entre spans, marcas de tempo ou duração, estado e uma categoria de erro. Acrescente atributos limitados que permitam distinguir, por exemplo, o tipo de operação ou o ambiente. Os atributos específicos devem corresponder à instrumentação e às convenções que a equipe realmente adotar.
Em chamadas de geração, também pode ser útil coletar informações operacionais, como o provedor ou modelo configurado, a duração, o estado e os contadores de uso disponíveis. A disponibilidade e o significado desses campos dependem da integração: não presuma que dois instrumentadores dão o mesmo nome ao mesmo dado ou o calculam da mesma maneira. Registre também se houve recuperação, uso de ferramenta, nova tentativa ou validação, com estados que distingam “não executado” de “executado e com falha”.
Para localizar um resultado defeituoso sem preservar o prompt ou cada documento, combine metadados do fluxo, quantidades e estados: número de resultados recuperados, resultado da validação, tipo de erro, versão identificável da aplicação e tempos por operação. Se for necessário comparar entradas, considere hashes ou referências internas com acesso restrito, mas avalie se eles podem ser revertidos ou permitem associar dados pessoais. Um hash não é automaticamente anônimo. Evite registrar nomes, endereços, tokens de acesso, argumentos completos de ferramentas e documentos inteiros por conveniência.
Captura mínima versus captura de conteúdo
A coluna de captura mínima é um ponto de partida de engenharia, não um conjunto universal obrigatório.
| Necessidade de diagnóstico | Possível captura mínima | Risco de ampliar a captura |
|---|---|---|
| Encontrar a etapa mais lenta | Duração por span e nome da operação | Argumentos completos podem revelar conteúdo sem melhorar a medição. |
| Saber se a recuperação retornou resultados | Estado e quantidade de resultados | Registrar documentos inteiros expõe conteúdo e dados pessoais. |
| Entender uma falha de ferramenta | Tipo de ferramenta, estado e categoria do erro | Os argumentos podem conter segredos, identificadores ou texto do usuário. |
| Comparar o comportamento de gerações | Configuração identificável, estado e uso disponível | Prompts e respostas completos ampliam a exposição e o custo de proteção. |
Conteúdo sensível: reduza, redija e controle
Prompts, respostas, documentos recuperados e argumentos de ferramentas podem incluir dados pessoais, informações confidenciais ou segredos operacionais. Trate-os como conteúdo potencialmente sensível, mesmo que a aplicação não os classifique assim. A opção mais segura para o diagnóstico habitual é não capturá-los por padrão. Se um caso de uso específico exigir trechos, defina quais trechos, quem poderá consultá-los, por quanto tempo e com qual processo de aprovação.
A redação pode remover ou substituir valores antes da exportação; a filtragem pode descartar dados ou eventos que não devem sair do processo. Defina em que ponto cada controle será aplicado e verifique seu efeito com dados de teste. Uma transformação posterior no Collector pode reduzir ou modificar a telemetria antes de exportá-la, mas isso não deve ser confundido com impedir que o conteúdo tenha sido gerado, capturado ou armazenado antes de chegar a esse componente. Revise cada etapa do percurso: instrumentador, buffer, Collector, exportador e armazenamento.
Restrinja o acesso aos rastreamentos conforme a função de trabalho e registre os acessos quando a plataforma permitir. Defina um período curto de retenção que corresponda ao tempo necessário para investigar incidentes e verifique se cópias, exportações e buffers respeitam essa política. A amostragem pode reduzir o volume, mas não substitui a proteção de cada rastreamento que for preservado. Mantenha um processo controlado para aumentar temporariamente o nível de detalhe durante uma investigação, com autorização, escopo limitado e data de encerramento.
Processo de redução antes da exportação
Aplique estes controles como referência de projeto e valide onde eles são executados na implementação concreta.
- 01Inventarie os campos produzidos por cada instrumentador, incluindo argumentos, entradas, saídas e exceções.
- 02Classifique os campos: necessários para operar, úteis apenas em investigações específicas ou desnecessários.
- 03Desative a captura de conteúdo que não seja necessária e redija ou filtre os campos aprovados antes da exportação.
- 04Teste com valores fictícios se a redação abrange spans, eventos, logs e fluxos de erro, não apenas o caso normal.
- 05Verifique destinos, permissões, buffers e prazos de exclusão; documente quem pode aumentar o nível de captura.
Leia um rastreamento para localizar o componente que falhou
Comece pelo span raiz e confirme que ele representa a execução que você quer investigar. Verifique seu estado e percorra os spans filhos em ordem cronológica. Procure lacunas entre operações, spans sem resultado ou dependências que tenham demorado mais do que o esperado em relação ao próprio histórico. Uma duração total elevada não identifica, por si só, o componente: ela pode decorrer de uma recuperação lenta, uma chamada ao modelo, espera por uma ferramenta, novas tentativas ou trabalho não instrumentado.
Se a resposta não contiver informações que deveriam ter sido recuperadas, inspecione primeiro o estado e a quantidade de resultados, os filtros de recuperação e a montagem do contexto. Se o contexto parecer adequado, mas a geração falhar ou demorar, revise o span do modelo, seu estado e as novas tentativas. Se o modelo solicitar uma ação, mas o resultado final estiver incorreto, acompanhe o span da ferramenta e verifique se ela falhou, retornou dados inesperados ou ficou fora do fluxo. Se a resposta tiver sido gerada, mas não chegar ao usuário, examine a validação e a operação que constrói a saída.
Esses percursos são hipóteses de trabalho, não regras para atribuir culpa automaticamente. Uma ferramenta pode devolver uma resposta válida que a aplicação processa incorretamente; uma validação pode rejeitar uma saída correta por causa da configuração; um rastreamento incompleto pode ocultar uma operação intermediária. Anote quais evidências sustentam cada conclusão e quais dados estão faltando. Se o diagnóstico exigir a análise de conteúdo, solicite uma captura temporária e aprovada em uma execução de teste, em vez de ativar indiscriminadamente o registro de prompts de usuários.
Repetir não significa reproduzir exatamente
Executar uma solicitação novamente pode ajudar a comparar mudanças, mas não garante que a resposta original será reproduzida. O modelo pode gerar variações; além disso, o estado da aplicação, os documentos recuperáveis, a versão do índice, o conteúdo de uma ferramenta externa ou a configuração do serviço podem ter mudado. Uma repetição posterior pode percorrer spans semelhantes e, mesmo assim, não ser uma reprodução exata.
Para tornar uma comparação mais informativa, registre de forma segura e limitada a versão da aplicação, a configuração relevante, os identificadores de modelo que a integração disponibilizar, o estado ou a versão do índice, se forem conhecidos, e as versões das ferramentas próprias. Registre também o horário e o ambiente. Se o objetivo permitir, mantenha as entradas de teste sob controle, com conteúdo sintético ou autorizado. Se uma dependência externa não fornecer uma versão ou um snapshot, declare essa limitação na análise.
Diferencie executar novamente uma solicitação no sistema atual de reproduzir uma execução histórica com as mesmas dependências e o mesmo estado. A primeira opção serve para observar o comportamento presente; a segunda exige preservar e conseguir restabelecer mais condições, o que pode ser impraticável ou inadequado se exigir a retenção de dados sensíveis. Não chame um teste de “reproduzível” apenas porque ele reutiliza o mesmo texto de entrada. Descreva o que foi mantido igual, o que pode ter mudado e qual comparação é possível sustentar.
OpenTelemetry GenAI: uma base útil, ainda em desenvolvimento
O OpenTelemetry publica convenções semânticas para sistemas de IA generativa que abrangem eventos, exceções, métricas e spans relacionados a modelos e agentes. Sua utilidade é oferecer um vocabulário compartilhado e facilitar que instrumentações diferentes representem operações comparáveis. A documentação do projeto classifica essas convenções como “Development”. Portanto, elas são uma referência útil para avaliar nomes e atributos, e não um contrato universal cuja estabilidade ou adoção completa possa ser presumida.
Antes de basear painéis, alertas ou exportações em atributos específicos, verifique a versão das convenções e a implementação usada por cada SDK. Confira quais campos são emitidos, como são nomeados, se incluem conteúdo e quais configurações alteram a captura. Dois instrumentadores podem abranger hierarquias semelhantes, mas diferir nos nomes, valores, opções de redação, exportação ou gerenciamento de buffers. Essa variação exige testar a interoperabilidade e documentar o mapeamento, em vez de presumir que ela existe.
A documentação do SDK OpenAI Agents descreve uma hierarquia de spans para agentes, gerações e ferramentas, além de opções relacionadas a dados sensíveis, exportação, buffering e redação. Ela também alerta que desativar o rastreamento não necessariamente elimina dados que já estejam em um buffer. Isso ilustra uma cautela geral: uma opção de desligamento não deve ser tratada como mecanismo de exclusão retroativa. Verifique o comportamento na versão concreta e considere todos os pontos em que os dados podem permanecer.
As fontes disponíveis não são suficientes para afirmar o que é capturado por padrão em cada SDK ou instrumentador oficial, nem para comparar exaustivamente duas implementações e suas opções. Essa resposta deve ser obtida na documentação da versão implantada e por meio de um teste controlado. Até que isso seja verificado, adote a hipótese mais prudente: inspecione o conteúdo exportado e configure explicitamente a redução de dados.
O que verificar antes de adotar uma convenção
A convenção orienta o esquema; o teste da implementação confirma o comportamento efetivo.
| Aspecto | Verificação prática | Cautela |
|---|---|---|
| Estado e versão | Identificar a versão das convenções e do SDK. | O estado de desenvolvimento pode implicar mudanças. |
| Cobertura | Comparar spans, eventos, métricas e exceções emitidos. | O nome de uma categoria não garante que todos os instrumentadores a implementem. |
| Conteúdo sensível | Inspecionar uma exportação de teste e testar a redação. | Não deduza os valores padrão a partir de uma descrição geral. |
| Exportação e buffer | Verificar o que é exportado e o que pode ficar armazenado temporariamente. | Desativar o rastreamento não equivale a apagar dados já armazenados. |
Lista de verificação para instrumentar uma aplicação
Comece com um caso de uso operacional concreto: localizar latência, falhas de recuperação, erros de ferramentas ou rejeições de validação. Desenhe o percurso e defina nomes estáveis para os spans. Verifique se o contexto se propaga entre os componentes próprios e se o rastreamento permite acompanhar a solicitação completa sem incluir identificadores exclusivos em nomes ou métricas. Registre estados e durações antes de considerar a captura de conteúdo.
Revise cada atributo com perguntas simples: que decisão operacional ele permitirá tomar? Contém informações sensíveis? Por quanto tempo precisa ser retido? Quem poderá vê-lo? Se não houver uma resposta clara, omita-o. Defina a redação e a filtragem nos pontos apropriados do fluxo e teste também exceções, novas tentativas e falhas de exportação. Configure permissões, retenção e amostragem de acordo com o risco e a necessidade de diagnóstico.
Por fim, execute testes controlados com uma recuperação vazia, um erro simulado de ferramenta, uma resposta rejeitada pela validação e um caso normal. Verifique se os spans distinguem os resultados e se nenhum segredo ou conteúdo não aprovado aparece nas exportações. Documente as limitações conhecidas, incluindo a impossibilidade de repetir exatamente dependências que mudam. Revise a política periodicamente: uma instrumentação adequada para um fluxo pode deixar de ser apropriada quando novos agentes, ferramentas ou tipos de dados forem adicionados.
Revisão operacional antes da implantação
Use esta lista como etapa de aprovação e preserve evidências dos testes realizados.
- 01Quando existirem, o percurso inclui entrada, recuperação, geração, ferramentas, validação e saída.
- 02Cada span importante tem nome estável, relação compreensível, duração e estado.
- 03As métricas usam dimensões limitadas; não incluem identificadores exclusivos de execução ou usuário.
- 04A captura de prompts, documentos e argumentos está desativada, salvo quando houver necessidade justificada e aprovada.
- 05A redação e a filtragem são testadas antes da exportação, inclusive nos fluxos de erro.
- 06Acesso, retenção, buffers, destinos e amostragem têm responsáveis e limites documentados.
- 07O teste distingue fatos observados de hipóteses e registra quais dependências impedem a reprodução exata de uma execução.
Questões em aberto
- As fontes fornecidas não permitem estabelecer qual conteúdo é capturado por padrão em cada SDK ou instrumentador, nem comparar exaustivamente duas implementações oficiais. É necessário consultar a documentação da versão implantada e testar suas exportações.
- A disponibilidade, o nome e o significado dos atributos de tokens, modelo, recuperação ou ferramentas dependem da integração e da versão das convenções adotada.
- Não é possível garantir uma reprodução exata quando o modelo ou as dependências externas não oferecem uma versão ou um estado que possa ser preservado e restabelecido.
- O ponto efetivo da redação depende da arquitetura: uma transformação no Collector pode atuar antes da exportação feita por esse componente, mas não comprova que os dados não tenham sido capturados ou armazenados antes.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção