Quale problema cerca di risolvere Agents’ Last Exam
I benchmark per agenti tendono a semplificare il lavoro professionale per poterlo misurare: una domanda con una risposta, una modifica del codice in un repository oppure un’azione isolata in un’interfaccia. Questa semplificazione può essere necessaria, ma esclude una parte importante dei flussi reali: preparare file, ispezionare informazioni locali, utilizzare più applicazioni, produrre un artefatto e lasciare uno stato finale che un’altra persona possa verificare.
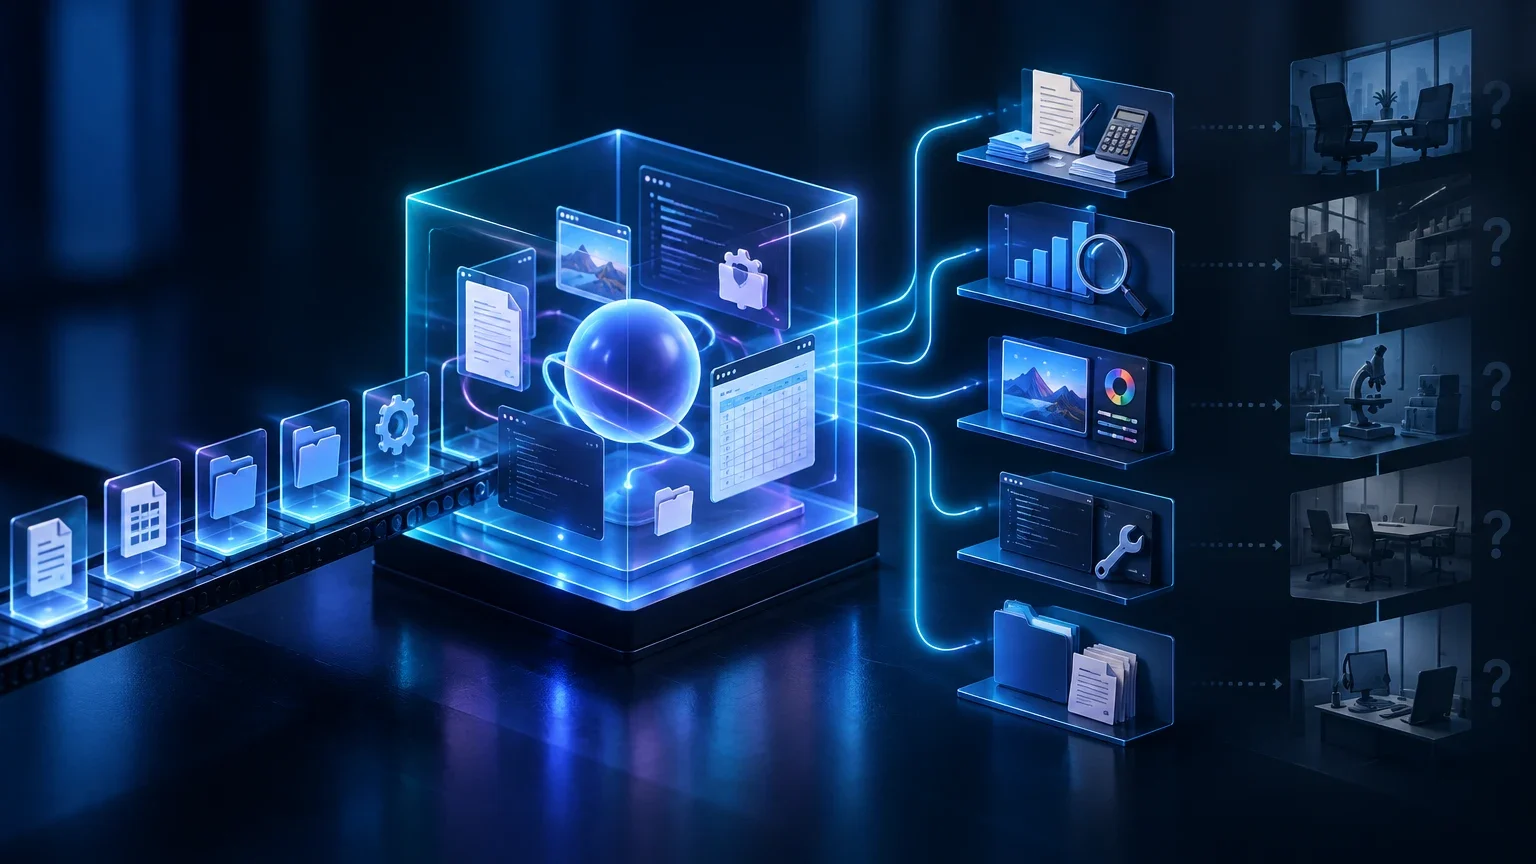
Agents’ Last Exam, comunemente abbreviato in ALE, si presenta come un framework per valutare agenti che eseguono lunghe attività professionali in ambienti di sistema operativo isolati. La documentazione descrive un’unità composta da un agente, un’attività e un ambiente sandbox. L’attività non consiste solo in un’istruzione testuale: include anche uno stato iniziale e un meccanismo per valutare il risultato prodotto dopo l’esecuzione.
Il cambiamento dell’unità di misura è rilevante. Anziché chiedere soltanto se un modello conosca una procedura, ALE mira a osservare se una configurazione concreta riesca a completare un’attività in condizioni operative definite. Questa configurazione comprende, come minimo, il modello, il ciclo dell’agente, gli strumenti esposti, l’ambiente, i vincoli di esecuzione e il valutatore. Per questo il risultato appartiene a un’esecuzione configurata, non a un modello inteso come capacità astratta.
Questo rende ALE potenzialmente più vicino a un test di flusso di lavoro rispetto a una valutazione di abilità isolata. Tuttavia, «più vicino» non significa equivalente alla pratica lavorativa. Un’occupazione combina attività non incluse, priorità mutevoli, coordinamento umano, responsabilità, accesso a sistemi interni, politiche di sicurezza e conseguenze economiche. La valutazione in una sandbox può fornire evidenze sulle prestazioni all’interno di quella sandbox senza misurare direttamente tutti questi elementi.
La reale unità di valutazione: attività, ambiente, harness e budget
Per leggere un risultato bisogna ricostruire che cosa è stato eseguito. L’attività stabilisce l’obiettivo e lo stato iniziale. L’ambiente sandbox contiene i file, le applicazioni, i dati e i vincoli con cui l’agente può interagire. L’agente decide le azioni tramite un harness, che collega il modello a strumenti quali terminale, interfaccia grafica, navigazione oppure lettura e scrittura di file. Infine, un grader ispeziona il risultato secondo criteri definiti per l’attività.
Ogni componente può modificare il risultato. Un’attività apparentemente identica può essere più semplice se l’ambiente include un’utilità preinstallata, credenziali, documentazione locale o dati già normalizzati. Può cambiare anche se l’agente riceve screenshot, accessibilità strutturata, comandi di terminale, un browser automatizzato o una combinazione di tali elementi. Confrontare due percentuali senza conoscere queste condizioni può attribuire al modello una differenza causata dall’harness o dalla sandbox.
Anche il budget fa parte dell’esperimento. Il limite di tempo, il numero massimo di passaggi, il costo consentito, la lunghezza del contesto, i tentativi ripetuti e la politica per gli errori transitori modificano la probabilità di portare a termine il compito. Un agente che necessita di molte interazioni può conseguire un risultato elevato con un budget ampio e non essere praticabile quando vi sono limiti di latenza o costo. Al contrario, un vincolo molto severo può nascondere una strategia che funzionerebbe in un processo asincrono.
Il repository ufficiale include codice, attività pubbliche e infrastruttura di esecuzione, mentre la documentazione tecnica spiega il ciclo di creazione e valutazione delle attività. È una base utile per verificare le configurazioni, ma la riproducibilità pratica richiede di registrare versioni esatte, parametri, immagini o dipendenze dell’ambiente e risultati per ciascuna ripetizione. L’esistenza del codice non garantisce che ogni esecuzione storica possa essere riprodotta senza questi dati.
Come verificare un dato ALE
- 01Identificare la versione dell’insieme di attività e la data dell’esecuzione.
- 02Determinare il sottoinsieme valutato e le attività escluse, fallite o ripetute.
- 03Registrare modello, versione, fornitore, prompt di sistema, harness e strumenti abilitati.
- 04Descrivere l’immagine sandbox, la connettività, i dati iniziali, i permessi e i limiti di isolamento.
- 05Annotare il limite di tempo, i passaggi, il budget monetario o di token e la politica di recupero dagli errori.
- 06Separare la metrica di successo completo dalla media del credito parziale e pubblicare, quando possibile, risultati per attività o per categoria.
Copertura occupazionale: 13 cluster e 55 sottodomini non sono 13 settori automatizzati
Il materiale del progetto descrive una copertura di 55 sottodomini raggruppati in 13 cluster e collega la propria tassonomia a O*NET e SOC 2018. Questa scelta serve a organizzare attività professionali eterogenee e a rendere visibile che la valutazione non si limita alla programmazione o a una sola applicazione desktop. Consente inoltre di domandarsi quali aree siano presenti e quali abbiano una rappresentazione scarsa.
La tassonomia occupazionale, tuttavia, non trasforma automaticamente una raccolta di attività in una misura delle occupazioni. O*NET classifica e descrive occupazioni, conoscenze, competenze, attività lavorative e altri attributi del lavoro; un posto reale riunisce molteplici attività con frequenza, criticità e dipendenza dal contesto differenti. Un’attività selezionata da un sottodominio può rappresentare una specifica operazione senza rappresentare l’insieme dell’occupazione associata.
Non è neppure opportuno dedurre una copertura proporzionale. L’esistenza di un cluster non rivela quante attività contenga, quale varietà interna copra, quale difficoltà abbiano i suoi casi o quale peso economico possiedano. Per valutare un proprio caso d’uso, la domanda appropriata non è se il proprio settore compaia nell’etichetta, bensì se l’insieme includa input, strumenti, eccezioni e criteri di qualità comparabili a quelli del proprio processo.
La relazione con O*NET può essere utile per la tracciabilità concettuale. Permette di discutere quali attività si sia cercato di approssimare e quali lacune restino. Ma una classificazione occupazionale non fornisce da sola un tasso di automazione, una previsione salariale o una stima della riduzione del personale. Tali conclusioni richiederebbero dati aggiuntivi su adozione, riprogettazione dei processi, supervisione, costi e prestazioni sostenute.
Che cosa si può e non si può inferire dalla copertura
| Osservazione | Inferenza ragionevole | Inferenza non giustificata |
|---|---|---|
| Esistono attività associate a 55 sottodomini e 13 cluster | Il benchmark cerca una diversità di ambiti lavorativi | Che copra integralmente ogni occupazione o settore |
| Un’attività è collegata a una tassonomia occupazionale | Esiste un riferimento per descriverne il contesto lavorativo | Che misuri la produttività complessiva di un posto |
| Un agente risolve attività di un cluster | Ha funzionato in quelle attività e condizioni | Che possa sostituire tutte le persone di quel cluster |
| Un’area ha pochi casi pubblicati | L’evidenza osservata per quell’area può essere limitata | Che l’agente sia incapace in qualsiasi flusso di quell’area |
Successo completo, credito parziale e riferimenti nascosti
La pagina dei risultati distingue tra Pass Rate e Score. Secondo tale definizione, il Pass Rate corrisponde alla proporzione di esecuzioni che ottengono un punteggio perfetto, mentre lo Score riassume il credito parziale medio. Le due metriche rispondono a domande diverse. La prima richiede che il risultato soddisfi integralmente il criterio dell’attività; la seconda può riflettere il fatto che un agente abbia fatto progressi parziali pur senza consegnare un risultato completamente valido.
Il credito parziale è informativo, soprattutto per diagnosticare dove falliscono gli agenti. Può indicare che sono stati creati file corretti ma è mancata una verifica, che è stata completata una parte della procedura oppure che il risultato finale si è avvicinato a quello atteso. Non va tuttavia presentato come successo operativo se il caso d’uso richiede una consegna integra. In una chiusura finanziaria, una migrazione di dati o un aggiornamento di conformità, una soluzione parzialmente corretta può essere inutile o persino introdurre un rischio.
La documentazione sulla creazione delle attività spiega che il riferimento usato per valutare rimane nascosto e viene materializzato per la valutazione. Il grader esegue una funzione di valutazione che restituisce un punteggio, normalmente nell’intervallo da zero a uno. Questo progetto cerca di evitare che l’agente ottenga direttamente la soluzione di riferimento disponibile al valutatore e permette di applicare verifiche deterministiche su artefatti o stati finali.
Il fatto che il grader sia deterministico non elimina tutte le decisioni di misurazione. Qualcuno deve definire quali proprietà siano controllate, quale tolleranza sia ammessa e quale risultato meriti credito parziale. Un grader può essere coerente nel ripetere lo stesso input, continuando però a misurare soltanto le condizioni formalizzate. La validità del punteggio dipende tanto da questa definizione quanto dalla capacità dell’agente di eseguire azioni.
CLI, GUI e il problema di confrontare agenti diversi
ALE contempla interazioni tramite interfaccia a riga di comando, interfaccia grafica e configurazioni che possono combinare entrambe. La modalità conta perché determina quali osservazioni e azioni siano disponibili. Nel terminale, l’agente può ispezionare strutture di file, eseguire comandi e automatizzare trasformazioni in modo compatto. In un’interfaccia grafica, deve percepire lo stato visivo, individuare controlli e gestire cambiamenti di focus, finestre, tempi di caricamento o elementi ambigui.
La leaderboard identifica sottoinsiemi, incluso ALE-CLI. Questo sottoinsieme può essere utile per studiare agenti orientati al terminale, ma non va trattato come una versione numericamente intercambiabile della valutazione completa. Un punteggio CLI esclude o riduce aspetti dell’interazione grafica; un punteggio combinato impone una richiesta diversa. Il confronto è difendibile soltanto se coincidono insieme di attività, regole, ambiente e metrica, oppure se le differenze vengono dichiarate esplicitamente.
Un agente generalista di computer use non è definito soltanto dal fatto di azionare un cursore. In termini valutativi, conta se sa osservare lo stato rilevante, selezionare strumenti, mantenere il contesto di un’attività lunga, recuperare da risultati imprevisti e verificare il proprio lavoro. Un harness che aggiunge strumenti specializzati può migliorare le prestazioni, ma allora il risultato valuta il sistema formato da modello e strumenti, non soltanto la politica del modello.
Questa cautela vale anche rispetto a Terminal-Bench, OSWorld-Verified e SWE-Bench Verified. Ogni benchmark formula una domanda diversa e utilizza attività, ambienti e metodi di verifica propri. Terminal-Bench si concentra su attività di terminale; OSWorld-Verified studia l’interazione con ambienti desktop verificati; SWE-Bench Verified è orientato alla risoluzione di issue software. Nessun risultato si trasforma automaticamente in un altro solo perché condivide un modello o l’etichetta di agente.
Regola per confrontare risultati
| Elemento | Per considerare diretto un confronto | Rischio se differisce |
|---|---|---|
| Insieme di attività | Stessa versione e stesso sottoinsieme | La differenza può derivare dalla selezione dei casi |
| Modalità | Stesso accesso a CLI, GUI e strumenti | Si misurano capacità di interazione diverse |
| Ambiente | Stessa immagine, dati iniziali, permessi e rete | Cambiano le risorse disponibili per risolvere |
| Budget | Stessi limiti di tempo, passaggi e costo | Una configurazione può esplorare di più o recuperare meglio |
| Metrica | Stessa definizione di successo e aggregazione | Pass Rate e credito parziale possono raccontare storie diverse |
Come leggere una leaderboard o un annuncio di un fornitore
Una leaderboard offre un’istantanea utile, non una garanzia indipendente di implementazione. Prima di accettare un dato, è opportuno verificare se vengano indicati la versione di ALE, il sottoinsieme, il numero di attività valutate, la metrica e il metodo di aggregazione. Dovrebbero essere inoltre disponibili l’identità precisa del modello e dell’harness, gli strumenti, i limiti di esecuzione e la politica adottata per tentativi ripetuti, guasti dell’infrastruttura o esecuzioni incomplete.
Il tasso di successo necessita di un denominatore chiaro. Non è la stessa cosa valutare tutte le attività disponibili, eseguire una selezione, omettere casi con dipendenze non risolte oppure pubblicare soltanto esecuzioni riuscite. Se vi sono più ripetizioni per attività, occorre indicare se il risultato utilizzi la media, il tentativo migliore, il primo tentativo o un’altra regola. Scegliere il migliore tra più tentativi può rispondere a una domanda di capacità massima, ma non misura l’affidabilità di una singola esecuzione.
È inoltre utile separare i fatti osservati dall’interpretazione. Un fatto è che una configurazione ha ottenuto una determinata metrica secondo le regole pubblicate. Una possibile analisi è che l’agente sembri particolarmente adatto a un certo tipo di attività. La seconda affermazione richiede l’ispezione dei risultati disaggregati, dei fallimenti e della somiglianza con il flusso di destinazione; non deriva soltanto da un dato globale.
La condizione di benchmark vivo aggiunge un’ulteriore cautela. Se cambiano le attività, il corpus pubblico, l’ambiente o i grader, un dato di una data potrebbe non essere comparabile con uno successivo. Il progetto documenta il carattere vivo di ALE e l’esistenza di un corpus pubblico. Per i risultati longitudinali, la versione e la data non sono dettagli editoriali: fanno parte del significato del dato.
Dati minimi che devono accompagnare un valore pubblicato
- 01Versione o identificatore del benchmark, data e sottoinsieme esatto.
- 02Numero di attività tentate, completate, omesse e fallite per problemi d’infrastruttura.
- 03Pass Rate, Score e regola di aggregazione utilizzata.
- 04Modello, versione, temperatura o altri parametri rilevanti e fornitore di inferenza.
- 05Harness, prompt, strumenti, permessi di rete e modalità CLI, GUI o mista.
- 06Limiti di tempo, passaggi, token e costo; numero di ripetizioni e politica di selezione.
- 07Risultati disaggregati, quando esistenti, e descrizione delle principali modalità di fallimento.
Limiti di ALE e prove mancanti prima della produzione
ALE non dimostra che un sistema sia sicuro o affidabile in una determinata organizzazione. Una sandbox riduce l’ambito e consente di verificare stati finali, ma non riproduce necessariamente identità aziendali, dati sensibili, permessi storici, integrazioni instabili, requisiti di audit o impatti sui clienti. L’assenza di accesso a sistemi reali può essere deliberata e desiderabile per misurare in modo controllato, pur limitando l’estrapolazione.
Non risolve neppure da solo il rischio di ottimizzazione rispetto al benchmark. La disponibilità di attività pubbliche e di codice facilita l’audit e la ricerca, ma può consentire a modelli, prompt o strumenti di adattarsi alle regolarità dell’insieme. I riferimenti nascosti e i grader riducono una specifica forma di perdita delle risposte, ma non dimostrano l’assenza di contaminazione nei dati di addestramento, familiarità con i pattern delle attività oppure ottimizzazione indiretta. Le evidenze disponibili non consentono di quantificare da sole questo rischio per ciascun modello.
La rappresentatività è un altro limite. Le attività sono selezionate e formalizzate; i processi reali contengono ambiguità, eccezioni, obiettivi in conflitto e standard di qualità che possono evolvere durante il lavoro. Un buon risultato è un’evidenza che l’agente ha raggiunto criteri stabiliti nelle attività selezionate. Per concludere che funzioni in un proprio processo serve una valutazione locale con dati, controlli ed errori rilevanti per quel processo.
Infine, la metrica non calcola il valore economico. La decisione di implementare dipende dal tempo di supervisione, dai tassi di correzione, dalla gravità degli errori, dal costo dell’inferenza e dell’infrastruttura, dalla velocità, dalla tracciabilità, dalla privacy e dalla responsabilità. Possono esserci casi in cui prestazioni modeste siano utili con revisione umana, e altri in cui un tasso elevato sia insufficiente perché un singolo errore ha conseguenze gravi.
Lista di controllo per un proprio caso d’uso
L’utilità di ALE aumenta quando viene usato come filtro e non come verdetto finale. Se un agente ottiene buoni risultati su attività vicine a un proprio flusso, esiste una ragione per progettare una prova interna; se non li ottiene, può esservi un segnale di rischio o una differenza di configurazione da indagare. In entrambi i casi, il trasferimento va dimostrato, non presunto.
La prova interna dovrebbe raccogliere esempi rappresentativi, inclusi casi normali, casi rari e fallimenti recuperabili. Dovrebbe valutare sia l’artefatto finale sia il percorso quando il processo richiede tracciabilità. Dovrebbe inoltre definire quando interviene una persona, quali azioni sono vietate, come si annullano le modifiche e quali metriche stabiliscono che il sistema è utile senza innalzare il rischio oltre la soglia accettabile.
Il risultato più responsabile non è una proclamazione di autonomia generale, bensì un’affermazione delimitata: una determinata configurazione può completare una proporzione osservata di attività di un insieme noto in condizioni pubblicate. ALE aiuta a formulare questa affermazione in modo più rigoroso rispetto a un esempio isolato. Non sostituisce la validazione tecnica, operativa e organizzativa necessaria per automatizzare una parte di un processo reale.
Checklist decisionale prima di estrapolare
- 01Le attività valutate assomigliano agli input, alle applicazioni e ai risultati finali del processo di destinazione?
- 02Il confronto usa la stessa modalità di interazione e gli stessi strumenti previsti nell’implementazione?
- 03Si conosce il tasso di successo completo, e non solo il credito parziale?
- 04Gli errori osservati sono correggibili con revisione umana e a quale costo?
- 05Il pilota interno misura privacy, permessi, tracciabilità, latenza e recupero?
- 06Esistono limiti espliciti per azioni irreversibili o ad alto impatto?
- 07La decisione incorpora risultati ripetuti e casi nuovi, non solo un punteggio di leaderboard?
Questioni aperte
- Non viene qui specificato il numero totale esatto di attività né la loro divisione tra pubbliche e valutabili, perché deve dipendere da una versione e da una data di riferimento concrete.
- Non viene stabilita la proporzione esatta di attività CLI, GUI o a interazione mista senza consultare la versione dell’insieme corrispondente.
- Non sono incluse cifre di modelli o posizioni nella leaderboard: senza una configurazione completa, un dato isolato avrebbe interpretabilità limitata.
- La comparabilità nel tempo può essere influenzata dal carattere vivo del benchmark, dagli aggiornamenti delle attività, degli ambienti, dei grader o del corpus pubblico.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione