Que problema o Agents’ Last Exam procura resolver
Os benchmarks de agentes costumam simplificar o trabalho profissional para que ele possa ser medido: uma pergunta com uma resposta, uma alteração de código em um repositório ou uma ação isolada em uma interface. Essa simplificação pode ser necessária, mas deixa de fora uma parte importante dos fluxos reais: preparar arquivos, inspecionar informações locais, operar vários aplicativos, produzir um artefato e deixar um estado final que outra pessoa possa verificar.
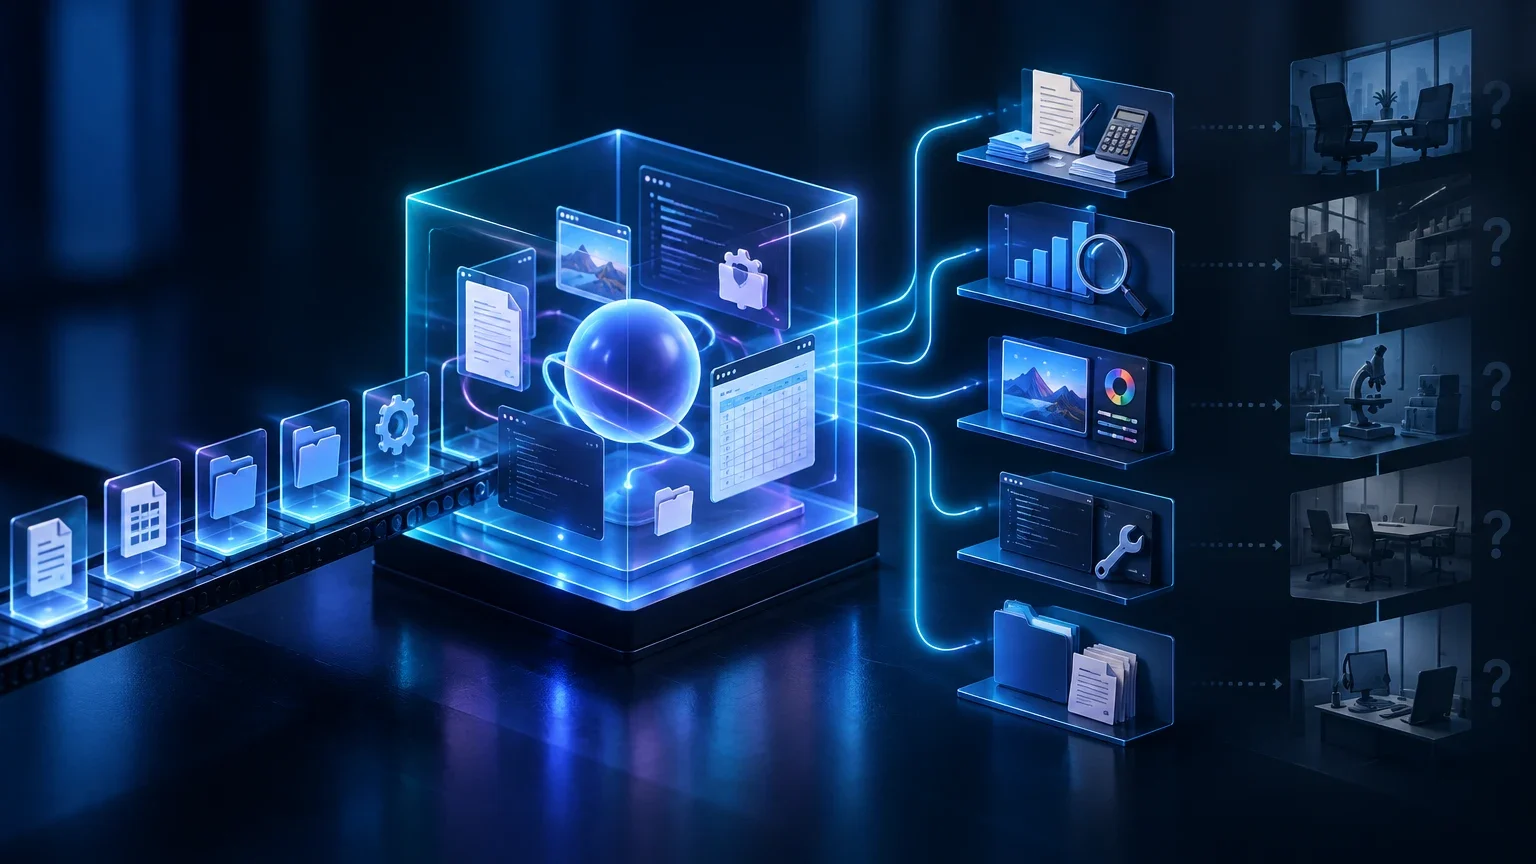
O Agents’ Last Exam, geralmente abreviado como ALE, apresenta-se como um framework para avaliar agentes que executam tarefas profissionais longas em ambientes isolados de sistema operacional. A documentação descreve uma unidade composta por um agente, uma tarefa e um ambiente sandbox. A tarefa não é apenas uma instrução textual: ela também inclui um estado inicial e um mecanismo para avaliar o resultado produzido após a execução.
A mudança na unidade de medida é relevante. Em vez de perguntar somente se um modelo conhece um procedimento, o ALE procura observar se uma configuração específica consegue concluir uma tarefa sob condições operacionais definidas. Essa configuração inclui, no mínimo, o modelo, o loop do agente, as ferramentas às quais ele tem acesso, o ambiente, as restrições de execução e o avaliador. Portanto, o resultado pertence a uma execução configurada, não a um modelo entendido como uma capacidade abstrata.
Isso faz do ALE algo potencialmente mais próximo de um teste de fluxo de trabalho do que uma avaliação de habilidade isolada. No entanto, «mais próximo» não significa equivalente à prática profissional. Um emprego combina tarefas não incluídas, prioridades variáveis, coordenação humana, responsabilidade, acesso a sistemas internos, políticas de segurança e consequências econômicas. A avaliação em um sandbox pode fornecer evidências sobre o desempenho dentro desse sandbox sem medir diretamente todos esses elementos.
A unidade real de avaliação: tarefa, ambiente, harness e orçamento
Para interpretar um resultado, é preciso reconstruir o que foi executado. A tarefa estabelece o objetivo e o estado inicial. O ambiente sandbox contém os arquivos, aplicativos, dados e restrições com os quais o agente pode interagir. O agente decide ações por meio de um harness, que conecta o modelo a ferramentas como terminal, interface gráfica, navegação ou leitura e escrita de arquivos. Por fim, um grader inspeciona o resultado de acordo com critérios definidos para a tarefa.
Cada componente pode alterar o resultado. Uma tarefa aparentemente idêntica pode ser mais simples se o ambiente incluir um utilitário pré-instalado, credenciais, documentação local ou dados já normalizados. Ela também pode mudar se o agente receber capturas de tela, acessibilidade estruturada, comandos de terminal, um navegador automatizado ou uma combinação desses recursos. Comparar dois percentuais sem conhecer essas condições pode atribuir ao modelo uma diferença causada pelo harness ou pelo sandbox.
O orçamento também faz parte do experimento. O limite de tempo, o número máximo de passos, o custo permitido, o tamanho do contexto, as tentativas adicionais e a política para erros transitórios alteram a probabilidade de conclusão. Um agente que precisa de muitas interações pode atingir um resultado alto com um orçamento amplo e não ser viável quando existem limites de latência ou custo. Por outro lado, uma restrição muito severa pode ocultar uma estratégia que funcionaria em um processo assíncrono.
O repositório oficial inclui código, tarefas públicas e infraestrutura de execução, enquanto a documentação técnica explica o ciclo de criação e avaliação de tarefas. É uma base útil para auditar configurações, mas a reprodutibilidade prática exige registrar versões exatas, parâmetros, imagens ou dependências do ambiente e resultados por repetição. A existência de código não garante que toda execução histórica possa ser reproduzida sem esses dados.
Como auditar uma métrica de ALE
- 01Identificar a versão do conjunto de tarefas e a data da execução.
- 02Determinar o subconjunto avaliado e as tarefas excluídas, que falharam ou foram repetidas.
- 03Registrar modelo, versão, fornecedor, prompts de sistema, harness e ferramentas habilitadas.
- 04Descrever a imagem do sandbox, conectividade, dados iniciais, permissões e limites de isolamento.
- 05Anotar limite de tempo, passos, orçamento monetário ou de tokens e política de recuperação diante de falhas.
- 06Separar a métrica de sucesso completo da média de crédito parcial e publicar resultados por tarefa ou categoria, quando possível.
Cobertura ocupacional: 13 clusters e 55 subdomínios não são 13 setores automatizados
O material do projeto descreve uma cobertura de 55 subdomínios agrupados em 13 clusters e relaciona sua taxonomia ao O*NET e ao SOC 2018. Essa decisão serve para organizar tarefas profissionais heterogêneas e para tornar visível que a avaliação não se limita à programação ou a um único aplicativo de desktop. Ela também permite perguntar quais áreas estão presentes e quais têm pouca representação.
A taxonomia ocupacional, contudo, não transforma automaticamente uma coleção de tarefas em uma medição de ocupações. O O*NET classifica e descreve ocupações, conhecimentos, habilidades, atividades e outros atributos do trabalho; um posto real reúne múltiplas tarefas com frequências, criticidades e dependências de contexto diferentes. Uma tarefa selecionada de um subdomínio pode representar uma operação específica sem representar o conjunto do emprego associado.
Também não convém inferir cobertura proporcional. A existência de um cluster não revela quantas tarefas ele contém, que variedade interna cobre, qual é a dificuldade de seus casos nem qual peso econômico eles têm. Para avaliar um caso de uso próprio, a pergunta adequada não é se o setor aparece no rótulo, mas se o conjunto inclui entradas, ferramentas, exceções e critérios de qualidade comparáveis aos do processo em questão.
A relação com o O*NET pode ser uma ajuda de rastreabilidade conceitual. Ela permite discutir quais atividades se tentou aproximar e quais lacunas permanecem. Porém, uma classificação ocupacional não fornece, por si só, uma taxa de automação, uma previsão salarial ou uma estimativa de redução de quadro. Essas conclusões exigiriam dados adicionais sobre adoção, redesenho de processos, supervisão, custos e desempenho sustentado.
O que pode e o que não pode ser inferido da cobertura
| Observação | Inferência razoável | Inferência não justificada |
|---|---|---|
| Há tarefas associadas a 55 subdomínios e 13 clusters | O benchmark busca diversidade de áreas de trabalho | Que ele cubra integralmente cada ocupação ou setor |
| Uma tarefa está relacionada a uma taxonomia ocupacional | Há uma referência para descrever seu contexto profissional | Que ela meça a produtividade total de um posto |
| Um agente resolve tarefas de um cluster | Ele funcionou nessas tarefas e condições | Que ele possa substituir todas as pessoas desse cluster |
| Uma área tem poucos casos publicados | A evidência observada para essa área pode ser limitada | Que o agente seja incapaz em qualquer fluxo dessa área |
Sucesso completo, crédito parcial e referências ocultas
A página de resultados distingue Pass Rate e Score. Segundo essa definição, o Pass Rate corresponde à proporção de execuções que obtêm uma pontuação perfeita, enquanto o Score resume o crédito parcial médio. As duas métricas respondem a perguntas diferentes. A primeira exige que o resultado atinja o critério completo da tarefa; a segunda pode refletir que um agente avançou parcialmente, mesmo sem entregar um resultado totalmente válido.
O crédito parcial é informativo, especialmente para diagnosticar onde os agentes falham. Ele pode indicar que arquivos corretos foram criados, mas faltou uma verificação; que parte do procedimento foi concluída; ou que o resultado final se aproximou do esperado. Ainda assim, não deve ser apresentado como sucesso operacional quando o caso de uso exige uma entrega integral. Em um fechamento financeiro, uma migração de dados ou uma atualização de conformidade, uma solução parcialmente correta pode não ter utilidade ou até introduzir risco.
A documentação de criação de tarefas explica que a referência usada para avaliar é mantida oculta e se materializa para a avaliação. O grader executa uma função de avaliação que devolve uma pontuação, normalmente no intervalo de zero a um. Esse desenho procura impedir que o agente obtenha diretamente a solução de referência disponível ao avaliador e permite aplicar verificações determinísticas sobre artefatos ou estados finais.
O fato de o grader ser determinístico não elimina todas as decisões de medição. Alguém precisa definir quais propriedades são verificadas, qual tolerância é aceita e que resultado merece crédito parcial. Um grader pode ser consistente ao repetir a mesma entrada, mas ainda medir apenas as condições formalizadas. A validade da pontuação depende tanto dessa definição quanto da capacidade do agente de executar ações.
CLI, GUI e o problema de comparar agentes diferentes
O ALE contempla interações por interface de linha de comando, interface gráfica e configurações que podem combinar ambas. A modalidade importa porque determina quais observações e ações estão disponíveis. No terminal, o agente pode inspecionar estruturas de arquivos, executar comandos e automatizar transformações de forma compacta. Em uma interface gráfica, precisa perceber o estado visual, localizar controles e lidar com mudanças de foco, janelas, tempos de carregamento ou elementos ambíguos.
O leaderboard identifica subconjuntos, incluindo o ALE-CLI. Esse subconjunto pode ser útil para estudar agentes voltados ao terminal, mas não deve ser tratado como uma versão numericamente intercambiável da avaliação completa. Uma pontuação de CLI exclui ou reduz aspectos da interação gráfica; uma pontuação combinada impõe uma exigência diferente. A comparação só é defensável se coincidirem o conjunto de tarefas, as regras, o ambiente e a métrica, ou se as diferenças forem declaradas explicitamente.
Um agente generalista de computer use não se define apenas por operar um cursor. Em termos de avaliação, importa se ele consegue observar o estado relevante, selecionar ferramentas, preservar o contexto de uma tarefa longa, recuperar-se de resultados inesperados e verificar o próprio trabalho. Um harness que acrescenta ferramentas especializadas pode melhorar o desempenho, mas então o resultado avalia o sistema formado por modelo e ferramentas, não somente a política do modelo.
Essa precaução também se aplica à comparação com Terminal-Bench, OSWorld-Verified e SWE-Bench Verified. Cada benchmark formula uma pergunta diferente e utiliza tarefas, ambientes e métodos de verificação próprios. O Terminal-Bench se concentra em tarefas de terminal; o OSWorld-Verified estuda a interação com ambientes de desktop verificados; o SWE-Bench Verified é orientado à resolução de problemas de software. Nenhum resultado se converte automaticamente em outro apenas por compartilhar um modelo ou o rótulo de agente.
Regra para comparar resultados
| Elemento | Para considerar uma comparação direta | Risco se for diferente |
|---|---|---|
| Conjunto de tarefas | Mesma versão e mesmo subconjunto | A diferença pode decorrer da seleção de casos |
| Modalidade | Mesmo acesso a CLI, GUI e ferramentas | São medidas capacidades de interação diferentes |
| Ambiente | Mesma imagem, dados iniciais, permissões e rede | Mudam os recursos disponíveis para resolver a tarefa |
| Orçamento | Mesmos limites de tempo, passos e custo | Uma configuração pode explorar mais ou recuperar-se melhor |
| Métrica | Mesma definição de sucesso e agregação | Pass Rate e crédito parcial podem contar histórias diferentes |
Como ler um leaderboard ou um anúncio de fornecedor
Um leaderboard oferece uma fotografia útil, não uma garantia independente de implantação. Antes de aceitar uma métrica, convém verificar se são informados a versão do ALE, o subconjunto, o número de tarefas avaliadas, a métrica e o método de agregação. Também devem estar disponíveis a identidade exata do modelo e do harness, as ferramentas, os limites de execução e a política adotada para repetições, falhas de infraestrutura ou execuções incompletas.
A taxa de sucesso precisa de um denominador claro. Não é o mesmo avaliar todas as tarefas disponíveis, executar uma seleção, omitir casos com dependências não resolvidas ou publicar apenas execuções bem-sucedidas. Se houver várias repetições por tarefa, deve ser indicado se o resultado usa a média, a melhor tentativa, a primeira tentativa ou alguma outra regra. Escolher a melhor entre várias tentativas pode responder a uma pergunta sobre capacidade máxima, mas não mede a confiabilidade de uma única execução.
Também convém separar fatos observados de interpretação. Um fato é que uma configuração obteve determinada métrica sob as regras publicadas. Uma análise possível é que o agente parece especialmente adequado para certo tipo de tarefa. A segunda frase requer inspeção de resultados desagregados, falhas e similaridade com o fluxo-alvo; ela não decorre apenas de uma métrica global.
A condição de benchmark vivo acrescenta outra cautela. Se as tarefas, o corpus público, o ambiente ou os graders mudarem, uma métrica de uma data pode não ser comparável a outra posterior. O projeto documenta o caráter vivo do ALE e a existência de um corpus público. Para resultados longitudinais, a versão e a data não são detalhes editoriais: elas fazem parte do significado do dado.
Dados mínimos que devem acompanhar uma métrica publicada
- 01Versão ou identificador do benchmark, data e subconjunto exato.
- 02Número de tarefas tentadas, concluídas, omitidas e que falharam por infraestrutura.
- 03Pass Rate, Score e regra de agregação utilizada.
- 04Modelo, versão, temperatura ou outros parâmetros relevantes e fornecedor de inferência.
- 05Harness, prompts, ferramentas, permissões de rede e modalidade CLI, GUI ou mista.
- 06Limites de tempo, passos, tokens e custo; número de repetições e política de seleção.
- 07Resultados desagregados, quando existirem, e descrição dos principais modos de falha.
Limites do ALE e testes necessários antes da produção
O ALE não prova que um sistema seja seguro ou confiável em uma organização específica. Um sandbox reduz o escopo e permite verificar estados finais, mas não reproduz necessariamente identidades corporativas, dados sensíveis, permissões históricas, integrações instáveis, requisitos de auditoria ou impactos sobre clientes. A ausência de acesso a sistemas reais pode ser deliberada e desejável para medir de forma controlada, embora limite a extrapolação.
Ele também não resolve sozinho o risco de otimização contra o benchmark. A disponibilidade de tarefas públicas e de código facilita auditoria e pesquisa, mas pode permitir que modelos, prompts ou ferramentas se adaptem a regularidades do conjunto. As referências ocultas e os graders reduzem uma forma específica de vazamento de respostas; não demonstram que não exista contaminação por dados de treinamento, familiaridade com padrões de tarefas ou otimização indireta. As evidências disponíveis não permitem quantificar, por si só, esse risco em cada modelo.
A representatividade é outro limite. As tarefas são selecionadas e formalizadas; os processos reais contêm ambiguidade, exceções, objetivos em conflito e padrões de qualidade que podem evoluir durante o trabalho. Um bom resultado é evidência de que o agente atingiu critérios estabelecidos nas tarefas selecionadas. Para concluir que ele funciona em um processo próprio, é necessária uma avaliação local com dados, controles e erros relevantes para esse processo.
Por fim, a métrica não calcula valor econômico. A decisão de implantar depende do tempo de supervisão, das taxas de correção, da gravidade dos erros, do custo de inferência e infraestrutura, da velocidade, da rastreabilidade, da privacidade e da responsabilidade. Pode haver casos em que um desempenho modesto seja útil com revisão humana, e outros em que uma taxa alta seja insuficiente porque uma falha isolada tem consequências graves.
Lista de verificação para um caso de uso próprio
A utilidade do ALE aumenta quando ele é usado como filtro, e não como veredito final. Se um agente obtém bons resultados em tarefas próximas a um fluxo próprio, há uma razão para desenhar um teste interno; se não os obtém, pode haver um sinal de risco ou uma diferença de configuração a investigar. Em ambos os casos, a transferência precisa ser demonstrada, não presumida.
O teste interno deveria reunir exemplos representativos, incluindo casos normais, casos raros e falhas recuperáveis. Deve avaliar tanto o artefato final quanto o percurso quando o processo exigir rastreabilidade. Também deve definir quando uma pessoa intervém, quais ações são proibidas, como as alterações são revertidas e quais métricas determinam que o sistema é útil sem elevar o risco acima do limiar aceitável.
O resultado mais responsável não é uma proclamação de autonomia geral, mas uma afirmação delimitada: uma configuração determinada pode concluir uma proporção observada de tarefas de um conjunto conhecido sob condições publicadas. O ALE ajuda a formular essa afirmação de forma mais exigente do que um exemplo isolado. Ele não substitui a validação técnica, operacional e organizacional necessária para automatizar uma parte de um processo real.
Checklist de decisão antes de extrapolar
- 01As tarefas avaliadas se parecem com as entradas, os aplicativos e as entregas do processo-alvo?
- 02A comparação usa a mesma modalidade de interação e as mesmas ferramentas que a implantação terá?
- 03A taxa de sucesso completo é conhecida, e não apenas o crédito parcial?
- 04Os erros observados podem ser corrigidos por revisão humana e a que custo?
- 05O piloto interno mede privacidade, permissões, rastreabilidade, latência e recuperação?
- 06Existem limites explícitos para ações irreversíveis ou de alto impacto?
- 07A decisão incorpora resultados repetidos e casos novos, e não apenas uma pontuação de leaderboard?
Questões em aberto
- Não se especifica aqui o total exato de tarefas nem sua divisão entre públicas e avaliáveis, pois isso deve depender de uma versão e uma data de corte específicas.
- Não se fixa a proporção exata de tarefas de CLI, GUI ou interação mista sem consultar a versão correspondente do conjunto.
- Não foram incluídos números de modelos ou posições no leaderboard: sem a configuração completa, uma métrica isolada teria interpretabilidade limitada.
- A comparabilidade ao longo do tempo pode ser afetada pelo caráter vivo do benchmark e por atualizações de tarefas, ambientes, graders ou corpus público.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção