Qué problema intenta resolver Agents’ Last Exam
Los benchmarks de agentes suelen simplificar el trabajo profesional para poder medirlo: una pregunta con una respuesta, una modificación de código en un repositorio o una acción aislada en una interfaz. Esa simplificación puede ser necesaria, pero deja fuera una parte importante de los flujos reales: preparar archivos, inspeccionar información local, operar varias aplicaciones, producir un artefacto y dejar un estado final que otra persona pueda comprobar.
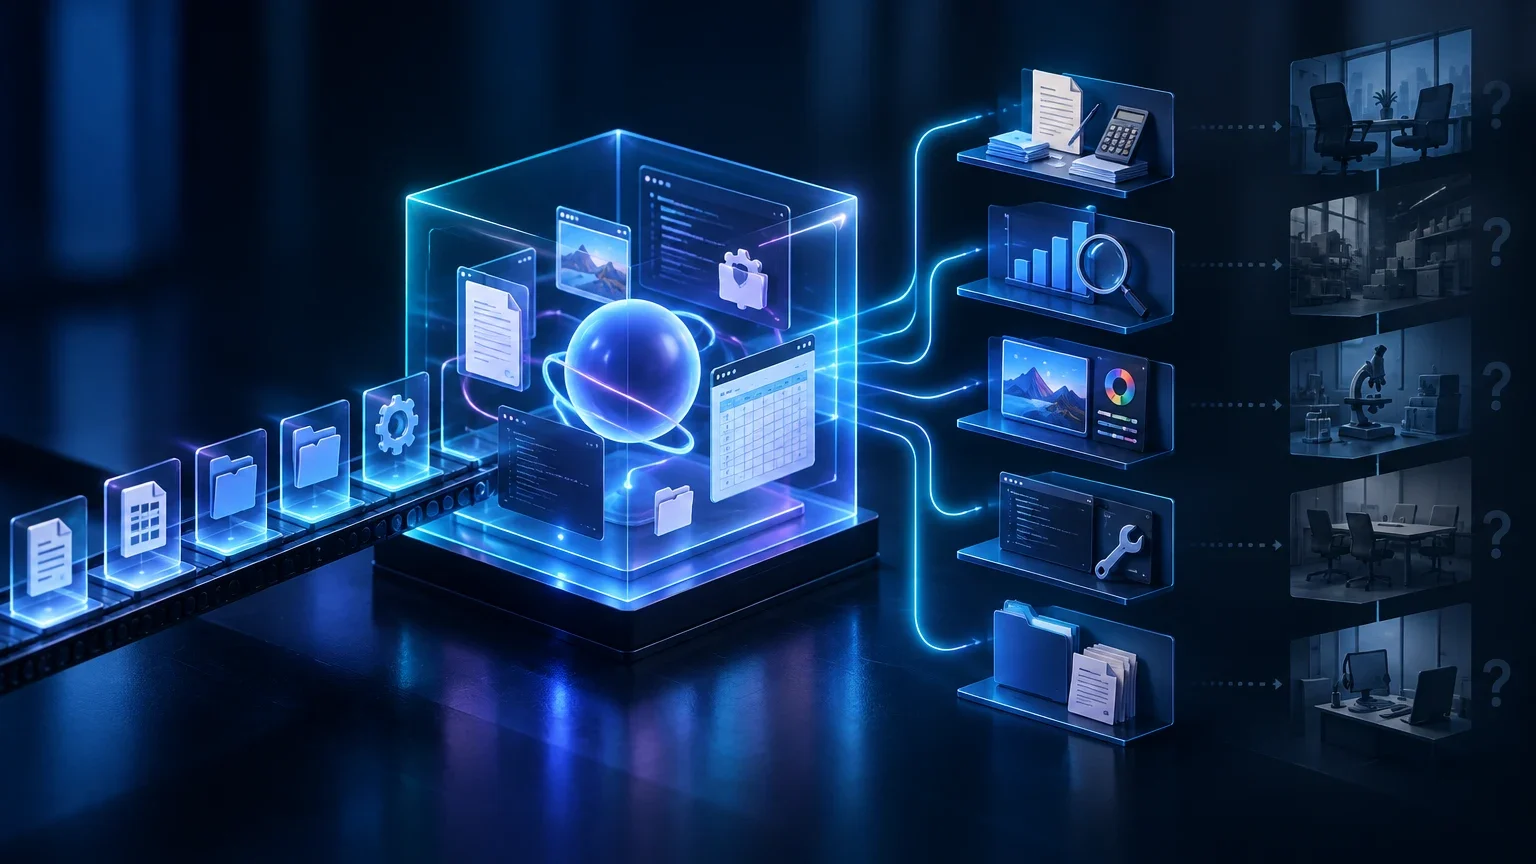
Agents’ Last Exam, habitualmente abreviado como ALE, se presenta como un marco para evaluar agentes que ejecutan tareas profesionales largas en entornos de sistema operativo aislados. La documentación describe una unidad compuesta por un agente, una tarea y un entorno sandbox. La tarea no es sólo una instrucción textual: también incluye un estado inicial y un mecanismo para valorar el resultado producido tras la ejecución.
El cambio de unidad de medida es relevante. En vez de preguntar únicamente si un modelo conoce un procedimiento, ALE pretende observar si una configuración concreta consigue completar una tarea bajo condiciones operativas definidas. Esa configuración incluye, como mínimo, el modelo, el bucle del agente, las herramientas que se le exponen, el entorno, las restricciones de ejecución y el evaluador. Por ello, el resultado pertenece a una ejecución configurada, no a un modelo entendido como una capacidad abstracta.
Esto hace que ALE sea potencialmente más cercano a una prueba de flujo de trabajo que una evaluación de habilidad aislada. Sin embargo, «más cercano» no significa equivalente a la práctica laboral. Un empleo combina tareas no incluidas, prioridades cambiantes, coordinación humana, responsabilidad, acceso a sistemas internos, políticas de seguridad y consecuencias económicas. La evaluación de un sandbox puede aportar evidencia sobre el rendimiento dentro de ese sandbox sin medir directamente todos esos elementos.
La unidad real de evaluación: tarea, entorno, arnés y presupuesto
Para leer un resultado hay que reconstruir qué se ejecutó. La tarea establece el objetivo y el estado inicial. El entorno sandbox contiene los archivos, aplicaciones, datos y restricciones con los que puede interactuar el agente. El agente decide acciones mediante un arnés o harness, que conecta el modelo con herramientas como terminal, interfaz gráfica, navegación o lectura y escritura de archivos. Finalmente, un grader inspecciona el resultado según criterios definidos para la tarea.
Cada componente puede cambiar el resultado. Una tarea aparentemente idéntica puede ser más sencilla si el entorno incluye una utilidad preinstalada, credenciales, documentación local o datos ya normalizados. También puede cambiar si el agente recibe capturas de pantalla, accesibilidad estructurada, comandos de terminal, un navegador automatizado o una combinación de ellos. Comparar dos porcentajes sin conocer estas condiciones puede atribuir al modelo una diferencia causada por el arnés o el sandbox.
El presupuesto también forma parte del experimento. El límite de tiempo, el número máximo de pasos, el coste permitido, la longitud de contexto, los reintentos y la política ante errores transitorios alteran la probabilidad de terminar. Un agente que necesita muchas interacciones puede alcanzar un resultado alto con un presupuesto amplio y no ser viable cuando hay límites de latencia o coste. A la inversa, una restricción muy severa puede ocultar una estrategia que funcionaría en un proceso asíncrono.
El repositorio oficial incluye código, tareas públicas e infraestructura de ejecución, mientras que la documentación técnica explica el ciclo de creación y evaluación de tareas. Es una base útil para auditar configuraciones, pero la reproducibilidad práctica exige registrar versiones exactas, parámetros, imágenes o dependencias del entorno y resultados por repetición. Que exista código no garantiza que toda ejecución histórica pueda reproducirse sin esos datos.
Cómo auditar una cifra de ALE
- 01Identificar la versión del conjunto de tareas y la fecha de la ejecución.
- 02Determinar el subconjunto evaluado y las tareas excluidas, fallidas o reintentadas.
- 03Registrar modelo, versión, proveedor, prompts de sistema, arnés y herramientas habilitadas.
- 04Describir imagen del sandbox, conectividad, datos iniciales, permisos y límites de aislamiento.
- 05Anotar límite de tiempo, pasos, presupuesto monetario o de tokens y política de recuperación ante fallos.
- 06Separar la métrica de éxito completo del promedio de crédito parcial y publicar resultados por tarea o por categoría cuando sea posible.
Cobertura ocupacional: 13 clústeres y 55 subdominios no son 13 sectores automatizados
El material del proyecto describe una cobertura de 55 subdominios agrupados en 13 clústeres y relaciona su taxonomía con O*NET y SOC 2018. Esta decisión sirve para organizar tareas profesionales heterogéneas y para hacer visible que la evaluación no se limita a programación o a una única aplicación de escritorio. También permite preguntar qué áreas están presentes y cuáles tienen escasa representación.
La taxonomía ocupacional, no obstante, no convierte automáticamente una colección de tareas en una medición de ocupaciones. O*NET clasifica y describe ocupaciones, conocimientos, habilidades, actividades y otros atributos laborales; un puesto real reúne múltiples tareas con distinta frecuencia, criticidad y dependencia del contexto. Una tarea seleccionada de un subdominio puede ser representativa de una operación concreta sin representar el conjunto del empleo asociado.
Tampoco conviene inferir cobertura proporcional. Que un clúster exista no revela cuántas tareas contiene, qué variedad interna cubre, qué dificultad tienen sus casos ni qué peso económico poseen. Para evaluar un caso de uso propio, la pregunta adecuada no es si su sector aparece en la etiqueta, sino si el conjunto incluye entradas, herramientas, excepciones y criterios de calidad comparables a los de su proceso.
La relación con O*NET puede ser una ayuda de trazabilidad conceptual. Permite discutir qué actividades se han intentado aproximar y qué huecos quedan. Pero una clasificación ocupacional no proporciona por sí misma una tasa de automatización, una previsión salarial ni una estimación de reducción de plantilla. Esas conclusiones requerirían datos adicionales de adopción, rediseño de procesos, supervisión, costes y rendimiento sostenido.
Qué puede y qué no puede inferirse de la cobertura
| Observación | Inferencia razonable | Inferencia no justificada |
|---|---|---|
| Hay tareas asociadas a 55 subdominios y 13 clústeres | El benchmark busca diversidad de ámbitos de trabajo | Que cubra por completo cada ocupación o sector |
| Una tarea se relaciona con una taxonomía ocupacional | Existe una referencia para describir su contexto laboral | Que mida la productividad total de un puesto |
| Un agente resuelve tareas de un clúster | Ha funcionado en esas tareas y condiciones | Que pueda sustituir a todas las personas de ese clúster |
| Un área tiene pocos casos publicados | La evidencia observada para ese área puede ser limitada | Que el agente sea incapaz en cualquier flujo de esa área |
Éxito completo, crédito parcial y referencias ocultas
La página de resultados distingue entre Pass Rate y Score. Según esa definición, el Pass Rate corresponde a la proporción de ejecuciones que obtienen una puntuación perfecta, mientras que Score resume crédito parcial medio. Las dos métricas responden a preguntas distintas. La primera exige que el resultado alcance el criterio completo de la tarea; la segunda puede reflejar que un agente avanzó parcialmente aunque no entregara un resultado totalmente válido.
El crédito parcial es informativo, especialmente para diagnosticar dónde fallan los agentes. Puede señalar que se crearon archivos correctos pero faltó una comprobación, que se completó una parte del procedimiento o que el resultado final se aproximó al esperado. Sin embargo, no debe presentarse como éxito operativo si el caso de uso exige una entrega íntegra. En un cierre financiero, una migración de datos o una actualización de cumplimiento, una solución parcialmente correcta puede no tener utilidad o incluso introducir riesgo.
La documentación de creación de tareas explica que la referencia usada para evaluar se mantiene oculta y se materializa para la evaluación. El grader ejecuta una función de evaluación que devuelve una puntuación, normalmente en el intervalo de cero a uno. Este diseño intenta evitar que el agente obtenga directamente la solución de referencia disponible para el evaluador y permite aplicar comprobaciones deterministas sobre artefactos o estados finales.
Que el grader sea determinista no elimina todas las decisiones de medición. Alguien debe definir qué propiedades se comprueban, cuál es la tolerancia admitida y qué resultado merece crédito parcial. Un grader puede ser consistente al repetir la misma entrada, pero seguir midiendo sólo las condiciones formalizadas. La validez de la puntuación depende tanto de esa definición como de la capacidad del agente para ejecutar acciones.
CLI, GUI y el problema de comparar agentes distintos
ALE contempla interacciones mediante interfaz de línea de comandos, interfaz gráfica y configuraciones que pueden combinar ambas. La modalidad importa porque determina qué observaciones y acciones están disponibles. En terminal, el agente puede inspeccionar estructuras de archivos, ejecutar comandos y automatizar transformaciones de forma compacta. En una interfaz gráfica, debe percibir el estado visual, ubicar controles y lidiar con cambios de foco, ventanas, tiempos de carga o elementos ambiguos.
El leaderboard identifica subconjuntos, incluido ALE-CLI. Ese subconjunto puede ser útil para estudiar agentes orientados a terminal, pero no debe tratarse como una versión numéricamente intercambiable de la evaluación completa. Una puntuación de CLI excluye o reduce aspectos de interacción gráfica; una puntuación combinada plantea una demanda distinta. La comparación sólo es defendible si coinciden el conjunto de tareas, las reglas, el entorno y la métrica, o si las diferencias se declaran explícitamente.
Un agente generalista de computer use no se define sólo por operar un cursor. En términos evaluativos, importa si puede observar el estado relevante, seleccionar herramientas, conservar el contexto de una tarea larga, recuperarse de resultados inesperados y verificar su propio trabajo. Un arnés que añade herramientas especializadas puede mejorar el rendimiento, pero entonces el resultado evalúa el sistema formado por modelo y herramientas, no únicamente la política del modelo.
Esta precaución también vale frente a Terminal-Bench, OSWorld-Verified y SWE-Bench Verified. Cada benchmark formula una pregunta distinta y utiliza tareas, entornos y métodos de verificación propios. Terminal-Bench se centra en tareas de terminal; OSWorld-Verified estudia interacción con entornos de escritorio verificados; SWE-Bench Verified se orienta a resolver incidencias de software. Ningún resultado se convierte automáticamente en otro por compartir un modelo o una etiqueta de agente.
Regla de comparación entre resultados
| Elemento | Para considerar una comparación directa | Riesgo si difiere |
|---|---|---|
| Conjunto de tareas | Misma versión y mismo subconjunto | La diferencia puede proceder de la selección de casos |
| Modalidad | Mismo acceso a CLI, GUI y herramientas | Se miden capacidades de interacción diferentes |
| Entorno | Misma imagen, datos iniciales, permisos y red | Cambian los recursos disponibles para resolver |
| Presupuesto | Mismos límites de tiempo, pasos y coste | Una configuración puede explorar más o recuperarse mejor |
| Métrica | Misma definición de éxito y agregación | Pass Rate y crédito parcial pueden contar historias distintas |
Cómo leer un leaderboard o un anuncio de proveedor
Un leaderboard ofrece una fotografía útil, no una garantía independiente de despliegue. Antes de aceptar una cifra, conviene comprobar si se informa de la versión de ALE, el subconjunto, el número de tareas evaluadas, la métrica y el método de agregación. También deben estar disponibles la identidad precisa del modelo y del arnés, las herramientas, los límites de ejecución y la política seguida para reintentos, fallos de infraestructura o ejecuciones incompletas.
La tasa de éxito necesita un denominador claro. No es lo mismo evaluar todas las tareas disponibles que ejecutar una selección, omitir casos con dependencias no resueltas o publicar sólo ejecuciones exitosas. Si hay varias repeticiones por tarea, debe indicarse si el resultado usa la media, el mejor intento, el primer intento o alguna otra regla. Elegir el mejor de varios intentos puede responder a una pregunta de capacidad máxima, pero no mide la fiabilidad de una ejecución única.
También conviene separar hechos observados de interpretación. Un hecho es que una configuración obtuvo una determinada métrica bajo las reglas publicadas. Un análisis posible es que el agente parece especialmente adecuado para cierto tipo de tareas. La segunda frase requiere inspeccionar resultados desagregados, fallos y similitud con el flujo objetivo; no se desprende sólo de una cifra global.
La condición de benchmark vivo añade otra cautela. Si cambian las tareas, el corpus público, el entorno o los graders, una cifra de una fecha puede no ser comparable con una posterior. El proyecto documenta el carácter vivo de ALE y la existencia de un corpus público. Para resultados longitudinales, la versión y la fecha no son detalles editoriales: son parte del significado del dato.
Datos mínimos que debe acompañar a una cifra publicada
- 01Versión o identificador del benchmark, fecha y subconjunto exacto.
- 02Número de tareas intentadas, completadas, omitidas y fallidas por infraestructura.
- 03Pass Rate, Score y regla de agregación utilizada.
- 04Modelo, versión, temperatura u otros parámetros relevantes y proveedor de inferencia.
- 05Arnés, prompts, herramientas, permisos de red y modalidad CLI, GUI o mixta.
- 06Límites de tiempo, pasos, tokens y coste; número de repeticiones y política de selección.
- 07Resultados desagregados, cuando existan, y descripción de los principales modos de fallo.
Límites de ALE y pruebas que faltan antes de producción
ALE no prueba que un sistema sea seguro o fiable en una organización concreta. Un sandbox reduce el alcance y permite verificar estados finales, pero no reproduce necesariamente identidades corporativas, datos sensibles, permisos históricos, integraciones inestables, requisitos de auditoría o impactos sobre clientes. La ausencia de acceso a sistemas reales puede ser deliberada y deseable para medir de forma controlada, aunque limita la extrapolación.
Tampoco resuelve por sí solo el riesgo de optimización contra el benchmark. La disponibilidad de tareas públicas y de código facilita auditoría e investigación, pero puede permitir que modelos, prompts o herramientas se adapten a regularidades del conjunto. Las referencias ocultas y los graders reducen una forma concreta de filtración de respuestas, no demuestran que no haya contaminación de datos de entrenamiento, familiaridad con patrones de tareas u optimización indirecta. La evidencia disponible no permite cuantificar por sí sola ese riesgo en cada modelo.
La representatividad es otro límite. Las tareas se seleccionan y formalizan; los procesos reales contienen ambigüedad, excepciones, objetivos en conflicto y estándares de calidad que pueden evolucionar durante el trabajo. Un buen resultado es evidencia de que el agente alcanzó criterios establecidos en las tareas seleccionadas. Para concluir que funciona en un proceso propio hace falta una evaluación local con datos, controles y errores relevantes para ese proceso.
Por último, la métrica no calcula valor económico. La decisión de desplegar depende de tiempo de supervisión, tasas de corrección, severidad de errores, coste de inferencia e infraestructura, velocidad, trazabilidad, privacidad y responsabilidad. Puede haber casos en los que un rendimiento modesto sea útil con revisión humana, y otros en los que una tasa alta sea insuficiente porque un fallo aislado tiene consecuencias graves.
Lista de comprobación para un caso de uso propio
La utilidad de ALE aumenta cuando se utiliza como filtro y no como veredicto final. Si un agente obtiene buenos resultados en tareas cercanas a un flujo propio, hay una razón para diseñar una prueba interna; si no los obtiene, puede haber una señal de riesgo o una diferencia de configuración que investigar. En ambos casos, la transferencia debe demostrarse, no asumirse.
La prueba interna debería recoger ejemplos representativos, incluidos casos normales, casos raros y fallos recuperables. Debe evaluar tanto el artefacto final como el recorrido cuando el proceso requiera trazabilidad. También debe definir cuándo interviene una persona, qué acciones están prohibidas, cómo se revierten cambios y qué métricas determinan que el sistema es útil sin elevar el riesgo por encima del umbral aceptable.
El resultado más responsable no es una proclamación de autonomía general, sino una afirmación acotada: una configuración determinada puede completar una proporción observada de tareas de un conjunto conocido bajo condiciones publicadas. ALE ayuda a formular esa afirmación de forma más exigente que un ejemplo aislado. No reemplaza la validación técnica, operativa y organizativa necesaria para automatizar una parte de un proceso real.
Checklist de decisión antes de extrapolar
- 01¿Las tareas evaluadas se parecen a las entradas, aplicaciones y entregables del proceso objetivo?
- 02¿La comparación usa la misma modalidad de interacción y herramientas que tendrá el despliegue?
- 03¿Se conoce la tasa de éxito completo, no sólo el crédito parcial?
- 04¿Los errores observados son corregibles mediante revisión humana y con qué coste?
- 05¿El piloto interno mide privacidad, permisos, trazabilidad, latencia y recuperación?
- 06¿Existen límites explícitos para acciones irreversibles o de alto impacto?
- 07¿La decisión incorpora resultados repetidos y casos nuevos, no sólo una puntuación de leaderboard?
Qué sigue abierto
- No se especifica aquí el total exacto de tareas ni su división entre públicas y evaluables, porque debe depender de una versión y fecha de corte concretas.
- No se fija la proporción exacta de tareas de CLI, GUI o interacción mixta sin consultar la versión del conjunto correspondiente.
- No se han incluido cifras de modelos o posiciones del leaderboard: sin configuración completa, una cifra aislada tendría interpretabilidad limitada.
- La comparabilidad temporal puede verse afectada por el carácter vivo del benchmark, actualizaciones de tareas, entornos, graders o corpus público.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección