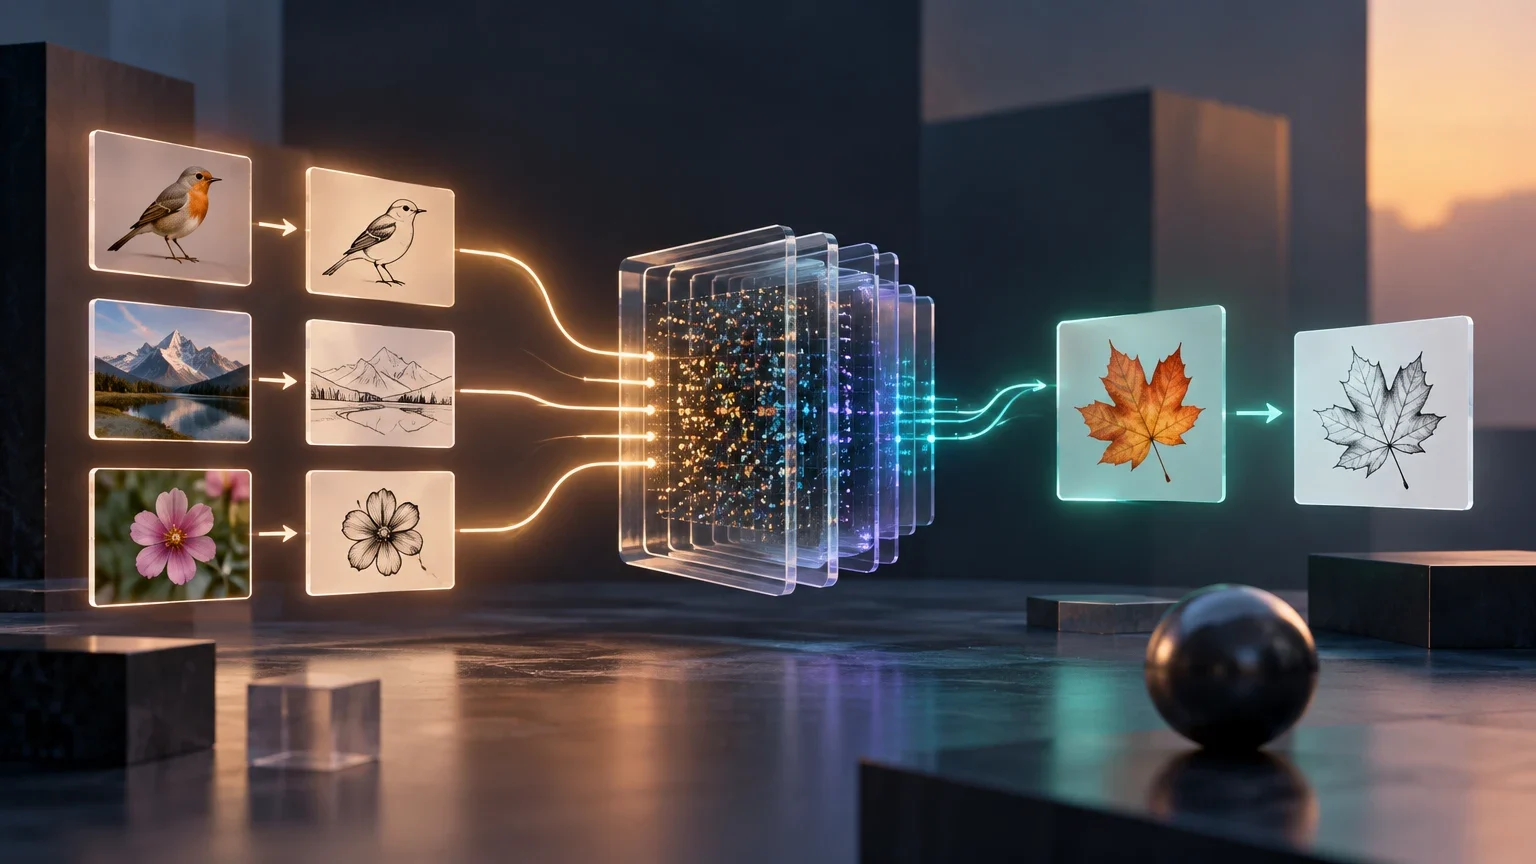
Definizione in una frase
Uso di pochi esempi all'interno della richiesta per mostrare al modello il compito, il criterio o il formato atteso.
Definizione: few-shot prompting come tecnica di progettazione del contesto
Il few-shot prompting è una tecnica di progettazione dei prompt che consiste nel fornire a un modello linguistico di grandi dimensioni (LLM) diversi esempi già svolti, all’interno della stessa istruzione. Lo scopo è orientare il modello verso un formato, un tono o una struttura di output specifici, senza avviare un addestramento aggiuntivo né modificare i parametri interni del modello.
A differenza dell’apprendimento supervisionato tradizionale, nel quale il modello viene adattato usando un insieme di dati di addestramento, il few-shot prompting opera durante l’inferenza. Le informazioni degli esempi vengono elaborate temporaneamente nella finestra di contesto. La distinzione è importante: il modello non conserva stabilmente gli esempi, ma li usa come condizionamento per generare la risposta al nuovo input.
Questa tecnica si distingue nettamente dall'ingegneria del contesto tradizionale, che si concentra principalmente sulla formulazione delle istruzioni o sulla strutturazione dei vincoli logici. Nel few-shot prompting, l'attenzione si sposta sulla dimostrazione pratica: gli esempi fungono da ancoraggio semantico che riduce l'ambiguità intrinseca della richiesta. Questo approccio è particolarmente rilevante quando il modello deve aderire a convenzioni specifiche che non sono esplicitamente descritte nelle istruzioni, ma implicite nella struttura degli output forniti. La capacità di generalizzare da pochi casi concreti permette di guidare il comportamento del modello in modo più diretto rispetto alla sola descrizione testuale del compito desiderato.
Meccanismo tecnico: in-context learning (ICL)
Il meccanismo è noto come in-context learning (ICL). Quando riceve un prompt con esempi, il modello elabora la nuova richiesta insieme alle coppie input-output fornite. Può sfruttare le relazioni apprese tra gli elementi della sequenza per individuare schemi strutturali, semantici e di formato e applicarli alla richiesta finale.
Le ricerche, tra cui quella di Min et al. (2022), suggeriscono che il formato e la distribuzione delle etichette negli esempi possono influire sul comportamento del modello, anche quando le etichette dei singoli esempi non sono corrette. Questo non significa che la correttezza degli esempi sia irrilevante: indica piuttosto che anche la struttura dei dati mostrati può condizionare l’output. Il modello segue una dimostrazione nel contesto, senza eseguire un aggiornamento dei pesi tramite discesa del gradiente.
È importante sottolineare che il meccanismo di in-context learning non implica una modifica permanente della conoscenza del modello, ma un adattamento dinamico e contestuale. La ricerca di Min et al. (2022) evidenzia come la coerenza strutturale degli esempi possa essere determinante, suggerendo che il modello possa estrarre regolarità formali indipendentemente dalla correttezza semantica individuale di ogni singolo caso. Questo fenomeno indica che l'architettura del modello è in grado di riconoscere pattern ricorrenti nella sequenza di token, utilizzandoli come guida per la generazione successiva. Tuttavia, questa sensibilità alla struttura non sostituisce la necessità di esempi pertinenti e rappresentativi del dominio specifico, poiché la qualità del condizionamento dipende dalla pertinenza dei dati forniti nel contesto immediato.
Il flusso dell’in-context learning
Gli esempi vengono inseriti nella finestra di contesto e concorrono alla generazione della risposta.
- 01L’utente fornisce un’istruzione e una serie di coppie input-output, o esempi.
- 02Il modello elabora l’intera sequenza, compresi gli esempi, attraverso i suoi strati di calcolo e attenzione.
- 03Le relazioni tra gli input degli esempi e i rispettivi output possono contribuire a definire il formato o il comportamento richiesto.
- 04Il modello genera una risposta al nuovo input, cercando di seguire lo schema suggerito dagli esempi.
Tre esempi applicativi in ambiti diversi
Il few-shot prompting può essere usato per classificare testi, estrarre informazioni e generare codice. I tre esempi seguenti mostrano come inserire dimostrazioni nel prompt e specificare il tipo di risposta atteso. Sono modelli illustrativi: il risultato effettivo dipende dal modello, dal prompt e dagli input.
Nel supporto clienti, gli esempi definiscono le etichette per classificare il sentiment. Nell’estrazione da fatture, mostrano come trasformare testo libero in campi JSON. Nella generazione di codice, indicano convenzioni di denominazione e uno stile di implementazione. In tutti e tre i casi, è utile verificare le risposte prima di usarle in un processo operativo.
Nei tre ambiti illustrati, la selezione degli esempi gioca un ruolo cruciale nel definire il perimetro della risposta attesa. Per la classificazione del sentiment, la chiarezza delle etichette e la varietà dei casi limite mostrati aiutano il modello a distinguere sfumature emotive sottili. Nell'estrazione di dati da fatture, la precisione nel mappatura dei campi testuali verso la struttura JSON riduce il rischio di allucinazioni o errori di formato. Nella generazione di codice, la coerenza stilistica degli esempi guida il modello verso una sintassi e una nomenclatura specifiche, facilitando l'integrazione del codice generato in ambienti di sviluppo esistenti. In tutti questi casi, la verifica manuale dei risultati rimane un passaggio fondamentale per garantire l'affidabilità dell'output in contesti operativi reali.
Confusioni frequenti: differenze rispetto alle tecniche correlate
Il few-shot prompting viene spesso confuso con altre tecniche di adattamento dei modelli. La distinzione più immediata riguarda il numero di esempi: zero-shot non ne include, one-shot ne include uno e few-shot ne include più di uno. Non esiste però una soglia universale che stabilisca quanti esempi siano “pochi”: il numero utile dipende dal modello, dal compito e dallo spazio disponibile nel contesto.
Il fine-tuning è diverso perché comporta un addestramento che aggiorna i pesi del modello a partire da dati. Il prompting usa invece esempi temporanei nella richiesta. La catena del pensiero (chain-of-thought) è una strategia per strutturare il ragionamento o mostrare passaggi intermedi; non è un sinonimo di few-shot e può essere combinata con esempi. Nessuna di queste tecniche garantisce, da sola, risposte corrette.
La distinzione tra few-shot prompting e fine-tuning è fondamentale per la pianificazione delle risorse computazionali e dei tempi di sviluppo. Mentre il fine-tuning richiede un processo di addestramento che può essere costoso e lungo, il few-shot prompting offre una soluzione immediata e flessibile, ideale per prototipazione rapida o per compiti che non richiedono una personalizzazione profonda del modello. La catena del pensiero, invece, si integra con il few-shot per affrontare problemi che necessitano di passaggi logici intermedi, combinando la guida strutturale degli esempi con la trasparenza del ragionamento. La scelta tra queste tecniche dipende dalla complessità del compito, dalla disponibilità di dati di addestramento e dai requisiti di precisione e latenza del sistema finale.
Confronto tra tecniche
Una guida sintetica alle differenze operative; costi e risultati variano a seconda del modello e dell’applicazione.
| Tecnica | Esempi nel prompt | Aggiorna i pesi? | Impiego indicativo |
|---|---|---|---|
| Zero-shot | Nessuno | No | Richieste che il modello può gestire con la sola istruzione |
| One-shot | Uno | No | Mostrare un esempio di formato o comportamento |
| Few-shot | Più di uno | No | Suggerire formati, classificazioni o schemi d’output |
| Fine-tuning | Dati di addestramento, non esempi temporanei nel prompt | Sì | Adattare il modello attraverso un processo di addestramento |
| Catena del pensiero | Non è definita dal numero di esempi | No, di per sé | Strutturare richieste che richiedono passaggi di ragionamento |
Limiti operativi e aspetti da verificare
La finestra di contesto limita la quantità di testo che il modello può elaborare in una richiesta. Gli esempi occupano spazio insieme all’istruzione e all’input da risolvere; se diventano troppo lunghi o numerosi, possono lasciare meno spazio al compito o superare il limite disponibile. Inoltre, includere più testo può aumentare il consumo di token e incidere su tempi e costi, secondo le condizioni del servizio utilizzato.
La qualità e la pertinenza degli esempi contano: esempi poco rappresentativi o incoerenti possono indirizzare il modello verso uno schema indesiderato. Anche l’ordine può incidere in alcuni compiti e modelli, ma non esiste una regola valida in ogni situazione. Conviene testare più configurazioni su input rappresentativi. Infine, gli esempi non garantiscono la generalizzazione: il modello può sbagliare quando incontra casi che si discostano da quelli mostrati. Per problemi di ragionamento complessi, il few-shot da solo può non bastare.
La gestione della finestra di contesto richiede un bilanciamento attento tra la quantità di esempi e lo spazio residuo per l'input utente e l'output generato. Un eccesso di esempi può saturare il contesto, riducendo la capacità del modello di elaborare correttamente la richiesta principale o di generare una risposta completa. Inoltre, la sensibilità all'ordine degli esempi, sebbene variabile tra modelli e compiti, suggerisce la necessità di testare diverse configurazioni per identificare la sequenza più efficace. La qualità degli esempi è altrettanto critica: esempi contraddittori o poco rappresentativi possono introdurre bias o confondere il modello, portando a risultati incoerenti. Pertanto, la progettazione del prompt deve essere iterativa, basata su test empirici e su una valutazione continua delle prestazioni del modello su input rappresentativi del dominio applicativo.