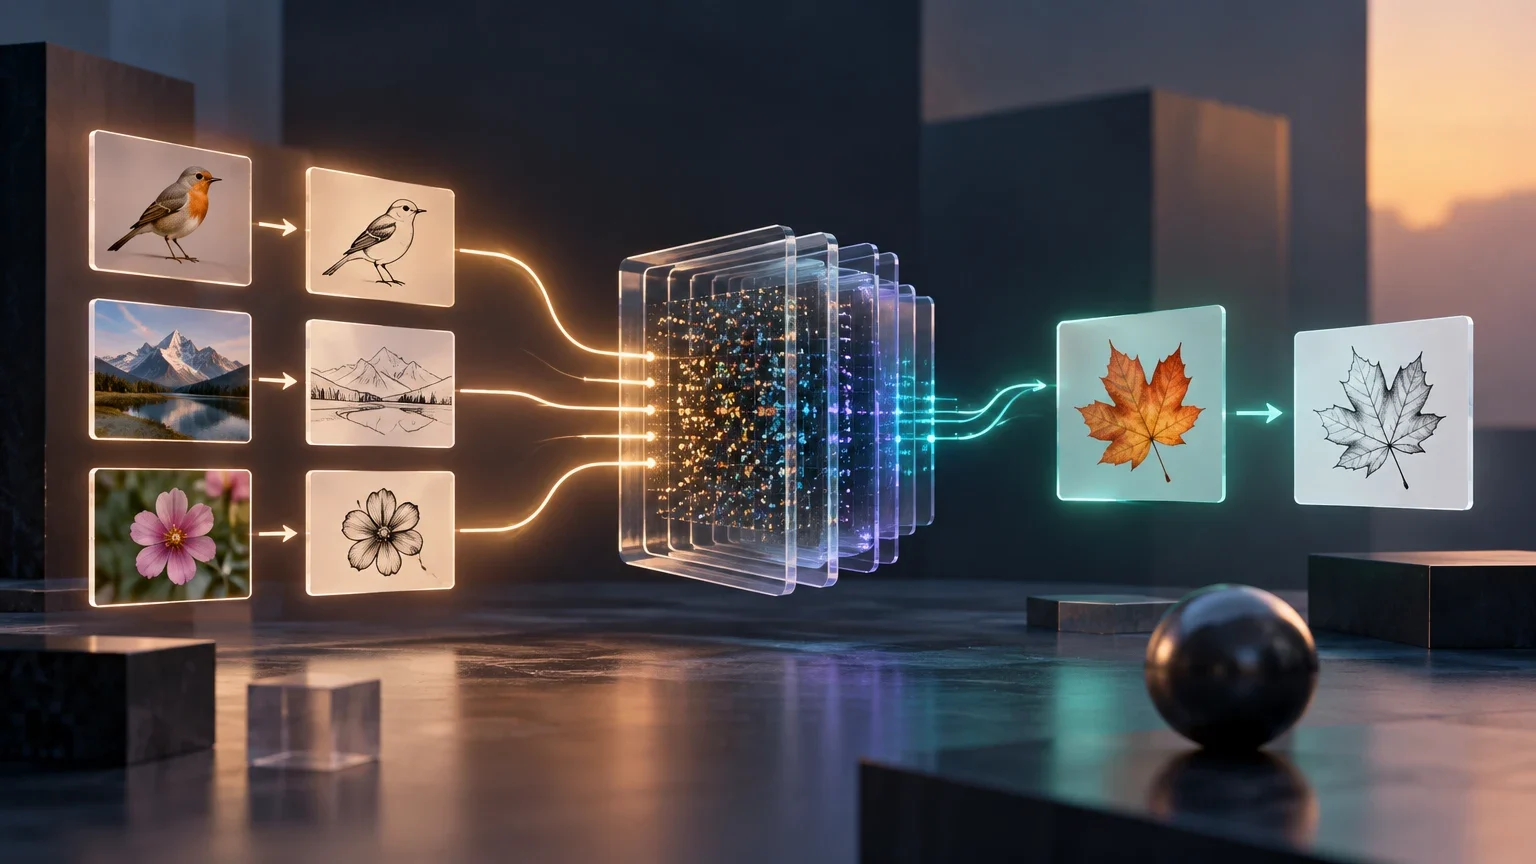
Definición en una frase
Uso de unos pocos ejemplos dentro de la petición para mostrar al modelo la tarea, el criterio o el formato esperado.
Definición: Few-shot prompting como técnica de ingeniería de contexto
El few-shot prompting es una técnica de ingeniería de prompts que consiste en proporcionar a un modelo de lenguaje de gran tamaño (LLM) varios ejemplos resueltos de una tarea dentro de la misma instrucción. El objetivo es guiar el rendimiento del modelo hacia un formato, tono o estructura de salida específica sin necesidad de realizar un entrenamiento adicional o de actualizar los parámetros internos del modelo.
A diferencia del aprendizaje supervisado tradicional, donde el modelo se ajusta mediante un conjunto de datos de entrenamiento, el few-shot prompting opera exclusivamente en la fase de inferencia. La información de los ejemplos se procesa temporalmente dentro de la ventana de contexto. Esta distinción es fundamental: el modelo no 'memoriza' los ejemplos de forma permanente, sino que los utiliza como condicionamiento para generar la respuesta a la nueva entrada.
Esta naturaleza efímera del few-shot prompting implica que la consistencia de los resultados depende enteramente de la calidad y la estructura de los ejemplos proporcionados en cada interacción individual. Dado que no hay un proceso de retropropagación de errores ni de ajuste de parámetros, el modelo no puede corregir sus propios sesgos internos a lo largo del tiempo basándose en el feedback de las respuestas anteriores. Por lo tanto, la ingeniería de contexto se convierte en una disciplina de precisión donde la formulación de los ejemplos debe ser tan rigurosa como si se estuviera diseñando un conjunto de datos de entrenamiento, pero con la restricción adicional de que todo debe caber en la ventana de atención activa del modelo.
Mecanismo técnico: In-context learning (ICL)
El mecanismo subyacente se conoce como in-context learning (ICL). Cuando el modelo recibe un prompt con ejemplos, la arquitectura de transformadores utiliza el mecanismo de atención para relacionar la nueva entrada con los pares entrada-salida proporcionados. El modelo identifica patrones estructurales, semánticos y de formato en los ejemplos y los aplica a la consulta final.
Investigaciones, como las de Min et al. (2022), sugieren que el modelo es sensible al formato y a la distribución de las etiquetas más que a la corrección individual de cada ejemplo. Esto implica que la coherencia estructural de los ejemplos es tan importante como su contenido semántico. El modelo 'aprende' la tarea por demostración, mapeando la estructura de los ejemplos a la nueva entrada sin realizar un cálculo de gradiente.
Es importante matizar que, aunque el mecanismo de atención es el componente arquitectónico principal facilitador, la investigación actual sugiere que el in-context learning no se explica de manera exclusiva por la simple correlación estadística entre tokens. Existen hipótesis que apuntan a que el modelo realiza una forma de inferencia bayesiana implícita, donde los ejemplos actúan como evidencia que actualiza la distribución de probabilidad de las salidas posibles. Esto significa que la 'aprendizaje' no es un mapeo mecánico de entrada a salida, sino un proceso de ponderación dinámica donde la relevancia de cada ejemplo puede variar dependiendo de la proximidad semántica y estructural con la consulta final, lo que añade una capa de complejidad a la predicción del comportamiento del modelo.
Flujo del In-Context Learning
Proceso por el cual el modelo integra los ejemplos en la ventana de contexto para generar la salida.
- 01El usuario proporciona una instrucción base y una serie de pares entrada-salida (shots).
- 02El modelo procesa la secuencia completa, incluyendo los ejemplos, mediante capas de atención.
- 03El mecanismo de atención identifica correlaciones entre las entradas de los ejemplos y sus salidas correspondientes.
- 04El modelo genera la salida para la nueva entrada, imitando el patrón establecido por los ejemplos.
Ejemplos aplicados en tres ámbitos distintos
La versatilidad del few-shot prompting permite su aplicación en tareas de clasificación, extracción de datos y generación de código. A continuación se detallan tres casos de uso concretos que ilustran cómo se construye el prompt y qué se espera de la salida.
En la clasificación de sentimiento para soporte técnico, los ejemplos definen las categorías (positivo, negativo, neutral) y el formato de respuesta. En la extracción de datos estructurados de facturas, los ejemplos muestran cómo mapear texto no estructurado a campos JSON específicos. En la generación de código, los ejemplos establecen el estilo de programación, la nomenclatura y las prácticas de error handling deseadas.
La selección de los ejemplos para estos tres ámbitos no es arbitraria; debe reflejar la diversidad de la distribución de datos esperada en producción. En la clasificación de sentimiento, por ejemplo, incluir solo ejemplos extremos (muy positivos o muy negativos) puede llevar al modelo a clasificar como neutrales aquellos mensajes con matices ambiguos. Del mismo modo, en la extracción de datos de facturas, los ejemplos deben cubrir variaciones en el formato de las fechas y en la notación de las monedas para evitar que el modelo generalice incorrectamente un patrón específico. En la generación de código, la inclusión de ejemplos que muestren el manejo de errores y la validación de entradas es crucial para que el código generado no sea solo funcional, sino también robusto y seguro, alineándose con las mejores prácticas de ingeniería de software.
Confusiones frecuentes: Diferencias con técnicas relacionadas
Es común confundir el few-shot prompting con otras técnicas de adaptación de modelos. La diferencia principal radica en si se actualizan los pesos del modelo y en la cantidad de ejemplos utilizados. El zero-shot prompting no incluye ejemplos, el one-shot incluye uno, y el few-shot incluye varios (generalmente entre 2 y 10).
El fine-tuning, por el contrario, implica un proceso de entrenamiento donde los pesos del modelo se ajustan mediante un conjunto de datos. El few-shot prompting es más rápido y barato, pero menos preciso para tareas muy específicas o complejas. La cadena de pensamiento (Chain-of-Thought) es una técnica complementaria que puede combinarse con few-shot para mejorar el razonamiento lógico, no una alternativa directa.
La elección entre estas técnicas no es binaria, sino que a menudo implica una estrategia híbrida. Por ejemplo, se puede utilizar el few-shot prompting para definir el formato de salida y el tono de voz, mientras que se emplea el fine-tuning para inculcar conocimientos de dominio específicos que no están presentes en el preentrenamiento del modelo. Esta combinación permite aprovechar la flexibilidad y el bajo coste de la ingeniería de contexto para tareas de formato, y la profundidad del ajuste fino para tareas de conocimiento. Sin embargo, esta estrategia híbrida requiere una gestión cuidadosa de los recursos, ya que el fine-tuning introduce una dependencia de la infraestructura de GPU y un ciclo de desarrollo más largo, lo que debe equilibrarse con la agilidad que ofrece el few-shot prompting en la fase de prototipado.
Comparativa de técnicas de adaptación
Tabla de decisión para elegir la técnica adecuada según los recursos y la complejidad de la tarea.
| Técnica | Ejemplos en prompt | Actualización de pesos | Coste computacional | Uso recomendado |
|---|---|---|---|---|
| Zero-shot | 0 | No | Bajo | Tareas simples y genéricas |
| One-shot | 1 | No | Bajo | Clarificación de formato básico |
| Few-shot | 2-10 | No | Medio (tokens) | Formatos específicos, tono, extracción |
| Fine-tuning | N/A (Dataset) | Sí | Alto (GPU) | Tareas complejas, alto volumen, precisión extrema |
Límites operativos y consideraciones prácticas
El few-shot prompting no está exento de limitaciones. La ventana de contexto del modelo limita la cantidad de ejemplos que pueden incluirse; si los ejemplos son demasiado largos, se puede exceder el límite de tokens, lo que impide procesar la consulta completa. Además, el coste en tokens aumenta linealmente con el número de ejemplos, lo que puede impactar en la latencia y los costos de API.
La sensibilidad al orden y a la calidad de los ejemplos es un factor crítico. Estudios han mostrado que el orden de los ejemplos puede influir en la salida del modelo, y ejemplos contradictorios o de baja calidad pueden degradar el rendimiento. No existe una garantía de generalización: el modelo puede fallar en entradas que difieren significativamente de los ejemplos proporcionados. Para tareas de razonamiento complejo, el few-shot por sí solo puede ser insuficiente, requiriendo técnicas avanzadas como Chain-of-Thought.
La gestión de la ventana de contexto requiere una estrategia de priorización de información. Cuando el número de ejemplos necesarios para cubrir la diversidad de la tarea excede el límite de tokens disponible, es necesario resumir o seleccionar cuidadosamente los ejemplos más representativos. Esto puede lograrse mediante técnicas de muestreo estratificado, donde se asegura que cada categoría o tipo de entrada esté representada al menos una vez. Además, la compresión de los ejemplos, eliminando redundancias y manteniendo solo la estructura esencial, puede ayudar a maximizar la cantidad de información útil que cabe en la ventana de contexto. Esta optimización es crítica para mantener la calidad de la salida sin incurrir en costes de API excesivos o en tiempos de latencia inaceptables.