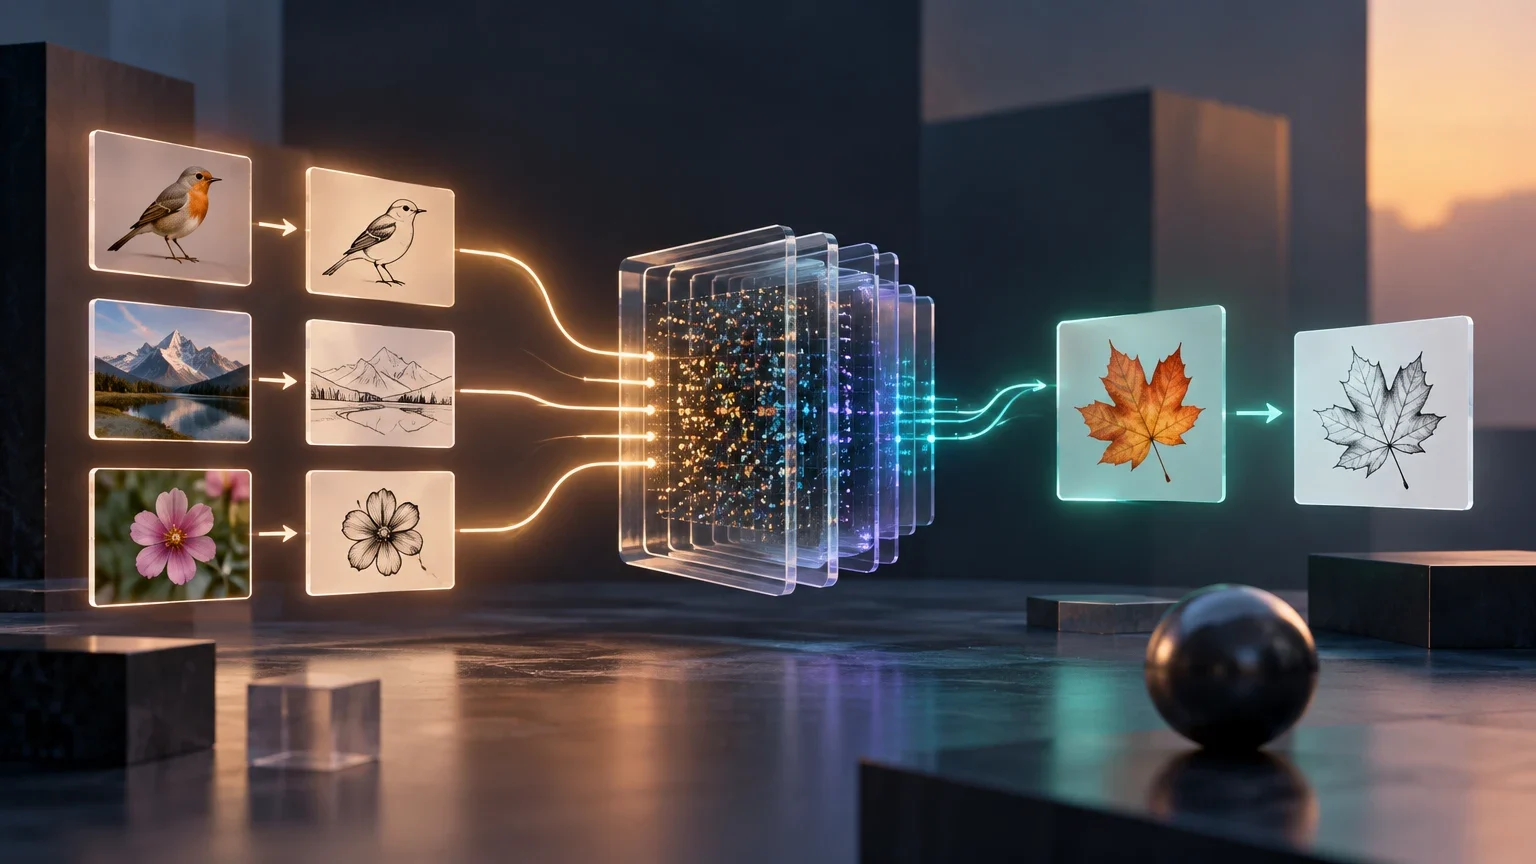
Définition en une phrase
Utilisation de quelques exemples dans la requête pour montrer au modèle la tâche, le critère ou le format attendu.
Définition : Le few-shot prompting comme technique d'ingénierie de contexte
Le few-shot prompting est une technique d'ingénierie de prompts qui consiste à fournir à un grand modèle de langage (LLM) plusieurs exemples résolus d'une tâche au sein de la même instruction. L'objectif est d'orienter les performances du modèle vers un format, un ton ou une structure de sortie spécifique, sans nécessiter d'entraînement supplémentaire ni de mise à jour des paramètres internes du modèle.
Contrairement à l'apprentissage supervisé traditionnel, où le modèle est ajusté via un jeu de données d'entraînement, le few-shot prompting opère exclusivement à la phase d'inférence. Les informations des exemples sont traitées temporairement dans la fenêtre de contexte. Cette distinction est fondamentale : le modèle ne « mémorise » pas les exemples de manière permanente, mais les utilise comme conditionnement pour générer la réponse à la nouvelle entrée.
Cette approche repose sur l'hypothèse que les modèles de langage de grande taille possèdent une capacité intrinsèque à inférer les règles sous-jacentes d'une tâche à partir d'une démonstration limitée, sans nécessiter de rétropropagation du gradient. En fournissant des paires d'entrée et de sortie cohérentes, le praticien crée un cadre conditionnel qui réduit l'espace des possibles pour la génération de la réponse finale. Ce mécanisme permet d'aligner précisément la sortie du modèle sur des exigences métier spécifiques, telles que la conformité à un format de données strict ou l'adoption d'un registre linguistique particulier, tout en conservant la flexibilité d'un modèle non spécialisé. La nature éphémère de cette adaptation signifie que chaque requête doit être construite avec soin pour encapsuler l'ensemble des contraintes nécessaires, car aucune mémoire persistante n'est associée à la session d'inférence.
Mécanisme technique : In-context learning (ICL)
Le mécanisme sous-jacent est connu sous le nom d'in-context learning (ICL). Lorsque le modèle reçoit un prompt avec des exemples, l'architecture des transformeurs utilise le mécanisme d'attention pour relier la nouvelle entrée aux paires entrée-sortie fournies. Le modèle identifie des motifs structurels, sémantiques et de format dans les exemples et les applique à la requête finale.
Des recherches, telles que celles de Min et al. (2022), suggèrent que le modèle est sensible au format et à la distribution des étiquettes plus qu'à la correction individuelle de chaque exemple. Cela implique que la cohérence structurelle des exemples est aussi importante que leur contenu sémantique. Le modèle « apprend » la tâche par démonstration, en cartographiant la structure des exemples sur la nouvelle entrée sans effectuer de calcul de gradient.
La compréhension fine de l'apprentissage in-context révèle que le modèle ne traite pas les exemples comme de simples données statiques, mais comme des signaux dynamiques qui modifient la distribution de probabilité des tokens suivants. Le mécanisme d'attention permet au modèle de pondérer l'importance relative de chaque exemple en fonction de sa similarité avec la requête courante, créant ainsi une sorte de filtrage contextuel. Cette capacité à généraliser à partir de peu d'exemples suggère que les architectures de transformeurs ont développé une forme de méta-apprentissage durant leur pré-entraînement, leur permettant de reconnaître des schémas de tâche récurrents. Toutefois, cette sensibilité aux structures de surface implique que la qualité et la diversité des exemples sont déterminantes ; des exemples trop homogènes peuvent limiter la capacité du modèle à gérer des variations subtiles dans les nouvelles entrées, tandis qu'une distribution équilibrée des étiquettes aide à stabiliser la sortie.
Flux de l'In-Context Learning
Processus par lequel le modèle intègre les exemples dans la fenêtre de contexte pour générer la sortie.
- 01L'utilisateur fournit une instruction de base et une série de paires entrée-sortie (shots).
- 02Le modèle traite la séquence complète, y compris les exemples, via des couches d'attention.
- 03Le mécanisme d'attention identifie les corrélations entre les entrées des exemples et leurs sorties correspondantes.
- 04Le modèle génère la sortie pour la nouvelle entrée, en imitant le motif établi par les exemples.
Exemples appliqués dans trois domaines distincts
La polyvalence du few-shot prompting permet son application à des tâches de classification, d'extraction de données et de génération de code. Voici trois cas d'usage concrets illustrant la construction du prompt et les attentes de sortie.
Dans la classification de sentiments pour le support technique, les exemples définissent les catégories (positif, négatif, neutre) et le format de réponse. Dans l'extraction de données structurées de factures, les exemples montrent comment mapper du texte non structuré vers des champs JSON spécifiques. Dans la génération de code, les exemples établissent le style de programmation, la nomenclature et les pratiques de gestion d'erreurs souhaitées.
L'application de cette technique dans des domaines variés met en évidence l'importance de la précision dans la formulation des exemples. Dans le cas de la classification de sentiments, la clarté des catégories et la neutralité des exemples neutres sont cruciales pour éviter les biais de classification. Pour l'extraction de données, la structure JSON doit être rigoureusement respectée dans les exemples pour garantir que le modèle reproduise fidèlement la syntaxe attendue, y compris la gestion des valeurs manquantes ou des types de données spécifiques. En génération de code, les exemples servent de gabarit stylistique, guidant le modèle vers des conventions de nommage et des structures de contrôle cohérentes. Il est essentiel que les exemples couvrent les cas limites pertinents pour la tâche, car le modèle tend à imiter les patterns présents dans les démonstrations, ce qui peut conduire à des échecs si des scénarios inhabituels ne sont pas illustrés.
Confusions fréquentes : Différences avec les techniques liées
Il est courant de confondre le few-shot prompting avec d'autres techniques d'adaptation des modèles. La différence principale réside dans la mise à jour des poids du modèle et dans le nombre d'exemples utilisés. Le zero-shot prompting n'inclut pas d'exemples, le one-shot en inclut un, et le few-shot en inclut plusieurs (généralement entre 2 et 10).
Le fine-tuning, en revanche, implique un processus d'entraînement où les poids du modèle sont ajustés via un jeu de données. Le few-shot prompting est plus rapide et moins coûteux, mais moins précis pour les tâches très spécifiques ou complexes. La chaîne de pensée (Chain-of-Thought) est une technique complémentaire qui peut être combinée au few-shot pour améliorer le raisonnement logique, et non une alternative directe.
La distinction entre le few-shot prompting et le fine-tuning est fondamentale pour la planification des ressources techniques. Le fine-tuning offre une précision supérieure pour des tâches de niche en modifiant durablement les poids du modèle, mais au prix d'un coût computationnel élevé et d'un temps de mise en œuvre plus long. Le few-shot prompting, en revanche, permet une itération rapide des prompts et une adaptation immédiate aux changements de spécifications, ce qui en fait un outil privilégié pour le prototypage et les applications à faible volume. La chaîne de pensée, lorsqu'elle est combinée au few-shot, ajoute une couche de raisonnement explicite qui peut améliorer la fiabilité des sorties pour des tâches logiques complexes, en forçant le modèle à détailler ses étapes de calcul avant de fournir la réponse finale. Cette complémentarité permet de tirer parti de la flexibilité du prompting tout en renforçant la robustesse du raisonnement.
Comparatif des techniques d'adaptation
Tableau de décision pour choisir la technique appropriée selon les ressources et la complexité de la tâche.
| Technique | Exemples dans le prompt | Mise à jour des poids | Coût computationnel | Usage recommandé |
|---|---|---|---|---|
| Zero-shot | 0 | Non | Faible | Tâches simples et génériques |
| One-shot | 1 | Non | Faible | Clarification de format basique |
| Few-shot | 2-10 | Non | Moyen (tokens) | Formats spécifiques, ton, extraction |
| Fine-tuning | N/A (Dataset) | Oui | Élevé (GPU) | Tâches complexes, haut volume, précision extrême |
Limites opérationnelles et considérations pratiques
Le few-shot prompting n'est pas exempt de limites. La fenêtre de contexte du modèle limite la quantité d'exemples qui peuvent être inclus ; si les exemples sont trop longs, la limite de tokens peut être dépassée, empêchant le traitement complet de la requête. De plus, le coût en tokens augmente linéairement avec le nombre d'exemples, ce qui peut impacter la latence et les coûts d'API.
La sensibilité à l'ordre et à la qualité des exemples est un facteur critique. Des études ont montré que l'ordre des exemples peut influencer la sortie du modèle, et des exemples contradictoires ou de basse qualité peuvent dégrader les performances. Il n'y a pas de garantie de généralisation : le modèle peut échouer sur des entrées qui diffèrent significativement des exemples fournis. Pour les tâches de raisonnement complexe, le few-shot seul peut être insuffisant, nécessitant des techniques avancées comme la Chain-of-Thought.
Les limites opérationnelles du few-shot prompting exigent une gestion rigoureuse des ressources de contexte et de la qualité des données. La contrainte de la fenêtre de contexte impose un arbitrage entre le nombre d'exemples et leur longueur ; des exemples trop verbeux peuvent consommer une part disproportionnée des tokens disponibles, réduisant l'espace pour la requête elle-même. De plus, la variabilité des performances selon l'ordre des exemples souligne la nécessité de tests systématiques pour identifier la configuration optimale. L'absence de garantie de généralisation signifie que le modèle peut produire des résultats incohérents face à des entrées qui sortent du cadre défini par les exemples, ce qui nécessite une validation humaine ou des mécanismes de vérification automatique pour les applications critiques. Enfin, la sensibilité aux biais de récence ou de primauté rappelle que la conception du prompt doit être considérée comme un processus expérimental, où l'ajustement fin de la position et du contenu des exemples est essentiel pour maximiser la fiabilité de la sortie.