Definição numa frase
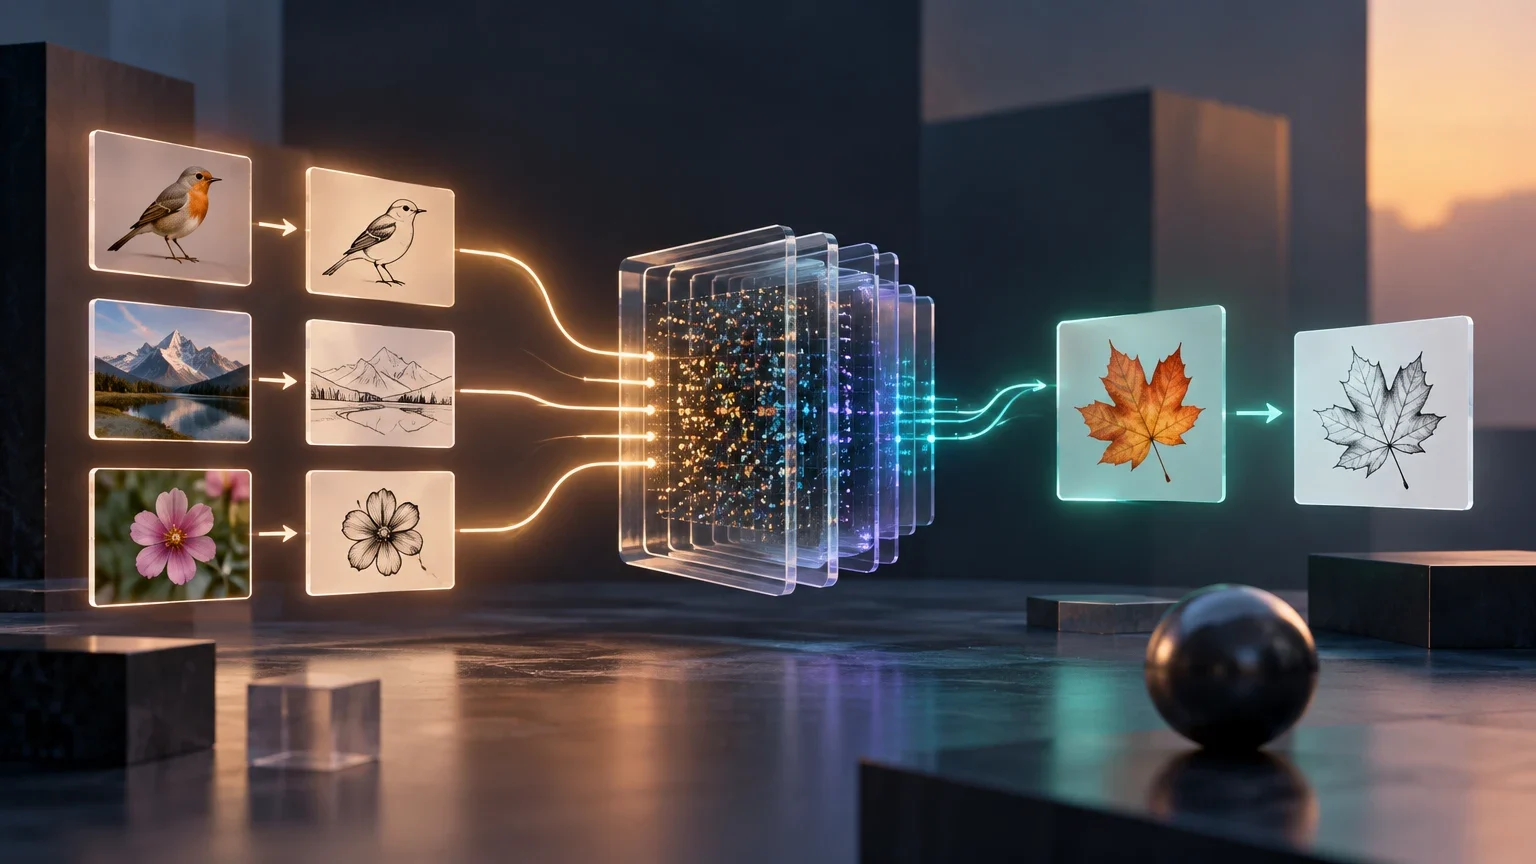
Uso de alguns exemplos dentro do pedido para mostrar ao modelo a tarefa, o critério ou o formato esperado.
Definição: Few-shot prompting como técnica de engenharia de contexto
O few-shot prompting é uma técnica de engenharia de prompts que consiste em fornecer a um modelo de linguagem de grande escala (LLM) vários exemplos resolvidos de uma tarefa dentro da mesma instrução. O objetivo é guiar o desempenho do modelo para um formato, tom ou estrutura de saída específica sem a necessidade de realizar um treinamento adicional ou de atualizar os parâmetros internos do modelo.
Diferentemente do aprendizado supervisionado tradicional, onde o modelo é ajustado por meio de um conjunto de dados de treinamento, o few-shot prompting opera exclusivamente na fase de inferência. A informação dos exemplos é processada temporariamente dentro da janela de contexto. Esta distinção é fundamental: o modelo não 'memoriza' os exemplos de forma permanente, mas os utiliza como condicionamento para gerar a resposta à nova entrada.
A natureza efêmera do few-shot prompting impõe uma arquitetura de estado onde a memória é estritamente delimitada pela duração da sessão ativa. Isso significa que a consistência do comportamento do modelo depende inteiramente da retransmissão dos mesmos exemplos em cada nova interação, o que exige uma gestão cuidadosa do contexto para evitar a perda de alinhamento com o formato desejado. A ausência de persistência nos parâmetros internos garante que o modelo retorne ao seu estado pré-treinado assim que a janela de contexto é limpa, eliminando qualquer risco de contaminação de longo prazo, mas também obrigando o desenvolvedor a tratar os exemplos como parte integrante e invariável da solicitação, e não como um recurso de configuração permanente.
Mecanismo técnico: In-context learning (ICL)
O mecanismo subjacente é conhecido como in-context learning (ICL). Quando o modelo recebe um prompt com exemplos, a arquitetura de transformers utiliza o mecanismo de atenção para relacionar a nova entrada com os pares entrada-saída fornecidos. O modelo identifica padrões estruturais, semânticos e de formato nos exemplos e os aplica à consulta final.
Pesquisas, como as de Min et al. (2022), sugerem que o modelo é sensível ao formato e à distribuição das rótulos mais do que à correção individual de cada exemplo. Isso implica que a coerência estrutural dos exemplos é tão importante quanto seu conteúdo semântico. O modelo 'aprende' a tarefa por demonstração, mapeando a estrutura dos exemplos para a nova entrada sem realizar um cálculo de gradiente.
A dependência do mecanismo de atenção para o in-context learning implica que a qualidade da correlação entre os exemplos e a nova entrada é determinada pela proximidade semântica e estrutural dentro da sequência processada. Como o modelo não realiza atualizações de pesos, a 'aprendizagem' é uma inferência estatística baseada na distribuição de probabilidade das tokens condicionadas pelos exemplos anteriores. Isso significa que a eficácia do ICL é diretamente proporcional à clareza dos padrões estabelecidos; se os exemplos apresentarem ambiguidade ou inconsistência, o mecanismo de atenção pode falhar em identificar a regra subjacente, resultando em saídas que não seguem o formato ou o tom pretendidos, evidenciando a fragilidade do processo quando a estrutura dos dados de demonstração não é rigorosamente controlada.
Fluxo do In-Context Learning
Processo pelo qual o modelo integra os exemplos na janela de contexto para gerar a saída.
- 01O usuário fornece uma instrução base e uma série de pares entrada-saída (shots).
- 02O modelo processa a sequência completa, incluindo os exemplos, por meio de camadas de atenção.
- 03O mecanismo de atenção identifica correlações entre as entradas dos exemplos e suas saídas correspondentes.
- 04O modelo gera a saída para a nova entrada, imitando o padrão estabelecido pelos exemplos.
Exemplos aplicados em três domínios distintos
A versatilidade do few-shot prompting permite sua aplicação em tarefas de classificação, extração de dados e geração de código. A seguir, detalhamos três casos de uso concretos que ilustram como o prompt é construído e o que se espera da saída.
Na classificação de sentimento para suporte técnico, os exemplos definem as categorias (positivo, negativo, neutro) e o formato de resposta. Na extração de dados estruturados de faturas, os exemplos mostram como mapear texto não estruturado para campos JSON específicos. Na geração de código, os exemplos estabelecem o estilo de programação, a nomenclatura e as práticas de tratamento de erros desejadas.
A aplicação do few-shot prompting em domínios como classificação, extração e geração de código demonstra que a técnica funciona melhor quando a tarefa possui uma estrutura de entrada e saída bem definida e repetível. Em cenários de suporte técnico, por exemplo, a definição clara das categorias de sentimento nos exemplos serve como um guia rígido que reduz a variabilidade nas respostas do modelo, garantindo que a classificação seja consistente mesmo diante de nuances linguísticas sutis. Da mesma forma, na extração de dados de faturas, a correspondência exata entre o texto não estruturado e os campos JSON nos exemplos estabelece um mapeamento que o modelo replica para novas entradas, minimizando erros de formatação e garantindo a integridade dos dados extraídos para sistemas downstream.
Confusões frequentes: Diferenças com técnicas relacionadas
É comum confundir o few-shot prompting com outras técnicas de adaptação de modelos. A diferença principal reside em se os pesos do modelo são atualizados e na quantidade de exemplos utilizados. O zero-shot prompting não inclui exemplos, o one-shot inclui um, e o few-shot inclui vários (geralmente entre 2 e 10).
O fine-tuning, por outro lado, implica um processo de treinamento onde os pesos do modelo são ajustados por meio de um conjunto de dados. O few-shot prompting é mais rápido e barato, mas menos preciso para tarefas muito específicas ou complexas. A cadeia de pensamento (Chain-of-Thought) é uma técnica complementar que pode ser combinada com few-shot para melhorar o raciocínio lógico, não uma alternativa direta.
A distinção entre few-shot prompting e fine-tuning é crucial para a otimização de custos e recursos computacionais em pipelines de produção. Enquanto o fine-tuning oferece maior precisão para tarefas altamente especializadas ao ajustar os pesos do modelo, o few-shot prompting oferece uma flexibilidade imediata e um custo marginal por inferência, sendo ideal para prototipagem rápida ou para tarefas onde o volume de dados de treinamento é insuficiente para justificar o custo de um ajuste fino. A combinação com Chain-of-Thought permite que o modelo exiba seu raciocínio intermediário, o que pode ser particularmente útil em tarefas de lógica complexa, mas essa abordagem deve ser vista como um complemento ao few-shot, não como uma substituição, pois ambos os métodos operam na fase de inferência e compartilham as mesmas limitações de janela de contexto e sensibilidade à ordem dos exemplos.
Comparativo de técnicas de adaptação
Tabela de decisão para escolher a técnica adequada com base nos recursos e na complexidade da tarefa.
| Técnica | Exemplos no prompt | Atualização de pesos | Custo computacional | Uso recomendado |
|---|---|---|---|---|
| Zero-shot | 0 | Não | Baixo | Tarefas simples e genéricas |
| One-shot | 1 | Não | Baixo | Clarificação de formato básico |
| Few-shot | 2-10 | Não | Médio (tokens) | Formatos específicos, tom, extração |
| Fine-tuning | N/A (Dataset) | Sim | Alto (GPU) | Tarefas complexas, alto volume, precisão extrema |
Limites operativos e considerações práticas
O few-shot prompting não está isento de limitações. A janela de contexto do modelo limita a quantidade de exemplos que podem ser incluídos; se os exemplos forem longos demais, o limite de tokens pode ser excedido, o que impede o processamento da consulta completa. Além disso, o custo em tokens aumenta linearmente com o número de exemplos, o que pode impactar a latência e os custos de API.
A sensibilidade à ordem e à qualidade dos exemplos é um fator crítico. Estudos mostraram que a ordem dos exemplos pode influenciar a saída do modelo, e exemplos contraditórios ou de baixa qualidade podem degradar o desempenho. Não há garantia de generalização: o modelo pode falhar em entradas que diferem significativamente dos exemplos fornecidos. Para tarefas de raciocínio complexo, o few-shot por si só pode ser insuficiente, exigindo técnicas avançadas como Chain-of-Thought.
As limitações operativas do few-shot prompting, particularmente a sensibilidade à ordem dos exemplos e o custo linear de tokens, exigem uma abordagem empírica na construção de prompts. A falta de uma regra universal para a quantidade ideal de exemplos significa que os desenvolvedores devem realizar testes iterativos para determinar o ponto de equilíbrio entre a cobertura de casos de borda e a eficiência computacional. Além disso, a possibilidade de viés de recência ou primazia indica que a robustez da saída não é garantida por uma única configuração de prompt; portanto, a validação deve incluir a permutação dos exemplos para verificar a estabilidade das respostas, reconhecendo que a generalização do modelo para entradas fora da distribuição dos exemplos fornecidos permanece uma área de incerteza que requer monitoramento contínuo em ambientes de produção.