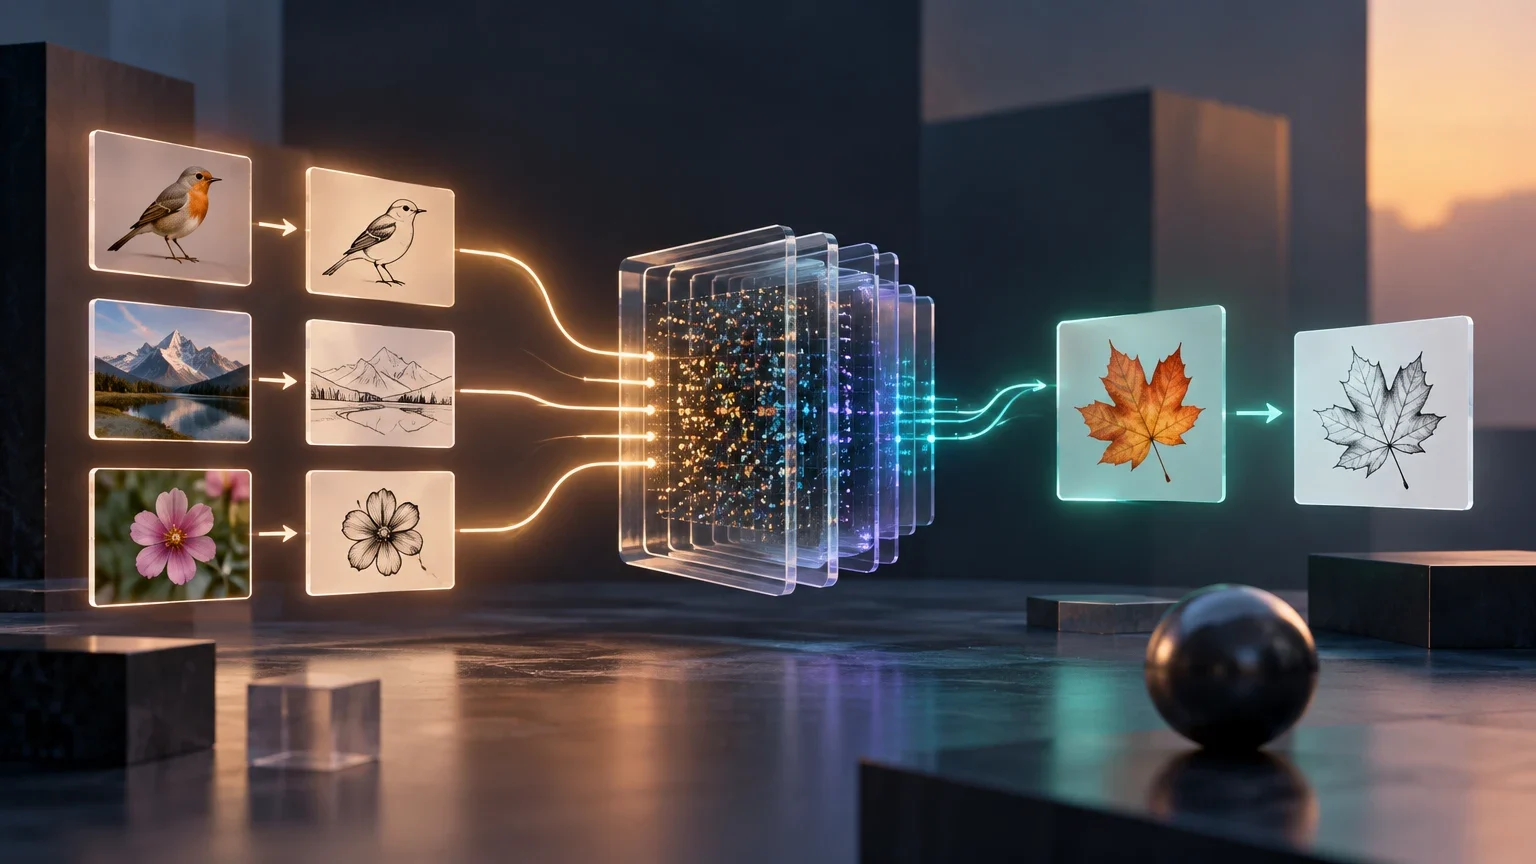
Definition in einem Satz
Verwendung weniger Beispiele innerhalb der Anfrage, um dem Modell die Aufgabe, das Kriterium oder das erwartete Format zu zeigen.
Definition: Few-Shot Prompting as a Context Engineering Technique
Few-Shot-Prompting is a prompt engineering technique that involves providing a large language model (LLM) with several solved examples of a task within the same instruction. The goal is to guide the model's performance towards a specific output format, tone, or structure without the need for additional training or updating the model's internal parameters.
Unlike traditional supervised learning, where the model is adjusted using a training dataset, few-shot prompting operates exclusively during the inference phase. The information from the examples is processed temporarily within the context window. This distinction is fundamental: the model does not 'memorize' the examples permanently, but uses them as conditioning to generate the response to the new input.
Esta distinción operativa subraya la naturaleza efímera del conocimiento adquirido mediante esta técnica. Al no persistir en la arquitectura del modelo, cada interacción requiere la redefinición completa del contexto, lo que garantiza la flexibilidad inmediata pero exige una gestión cuidadosa de los recursos de memoria a corto plazo.
La ausencia de modificación en los parámetros internos implica que la capacidad de respuesta del modelo depende enteramente de la calidad y relevancia de los ejemplos presentados en tiempo real. Esto convierte la ingeniería de contexto en un proceso dinámico donde la precisión del resultado está intrínsecamente ligada a la formulación del prompt en cada solicitud individual.
Technical Mechanism: In-Context Learning (ICL)
The underlying mechanism is known as In-Context Learning (ICL). When the model receives a prompt with examples, the transformer architecture uses the attention mechanism to relate the new input with the provided input-output pairs. The model identifies structural, semantic, and format patterns in the examples and applies them to the final query.
Research, such as that by Min et al. (2022), suggests that the model is sensitive to the format and the distribution of labels more than to the individual correctness of each example. This implies that the structural coherence of the examples is as important as their semantic content. The model 'learns' the task by demonstration, mapping the structure of the examples to the new input without performing a gradient calculation.
El proceso de mapeo estructural descrito por Min et al. (2022) resalta que la coherencia formal de los pares de entrada y salida actúa como una guía heurística para el modelo. La atención se centra en las regularidades sintácticas y semánticas repetidas, permitiendo que el sistema infiera la lógica subyacente de la tarea sin necesidad de un ajuste numérico explícito de sus pesos.
Esta sensibilidad al formato sugiere que la variabilidad en la presentación de los ejemplos puede alterar significativamente la interpretación del modelo. Por tanto, la consistencia en la estructura de los datos de demostración es tan determinante como la precisión semántica de cada caso individual, reforzando la idea de que el aprendizaje in-contexto es un proceso de reconocimiento de patrones más que de memorización de hechos.
In-Context Learning Flow
Process by which the model integrates examples into the context window to generate the output.
- 01The user provides a base instruction and a series of input-output pairs (shots).
- 02The model processes the complete sequence, including the examples, through attention layers.
- 03The attention mechanism identifies correlations between the example inputs and their corresponding outputs.
- 04The model generates the output for the new input, mimicking the pattern established by the examples.
Applied Examples in Three Different Domains
The versatility of few-shot prompting allows its application in classification, data extraction, and code generation tasks. Below are three specific use cases illustrating how the prompt is constructed and what is expected from the output.
In sentiment classification for technical support, the examples define the categories (positive, negative, neutral) and the response format. In structured data extraction from invoices, the examples show how to map unstructured text to specific JSON fields. In code generation, the examples establish the desired programming style, nomenclature, and error handling practices.
En el ámbito de la clasificación de sentimientos, la definición clara de las categorías mediante ejemplos permite al modelo discernir matices sutiles en el lenguaje del usuario. La estructura de los pares de demostración establece un marco de referencia que reduce la ambigüedad en la interpretación de mensajes con tonos mixtos o neutros, facilitando una categorización más consistente.
Para la extracción de datos de facturas, los ejemplos sirven como plantillas que guían la conversión de texto libre a estructuras de datos rígidas. Al mostrar explícitamente cómo se asignan los valores a campos específicos, el modelo puede replicar esta lógica de mapeo en nuevos documentos, minimizando errores de formato y asegurando la integridad de los datos extraídos para su posterior procesamiento.
Common Confusions: Differences with Related Techniques
It is common to confuse few-shot prompting with other model adaptation techniques. The main difference lies in whether the model's weights are updated and the number of examples used. Zero-shot prompting includes no examples, one-shot includes one, and few-shot includes several (generally between 2 and 10).
Fine-tuning, on the other hand, involves a training process where the model's weights are adjusted using a dataset. Few-shot prompting is faster and cheaper, but less precise for very specific or complex tasks. Chain-of-Thought is a complementary technique that can be combined with few-shot to improve logical reasoning, not a direct alternative.
La elección entre estas técnicas debe considerar no solo la complejidad de la tarea, sino también los recursos computacionales disponibles y la necesidad de precisión extrema. Mientras que el few-shot prompting ofrece una solución ágil y de bajo coste para la adaptación de formatos, el fine-tuning se reserva para escenarios donde la especialización del modelo es crítica y el volumen de datos justifica la inversión en entrenamiento.
La complementariedad entre el few-shot prompting y la cadena de pensamiento permite abordar tareas que requieren tanto una estructura de salida específica como un razonamiento lógico profundo. Al combinar la demostración de formato con la explicación paso a paso, se puede mejorar la fiabilidad de las respuestas en problemas complejos, superando las limitaciones inherentes a cada técnica por separado.
Comparison of Adaptation Techniques
Decision table for choosing the appropriate technique based on resources and task complexity.
| Technique | Examples in Prompt | Weight Update | Computational Cost | Recommended Use |
|---|---|---|---|---|
| Zero-shot | 0 | No | Low | Simple and generic tasks |
| One-shot | 1 | No | Low | Basic format clarification |
| Few-shot | 2-10 | No | Medium (tokens) | Specific formats, tone, extraction |
| Fine-tuning | N/A (Dataset) | Yes | High (GPU) | Complex tasks, high volume, extreme precision |
Operational Limits and Practical Considerations
Few-shot prompting is not exempt from limitations. The model's context window limits the number of examples that can be included; if the examples are too long, the token limit may be exceeded, preventing the complete processing of the query. Additionally, the token cost increases linearly with the number of examples, which can impact latency and API costs.
Sensitivity to the order and quality of examples is a critical factor. Studies have shown that the order of examples can influence the model's output, and contradictory or low-quality examples can degrade performance. There is no guarantee of generalization: the model may fail on inputs that differ significantly from the provided examples. For complex reasoning tasks, few-shot alone may be insufficient, requiring advanced techniques like Chain-of-Thought.
La dependencia del coste en tokens respecto al número de ejemplos introduce una restricción económica directa en la implementación de esta técnica. A medida que se añaden más casos de demostración para aumentar la robustez, el consumo de recursos crece de manera proporcional, lo que puede afectar negativamente a la latencia de respuesta y a la escalabilidad de las aplicaciones que dependen de llamadas frecuentes a la API.
La falta de garantías de generalización exige una validación rigurosa de los ejemplos seleccionados. Dado que el modelo puede fallar ante entradas que se desvíen de los patrones establecidos, es crucial diseñar conjuntos de ejemplos que representen la diversidad esperada en los datos de entrada, mitigando así el riesgo de degradación del rendimiento en casos no contemplados explícitamente en el prompt.