O que a Liquid AI anunciou
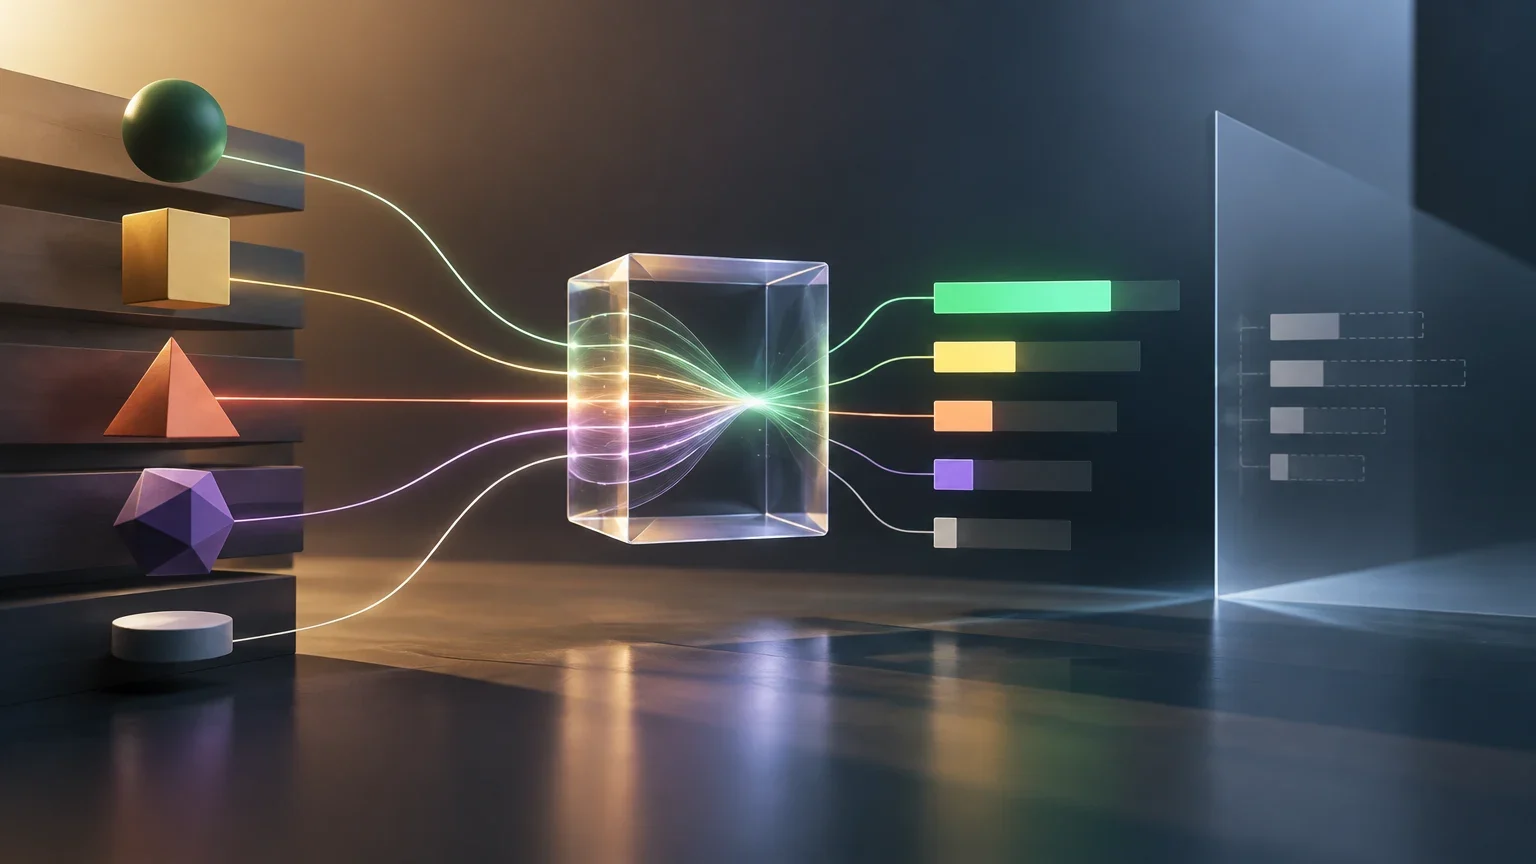
A Liquid AI apresenta d1 como um modelo de decisão: em vez de redigir uma resposta aberta, ele avalia uma entrada e retorna resultados estruturados para uma decisão delimitada. A documentação descreve três opções: d1-3B, um modelo multimodal de texto e imagem; d1-omni-600M, que aceita texto, imagem ou áudio; e d1Hosted, disponível pela API da Liquid AI.
A empresa propõe esse tipo de modelo para classificação, priorização, moderação, encaminhamento de solicitações e outras tarefas com resultados predefinidos. A distinção é prática: se o sistema precisa escolher um rótulo ou uma pontuação, pode responder em uma estrutura delimitada; se precisa explicar, resumir ou escrever, é necessária uma capacidade generativa. A documentação indica expressamente esses casos de geração aberta como usos para um modelo de linguagem.
A disponibilidade descrita na documentação não significa que cada modalidade, interface ou modelo esteja disponível em todos os ambientes. Antes de integrar d1, convém verificar o modelo específico, as entradas aceitas, a API e as condições vigentes. O anúncio da empresa também apresenta como próprios os resultados da comparação com Jev; eles devem ser entendidos como afirmações do fornecedor, não como validação independente.
Como o modelo expressa suas decisões
A documentação agrupa as consultas em três primitivas. Choice seleciona uma categoria entre opções sem ordem inerente e retorna uma distribuição de probabilidades sobre as alternativas nomeadas. Score posiciona a resposta em uma escala ordenada, como uma rubrica de gravidade. Noul formula uma pergunta binária e retorna uma probabilidade entre 0 e 1; por exemplo, a probabilidade de uma mensagem ser spam.
Isso permite distinguir entre escolher a opção mais provável e saber quanta incerteza permanece entre as alternativas. Se um sistema atribuir probabilidades semelhantes a dois departamentos, poderá encaminhar o caso para revisão, em vez de tratar o rótulo vencedor como certeza. Mas o fato de uma saída ser probabilística não demonstra, por si só, que as probabilidades estejam bem calibradas: essa propriedade precisa ser medida com dados representativos.
A Liquid AI afirma que d1 não gera tokens de resposta e produz uma decisão em uma única chamada. A expressão «zero tokens gerados» descreve, segundo o fornecedor, a forma como a saída é produzida; por si só, não informa todos os elementos da cobrança, como o tratamento da entrada, a tarifa da API ou os custos de infraestrutura. Também não basta para concluir que uma tarefa será sempre mais rápida ou mais barata do que com um modelo generativo.
Onde o modelo pode se encaixar em uma empresa
A proposta é mais pertinente quando as respostas possíveis são delimitadas e a decisão se repete com frequência. Entre os usos descritos pela Liquid AI estão a classificação de mensagens, o encaminhamento de tickets, a moderação, a avaliação de urgência, as verificações binárias de segurança e a aprovação de chamadas de ferramentas. Para entradas visuais, são mencionadas a inspeção e a classificação de imagens; para áudio, a detecção de intenção e o encaminhamento de comandos de voz no modelo que aceita essa modalidade.
Um exemplo operacional é a triagem de solicitações: o sistema atribui probabilidades a categorias conhecidas e encaminha os casos ambíguos para uma pessoa. Outro é uma etapa de controle que verifica se uma resposta extraída atende a um requisito antes de aceitar o resultado. Nos dois casos, a utilidade depende de o catálogo de opções representar os casos reais e de haver uma saída segura para entradas novas, incompletas ou fora da distribuição esperada.
D1 não substitui automaticamente um LLM. A própria documentação recomenda a geração para escrita livre, conversas, resumos, código, perguntas abertas e raciocínio complexo em várias etapas. Uma arquitetura pode combinar as duas abordagens: usar um modelo de decisão para uma classificação delimitada e recorrer a um modelo generativo ou a uma pessoa quando for necessária uma explicação ou uma resposta aberta.
Escolher entre decisão estruturada e geração
| Necessidade | Abordagem que pode ser adequada | O que verificar |
|---|---|---|
| Atribuir uma solicitação a uma categoria fixa | Modelo de decisão, como Choice | Cobertura das categorias, casos ambíguos e opção de abstenção ou revisão |
| Pontuar a gravidade segundo uma escala definida | Modelo de decisão, como Score | Definição consistente da escala e concordância com avaliadores humanos |
| Redigir uma explicação ou resumir um caso | Modelo generativo | Qualidade do texto, fidelidade à entrada e controles de segurança |
| Responder a uma pergunta aberta ou manter uma conversa | Modelo generativo | Raciocínio necessário, contexto e necessidade de acompanhamento |
| Aceitar ou rejeitar uma ação com critérios binários | Modelo de decisão, como Noul | Custos de falsos positivos e falsos negativos, limiar e supervisão |
O que falta para avaliar a comparação com Jev
A Liquid AI afirma que d1 supera Jev no Decision Index do Hugging Face e também destaca resultados em avaliações multilíngues, no processamento de entradas longas e na resistência à injeção de instruções. A existência de uma afirmação do fabricante não permite apresentá-la como fato verificado de forma independente. Para interpretar o resultado, são necessárias a versão exata do benchmark, suas tarefas, os dados avaliados, o protocolo, os modelos comparados e as condições de execução.
Também é importante separar uma pontuação agregada dos resultados por tarefa. Um índice que reúne diferentes tipos de avaliação pode orientar uma comparação, mas não prevê, por si só, como um sistema funcionará na classificação de faturas, na moderação de mensagens ou no encaminhamento de tickets de uma empresa específica. O desempenho pode variar conforme o idioma, o tamanho da entrada, o desenho dos rótulos e a frequência de casos excepcionais.
As fontes fornecidas não estabelecem uma comparação independente de precisão, calibração, latência e custo com Jev ou com modelos generativos em condições equivalentes. Para repetir com rigor a afirmação de que d1 «supera» Jev, seria necessário documentar as versões comparadas, o conjunto de teste e a metodologia, além de verificar se o resultado pode ser reproduzido fora da avaliação anunciada pelo fornecedor.
Teste mínimo antes de escolher um modelo
Avalie uma tarefa representativa e compare as alternativas usando o mesmo protocolo.
- 01Defina a decisão, as opções válidas e o custo de um erro.
- 02Prepare um conjunto de teste separado dos exemplos usados para ajustar instruções ou limiares.
- 03Inclua idiomas, entradas longas, erros de formato e casos que não se encaixem em nenhuma categoria.
- 04Meça a qualidade por classe, a calibração das probabilidades e a taxa de encaminhamento para revisão humana.
- 05Compare a latência e o custo total com uma alternativa generativa na mesma infraestrutura e com o mesmo volume.
- 06Repita a avaliação quando houver mudanças nos dados, na configuração, na versão do modelo ou nas condições do serviço.
Limites e critérios práticos
As probabilidades só são úteis se refletirem razoavelmente a frequência de acertos no caso de uso. Uma pontuação alta não deve ser interpretada automaticamente como garantia, e um limiar de decisão pode ter consequências diferentes conforme o tipo de erro: na moderação, por exemplo, um falso alerta e um conteúdo nocivo que passa despercebido não têm o mesmo custo. A calibração e os limiares devem ser verificados com dados pertinentes e revistos quando as entradas mudarem.
Também convém observar o comportamento diante de informações irrelevantes, instruções maliciosas, categorias desconhecidas e entradas incompletas. A afirmação da empresa de que o modelo é mais resistente à injeção de instruções não elimina a necessidade de testes de segurança próprios. Em tarefas sensíveis, revisão humana, limites de atuação e um mecanismo para encaminhar casos incertos são salvaguardas razoáveis.
Como regra prática, vale testar d1 quando o resultado esperado cabe em uma estrutura definida e pode ser avaliado com exemplos representativos. Um LLM generativo é mais adequado quando a tarefa exige redigir ou responder de forma aberta. Se o processo combinar as duas necessidades, é possível testar um fluxo híbrido e comparar a qualidade, a latência e o custo total antes de alterar um sistema em produção.
Questões em aberto
- Não há evidência independente fornecida que confirme a comparação de desempenho com Jev nem todas as condições em que ela foi feita.
- As fontes fornecidas não estabelecem resultados comparáveis de precisão, calibração, latência e custo em tarefas empresariais reais.
- Não está esclarecido se «zero tokens gerados» implica alguma diferença concreta na cobrança; isso deve ser verificado nas condições da API.
- A disponibilidade, as modalidades e as interfaces podem variar conforme o modelo e o ambiente; é preciso confirmar a situação vigente antes da integração.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção