Einführung: Was AA-LCR misst und warum der Benchmark relevant ist
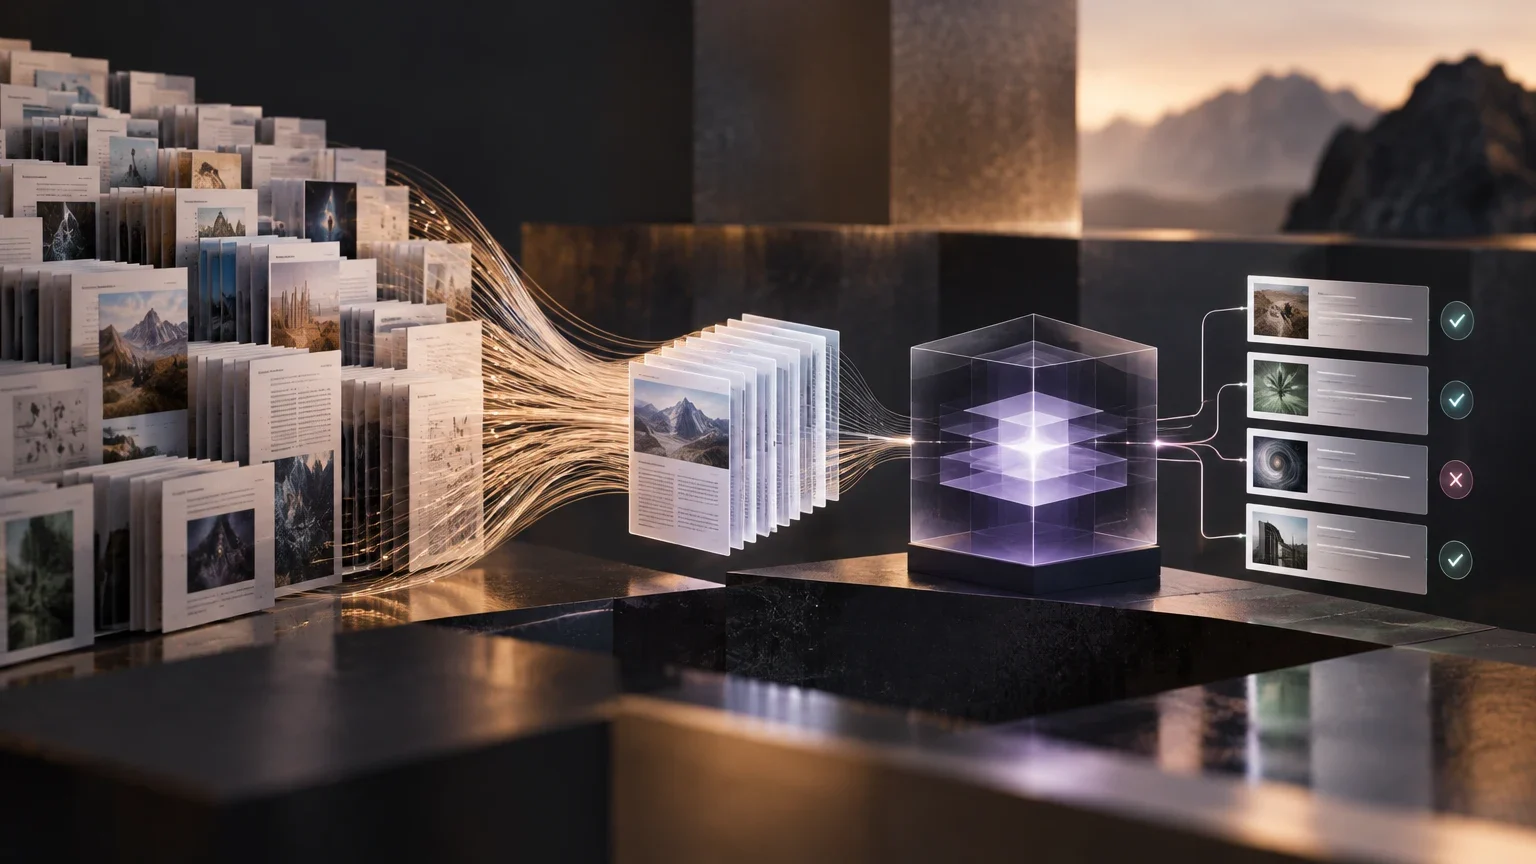
Artificial Analysis Long Context Reasoning (AA-LCR) soll bewerten, wie gut Sprachmodelle Schlussfolgerungen aus umfangreichen Kontexten ziehen können. Im Mittelpunkt steht nicht die bloße Suche nach einer einzelnen Textstelle. Die Fragen verlangen vielmehr, Informationen aus mehreren Quellen zusammenzuführen und daraus eine Antwort abzuleiten, die nicht ausdrücklich in einem einzelnen Dokument steht.
Diese Unterscheidung ist für Entwicklerinnen und Entwickler sowie für Architektinnen und Architekten von KI-Systemen wichtig, wenn sie dokumentenbasierte Analysen, die Auswertung komplexer Codebasen oder mehrstufige Arbeitsabläufe prüfen. AA-LCR orientiert sich an Aufgaben aus der Wissensarbeit, bei denen das Verknüpfen von Informationen entscheidender ist als das reine Auffinden einzelner Angaben. Das macht den Benchmark für solche Anwendungen aussagekräftiger als Tests, die lediglich lange Eingaben oder einfache Informationssuche abbilden. Es macht ihn jedoch nicht automatisch zu einem direkten Maß für die Leistung in jeder Produktionsumgebung.
Die ursprüngliche Beschreibung des Benchmarks beziffert den Umfang auf 100 anspruchsvolle textbasierte Fragen und ungefähr 100.000 Eingabetokens je Frage. Die Fragen erstrecken sich über sieben Dokumentkategorien. Die Angabe von rund 230 bis 234 Dokumenten beschreibt den Umfang des Korpus, während die genaue Zahl in den vorliegenden Unterlagen nicht durchgehend gleich angegeben wird. Deshalb sollte man sie als ungefähre Größenordnung behandeln, nicht als unabhängig bestätigte exakte Zahl.
Auch die Abgrenzung zu Retrieval sollte nicht überzogen werden. Eine Frage kann weiterhin davon abhängen, relevante Passagen zuverlässig zu finden. Der entscheidende Unterschied liegt darin, dass AA-LCR Antworten verlangt, für die Informationen aus mehreren Quellen kombiniert oder interpretiert werden müssen. Der Benchmark prüft somit eine Verbindung aus langem Kontext, Informationssuche und Synthese – nicht eine isolierte, reine Denkfähigkeit.
Aufbau des Benchmarks: Dokumente, Fragen und Antwortanforderungen
AA-LCR umfasst 100 textbasierte Fragen. Für jede Frage werden laut der ursprünglichen Benchmarkbeschreibung ungefähr 100.000 Eingabetokens herangezogen. Der Korpus besteht aus rund 230 bis 234 realen Dokumenten aus sieben Bereichen: Unternehmensberichte, Branchenberichte, staatliche Konsultationen, akademische Texte, Rechtsdokumente, Marketingmaterialien und Umfrageberichte.
Die Fragen sind so angelegt, dass eine Antwort nicht einfach als wörtliche Passage aus einem einzelnen Dokument übernommen werden kann. In der Beschreibung des Benchmarks heißt es, dass Menschen geprüft haben, ob die Aufgaben tatsächlich Schlussfolgerungen über mehrere Informationsquellen hinweg verlangen. Als Beispiel dient die Frage nach dem bereinigten EBITDA eines Unternehmens, nachdem ein Rückgang des operativen Ergebnisses gegenüber dem Vorquartal gemeldet wurde. Um sie zu beantworten, muss das Modell die passende Firma und den Zeitraum identifizieren und die verlangte Finanzkennzahl aus den relevanten Angaben ableiten.
Für die Teilnahme ist ein ausreichend großes Kontextfenster nötig. Die ursprüngliche Beschreibung nennt mindestens 128.000 Tokens, damit die Eingabe für eine Aufgabe aufgenommen werden kann. Das ist eine technische Voraussetzung, aber kein Beleg dafür, dass ein Modell den gesamten Kontext gleichmäßig verarbeitet. Ein großes Fenster kann irrelevante Inhalte, Schwierigkeiten beim Auffinden wichtiger Passagen und Fehler beim Zusammenführen von Informationen nicht ausschließen.
Die Unterlagen geben nicht die vollständigen Auswahlregeln für jedes einzelne Dokument oder die detaillierte Konstruktion aller 100 Fragen wieder. Daher lässt sich aus den verfügbaren Angaben die grobe Architektur beschreiben, nicht aber jeder Schritt des Auswahl- und Validierungsprozesses nachvollziehen. Insbesondere sollte man keine zusätzlichen Kriterien für Aktualität, Schwierigkeitskalibrierung oder Ausschluss von Trainingsdaten unterstellen, wenn sie nicht dokumentiert sind.
Die dokumentierte Struktur von AA-LCR
Die Zahlen und Kategorien fassen die verfügbare ursprüngliche Beschreibung zusammen. Die Dokumentenzahl wird dort als ungefährer Umfang angegeben.
| Bestandteil | Dokumentierte Angabe |
|---|---|
| Fragen | 100 anspruchsvolle textbasierte Fragen |
| Dokumente | Rund 230 bis 234 reale Dokumente aus sieben Kategorien |
| Kontextumfang je Frage | Ungefähr 100.000 Eingabetokens |
| Erforderliches Kontextfenster | Mindestens 128.000 Tokens |
| Aufgabentyp | Schlussfolgerungen aus Informationen in mehreren Dokumenten |
Bewertungsverfahren v1.1: Was belegt ist – und was offenbleibt
Artificial Analysis beschreibt AA-LCR als eine eigene Evaluation und veröffentlicht Ergebnisse für den Benchmark. Das ist von einer Selbsteinschätzung eines Modellanbieters zu unterscheiden. Eine unabhängige Durchführung kann die Vergleichbarkeit verbessern, sofern Modelle unter denselben Vorgaben getestet werden und die Auswertung einheitlich erfolgt. Die verfügbaren Quellen legen jedoch nicht jedes Detail des offiziellen Bewertungsprotokolls für Version 1.1 offen.
In der vorgelegten spanischen Ausgangsfassung wird Qwen3 als Bewertungsmodell genannt und eine Skalierung der Ergebnisse auf 0 bis 1 beziehungsweise als Prozentsatz behauptet. Die verfügbaren Belege bestätigen aber weder die genaue Bewertungsformel noch, wie ein einzelnes Urteil in einen Wert auf dieser Skala umgerechnet wird. Deshalb wäre es nicht gerechtfertigt, ein bestimmtes Punkteschema, eine Normalisierungsformel oder eine exakte Aggregation über die 100 Fragen als gesicherte Methodik darzustellen.
Ein konkreter Hinweis auf eine abweichende Konfiguration betrifft die von NVIDIA für Nemotron Labs Dory 1.0 4B angegebene AA-LCR-Auswertung. Laut der Modellkarte wurden korrigierte Antwortschlüssel aus AA-LCR v1.1 verwendet, aber ein älteres Bewertungsmodell beibehalten. Das ist eine wichtige Einschränkung: Selbst wenn Fragebestand und Antwortschlüssel übereinstimmen, kann eine andere Version des Bewertungsmodells die Ergebnisse beeinflussen. Die dort genannten Werte sind außerdem interne Messungen und dürfen nicht ohne Weiteres mit offiziellen Ergebnissen gleichgesetzt werden.
Damit die Ergebnisse nachvollziehbar sind, müssten mindestens die Benchmarkversion, die verwendeten Dokumente und Antwortschlüssel, die Modellkonfiguration, das Bewertungsmodell und die Ausführungsbedingungen festgehalten werden. Die verfügbaren Angaben belegen jedoch nicht, wie oft das Bewertungsmodell ausgeführt wird, ob Urteile wiederholt oder aggregiert werden oder welche konkreten Einstellungen seine Zufälligkeit begrenzen. Aussagen über eine garantierte Reproduzierbarkeit wären daher zu stark.
Was ein nachvollziehbarer Vergleich dokumentieren sollte
Die folgenden Punkte sind Voraussetzungen für eine faire Interpretation, keine Behauptung, dass sämtliche Angaben für jede veröffentlichte Bewertung vollständig vorliegen.
- 01Das Modell erhält den für die Aufgabe vorgesehenen Dokumentenkontext und beantwortet die Frage.
- 02Die Antwort wird anhand des festgelegten Antwortschlüssels und der dokumentierten Bewertungsregeln beurteilt.
- 03Die verwendete Version des Bewertungsmodells und dessen Einstellungen werden festgehalten.
- 04Ergebnisse werden nur mit Bewertungen verglichen, deren Benchmarkversion und wesentliche Ausführungsbedingungen übereinstimmen.
Grenzen und mögliche Verzerrungen
Ein Sprachmodell als Bewertungsinstanz kann Antworten unterschiedlich beurteilen, auch wenn ihre sachliche Richtigkeit ähnlich ist. Denkbare Risiken sind Präferenzen für bestimmte Formulierungen, Antwortstile oder zusätzliche Erläuterungen. Solche Verzerrungen sind allgemeine methodische Risiken von LLM-basierten Bewertungen; aus den verfügbaren AA-LCR-Unterlagen geht jedoch nicht hervor, dass sie für Qwen3 in diesem Benchmark konkret gemessen oder nachgewiesen wurden. Sie sollten deshalb als zu prüfende Möglichkeit gelten, nicht als festgestellter Effekt.
Auch Schwankungen zwischen Läufen können relevant sein, wenn die Bewertung nicht deterministisch ist oder die Antworten unterschiedlich ausfallen. Ob und wie stark das bei AA-LCR v1.1 geschieht, lässt sich ohne dokumentierte Wiederholungen, Einstellungen und Streuungsmaße nicht beziffern. Eine einzelne veröffentlichte Punktzahl zeigt daher für sich allein weder die Stabilität der Bewertung noch die Größe möglicher Messfehler.
Eine weitere offene Frage ist die mögliche Kontamination mit Trainingsdaten. Der Benchmark greift auf reale Dokumente zurück; daraus folgt ein grundsätzliches Risiko, dass einzelne Texte bereits in Trainings- oder Nachtrainingsdaten enthalten waren. Die vorliegenden Quellen belegen jedoch nicht, in welchem Umfang Artificial Analysis dies untersucht oder welche Schutzmaßnahmen für AA-LCR v1.1 angewendet wurden. Ebenso wenig quantifizieren sie eine tatsächliche Kontamination. Ohne entsprechende Nachweise sollte man weder behaupten, sie sei ausgeschlossen, noch sie als erwiesen darstellen.
Schließlich deckt ein Benchmark nur einen Ausschnitt möglicher Einsatzsituationen ab. Ergebnisse bei einer Sammlung dokumentenübergreifender Fragen lassen sich nicht automatisch auf private Unternehmensunterlagen, wechselnde Datenbestände, RAG-Systeme oder Agenten mit Werkzeugzugriff übertragen. Unterschiede bei Dokumentqualität, Kontextaufbau, Abrufverfahren und Fehlertoleranz können die Leistung im praktischen Einsatz verändern.
Ergebnisse richtig lesen und Vergleiche abgrenzen
Ein Leaderboard sollte nur dann als direkter Vergleich gelesen werden, wenn die Ergebnisse auf derselben Version des Benchmarks und unter hinreichend gleichen Bedingungen entstanden sind. Dazu zählen insbesondere die Bewertungsregeln, die Version des Bewertungsmodells sowie die Konfiguration des getesteten Modells. Unterschiede bei Quantisierung, Kontextaufbau oder zusätzlichem Rechenaufwand können ebenfalls wichtig sein, wenn sie Teil des jeweiligen Tests sind.
Die von NVIDIA für Dory 1.0 4B veröffentlichten AA-LCR-Werte betragen nach der Modellkarte 63, 71 und 73 bei einem, zwei beziehungsweise vier Schleifendurchläufen. Diese Zahlen sind als interne Messungen des Anbieters ausgewiesen und können von offiziellen Werten abweichen. Die Karte nennt außerdem die Verwendung korrigierter Antwortschlüssel aus v1.1 bei gleichzeitig älterem Bewertungsmodell. Damit sind die Werte informativ für die dort getestete Konfiguration, aber nicht automatisch direkt mit Resultaten aus einer anderen Bewertungsumgebung vergleichbar.
Die öffentlich zugängliche Benchmarkbeschreibung nennt als frühen Vergleichswerte ungefähr 69 Prozent für OpenAI o3, 68 Prozent für xAI Grok 4 und 67 Prozent für Qwen3 235B 2507 Thinking. Diese Momentaufnahme bezieht sich auf den damaligen Stand und ist keine aktuelle Rangliste. Sie belegt außerdem nicht, dass jede dieser Bewertungen unter identischen Bedingungen zustande kam. Für aktuelle Modellentscheidungen sollte man deshalb Version und Datum der jeweiligen Ergebnisse prüfen, statt historische Werte als zeitlose Rangfolge zu behandeln.
AA-LCR ist am sinnvollsten als ein Baustein einer umfassenderen Evaluation. Für eine dokumentenbasierte Anwendung sollte man zusätzlich Aufgaben mit eigenen oder repräsentativen Daten testen, Fehlerarten getrennt erfassen und prüfen, ob ein Modell Belege aus den Quellen korrekt verknüpft. Je nach Einsatz können außerdem Retrieval-Qualität, Quellenzitate, Robustheit gegenüber irrelevanten Dokumenten, Kosten und Laufzeit entscheidend sein. Ein einzelner Benchmarkwert beantwortet diese Fragen nicht.
Offene Fragen
- Die genaue Formel, mit der das Bewertungsmodell Antworten beurteilt und Einzelwerte zu einem Gesamtergebnis aggregiert, ist in den verfügbaren Belegen nicht dokumentiert.
- Die verfügbaren Angaben bestätigen keine konkrete Methode, mit der die Auswertung auf Qwen3 als Bewertungsmodell festgelegt oder zwischen Läufen reproduzierbar gemacht wird.
- Die Dokumentenzahl wird mit ungefähr 230 bis 234 angegeben; eine einheitlich belegte exakte Zahl und vollständige Auswahlkriterien liegen hier nicht vor.
- Die Quellen quantifizieren weder mögliche Trainingsdatenkontamination im AA-LCR-Korpus noch konkrete Maßnahmen, mit denen sie in Version 1.1 verhindert wird.
- Der tatsächliche Einfluss von Bewertungsstil, Antwortlänge und Variation zwischen Läufen auf AA-LCR-Ergebnisse ist anhand der verfügbaren Informationen nicht bestimmbar.
- Die Dory-Ergebnisse sind laut Modellkarte interne Messungen mit einem älteren Bewertungsmodell; ihre direkte Vergleichbarkeit mit offiziellen AA-LCR-Werten ist daher nicht gesichert.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen