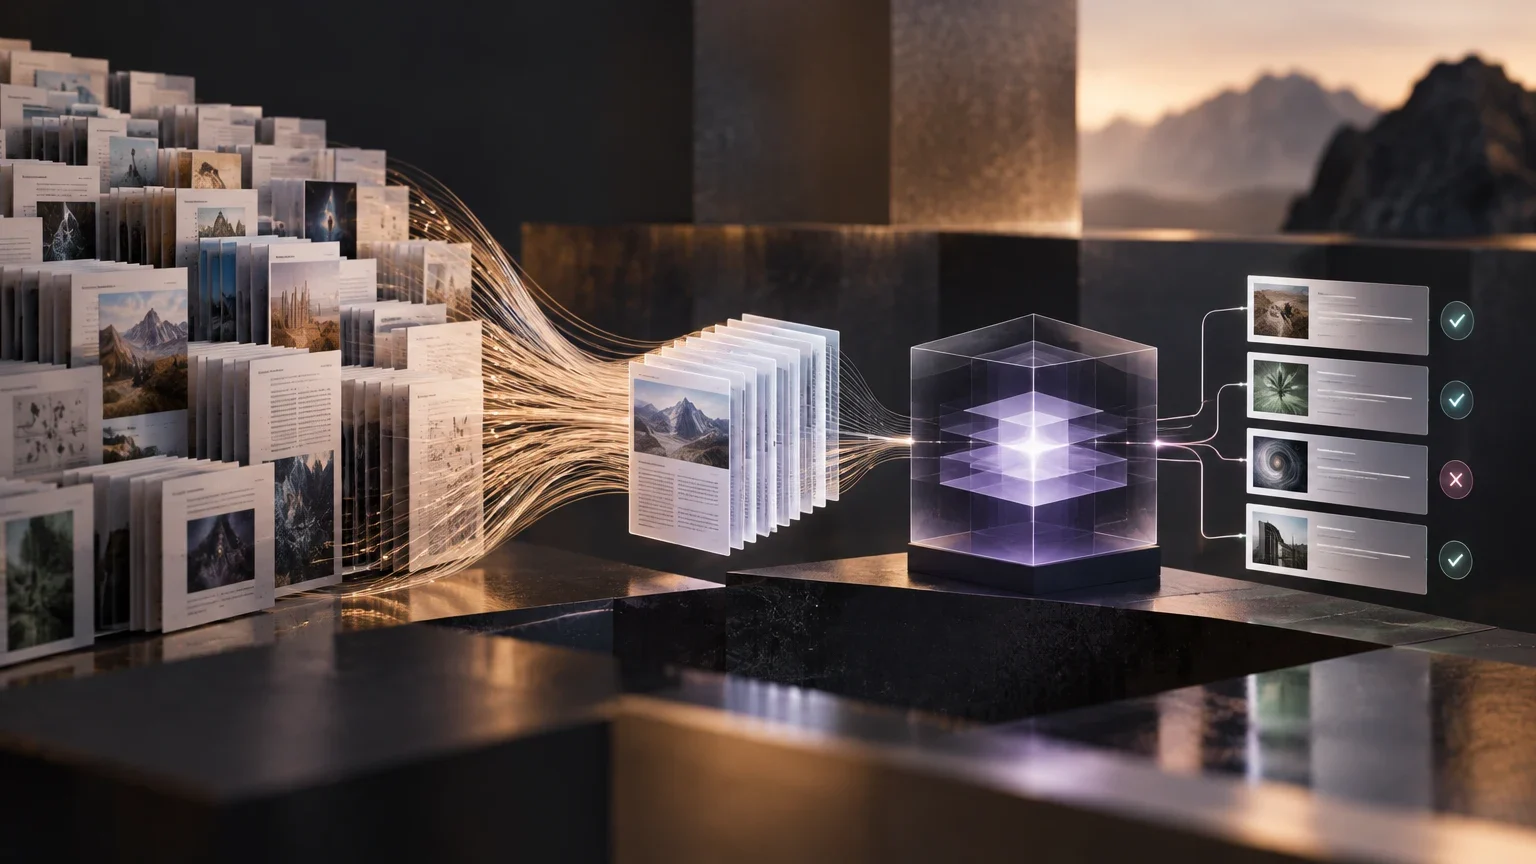
Introduzione: cos'è AA-LCR e perché è rilevante
Il benchmark Artificial Analysis Long Context Reasoning (AA-LCR) è progettato per valutare la capacità dei modelli di linguaggio di eseguire ragionamenti su contesti estesi, superando la semplice ricerca di informazioni. A differenza dei test di retrieval, che misurano la capacità di localizzare un dato specifico all'interno di un testo, AA-LCR richiede che il modello sintetizzi informazioni disperse in più fonti per arrivare a una risposta che non è esplicitamente presente in alcun documento individuale.
Questa distinzione è cruciale per ingegneri e architetti di sistemi che implementano task di analisi documentale, comprensione di codebase complesse o flussi di lavoro multi-step. La rilevanza di AA-LCR risiede nel suo focus sul lavoro di conoscenza reale, dove l'inferenza incrociata è più preziosa della mera estrazione di dati. Riproducendo questi task, il benchmark offre una metrica più vicina alle applicazioni di produzione rispetto ai test tradizionali di contesto lungo.
La transizione da un paradigma di semplice estrazione a uno di sintesi logica implica che il modello debba gestire una complessità cognitiva superiore, dove l'errore non è più solo la mancata localizzazione di un dato, ma la costruzione di un ragionamento errato a partire da premesse corrette. Questo aspetto rende AA-LCR particolarmente sensibile alle capacità di pianificazione e di gestione della memoria a lungo termine del modello, poiché la risposta finale dipende dalla coerenza di più passaggi intermedi che non sono esplicitamente richiesti ma sono necessari per arrivare alla conclusione. Per gli architetti di sistemi, questo significa che un modello che eccelle nei test di retrieval potrebbe fallire in AA-LCR se non possiede le capacità di inferenza incrociata necessarie per collegare dati dispersi in documenti eterogenei, evidenziando un divario significativo tra la capacità di lettura e quella di comprensione profonda.
Inoltre, la rilevanza di questo benchmark si estende alla valutazione della robustezza dei modelli in scenari dove le informazioni sono frammentate e potenzialmente contraddittorie, una situazione comune nei flussi di lavoro aziendali reali. La capacità di AA-LCR di simulare queste condizioni permette di identificare modelli che non solo recuperano dati, ma li integrano in modo coerente, offrendo una metrica più predittiva delle prestazioni in ambienti di produzione complessi. Questo approccio riduce il rischio di implementare modelli che appaiono performanti in test semplificati ma si rivelano inadeguati quando devono gestire la complessità del ragionamento su contesti estesi, garantendo una selezione più accurata delle tecnologie da adottare.
Architettura del benchmark: documenti e domande
La struttura di AA-LCR si basa su un insieme di 100 domande di alta difficoltà che richiedono l'elaborazione di circa 100.000 token di input per domanda. Questi token provengono da un corpus di circa 230 a 234 documenti reali, che copre sette categorie principali: rapporti aziendali, rapporti di settore, consultazioni governative, accademia, legale, materiali di marketing e sondaggi.
La progettazione delle domande è rigorosa: ciascuna è stata verificata da umani per garantire che richieda un'inferenza genuina. Ad esempio, una domanda potrebbe chiedere l'EBITDA rettificato di un'azienda specifica dopo un calo del 13,5% dei suoi ricavi operativi, costringendo il modello a incrociare dati finanziari di diversi trimestri e documenti di stampa. Questa complessità assicura che solo i modelli con finestre di contesto di almeno 128K token possano partecipare in modo competitivo.
La selezione di documenti reali provenienti da sette categorie diverse introduce una variabilità stilistica e strutturale che riflette la complessità del mondo reale, dove i dati raramente sono presentati in formati uniformi. Questa diversità richiede al modello di adattarsi a diverse convenzioni di formattazione, terminologie specifiche di settore e strutture argomentative, aumentando la difficoltà del task di ragionamento. Ad esempio, un rapporto legale potrebbe richiedere un'interpretazione precisa di clausole contrattuali, mentre un sondaggio potrebbe necessitare di un'analisi statistica di base per estrarre significati dai dati aggregati. Questa eterogeneità impedisce al modello di affidarsi a pattern superficiali o a memorizzazione di formati specifici, costringendolo a sviluppare una comprensione semantica più profonda e flessibile.
Il requisito di circa 100.000 token di input per domanda non è solo una misura della lunghezza del contesto, ma anche un indicatore della densità informativa che il modello deve processare. In questo volume di dati, le informazioni rilevanti sono sparse e spesso nascoste tra dettagli irrilevanti, richiedendo al modello di filtrare il rumore e concentrarsi sugli elementi chiave per la risposta. Questa caratteristica rende AA-LCR un test rigoroso della capacità di attenzione selettiva e della gestione della memoria di lavoro, poiché il modello deve mantenere traccia delle informazioni pertinenti attraverso un flusso di testo esteso senza perdere il filo del ragionamento. La complessità derivante da questa struttura assicura che solo i modelli con architetture avanzate e capacità di contesto estese possano affrontare efficacemente le sfide poste dal benchmark.
Struttura del corpus AA-LCR
Riepilogo dei componenti principali del benchmark secondo la metodologia ufficiale.
| Componente | Dettaglio |
|---|---|
| Domande | 100 domande di testo basate sul ragionamento |
| Documenti | ~230-234 documenti reali di 7 categorie |
| Token per domanda | ~100.000 token di input |
| Requisito di contesto | Minimo 128K token di finestra di contesto |
Metodologia di valutazione v1.1 e il ruolo del giudice
La valutazione di AA-LCR è condotta in modo indipendente da Artificial Analysis, garantendo la neutralità del processo. Un aspetto tecnico fondamentale è l'uso di un modello di linguaggio come giudice (LLM-as-a-judge). Nella versione v1.1, si è osservato che alcuni fornitori, come NVIDIA nel suo modello Nemotron Labs Dory 1.0 4B, utilizzano chiavi di risposta corrette della versione v1.1 ma mantengono un modello giudice precedente, il che introduce sfumature nella comparabilità.
Il protocollo di punteggio normalizza i risultati su una scala da 0 a 1 (o percentuale). L'indipendenza della valutazione è fondamentale, sebbene la variabilità tra le esecuzioni del modello giudice e la possibile preferenza per risposte più lunghe o di uno specifico stile siano bias intrinseci a questo metodo. La riproducibilità è compromessa se non vengono standardizzate sia le chiavi di risposta sia la versione del modello giudice utilizzato per la valutazione.
L'uso di un modello di linguaggio come giudice introduce una dipendenza critica dalla qualità e dalla coerenza del modello di valutazione stesso. Se il modello giudice possiede bias intrinseci o limitazioni nella comprensione di determinati tipi di ragionamento, questi si rifletteranno direttamente nei punteggi assegnati, indipendentemente dalla qualità della risposta del modello candidato. Questo crea un rischio di allineamento imperfetto tra la metrica di valutazione e l'obiettivo reale di misurare la capacità di ragionamento, poiché il giudice potrebbe premiare risposte che sono stilisticamente coerenti con i suoi propri pattern di generazione piuttosto che risposte che sono logicamente rigorose e fattualmente accurate. La standardizzazione della versione del modello giudice diventa quindi un elemento fondamentale per garantire che i punteggi siano comparabili nel tempo e tra diversi modelli candidati.
La normalizzazione dei risultati su una scala da 0 a 1 cerca di mitigare le differenze di scala tra diverse esecuzioni, ma non elimina completamente la variabilità introdotta dalla natura stocastica dei modelli di linguaggio. In domande dove la risposta corretta è ambigua o dove esistono multiple interpretazioni valide, il modello giudice potrebbe assegnare punteggi diversi in esecuzioni ripetute, generando un rumore statistico che può oscurare le differenze reali tra i modelli candidati. Questo aspetto richiede un'attenta analisi statistica dei risultati, considerando non solo il punteggio medio ma anche la varianza e la distribuzione dei punteggi per ottenere una visione più completa delle prestazioni del modello. La riproducibilità del benchmark dipende quindi dalla capacità di controllare e documentare rigorosamente tutte le variabili del processo di valutazione, dalla versione del modello giudice alle condizioni di inferenza.
Flusso di valutazione AA-LCR
Passaggi generali del processo di punteggio nel benchmark.
- 01Il modello candidato elabora i ~100k token dei documenti.
- 02Il modello genera una risposta alla domanda di ragionamento.
- 03Un modello giudice (es. Qwen3) valuta la risposta rispetto alla chiave di risposta.
- 04Il punteggio viene normalizzato e aggregato per ottenere il punteggio finale del modello.
Limiti e bias nella valutazione del contesto lungo
L'uso di LLM come giudici introduce bias significativi. Questi modelli possono mostrare una preferenza per risposte più estese o per determinati stili di scrittura, il che non sempre si correla con la precisione fattuale. Inoltre, la variabilità tra le esecuzioni del giudice può generare rumore nei punteggi, specialmente in domande dove la risposta è ambigua o complessa.
Un altro limite critico è la contaminazione dei dati (data contamination). Dato che i documenti di AA-LCR sono reali e pubblici, esiste il rischio che i modelli di frontiera abbiano visto questi testi durante il loro addestramento. Sebbene Artificial Analysis tenti di mitigare questo problema, la generalizzazione dei risultati a task di produzione non garantiti è limitata. La saturazione della classifica, dove i modelli di frontiera si raggruppano in un intervallo ristretto di punti, suggerisce che il benchmark stia raggiungendo i suoi limiti di discriminazione.
Il rischio di contaminazione dei dati è particolarmente acuto in un benchmark che utilizza documenti reali e pubblici, poiché i modelli di frontiera sono addestrati su vasti corpus di testo che includono molto probabilmente questi stessi documenti. Se un modello ha visto i documenti di AA-LCR durante il suo addestramento, potrebbe aver memorizzato non solo i dati specifici ma anche le relazioni logiche tra di essi, il che gli permetterebbe di rispondere correttamente senza eseguire un vero ragionamento in tempo reale. Questo fenomeno, noto come memorizzazione, può gonfiare artificialmente i punteggi dei modelli che hanno avuto accesso a questi dati durante l'addestramento, rendendo difficile distinguere tra la vera capacità di ragionamento e la semplice memorizzazione di risposte pregresse. La mitigazione di questo rischio richiede l'uso di documenti non pubblici o la creazione di varianti sintetiche dei documenti, ma queste soluzioni introducono altre sfide in termini di realismo e complessità del task.
La saturazione della classifica, dove i modelli di frontiera si raggruppano in un intervallo ristretto di punti, suggerisce che il benchmark sta raggiungendo i suoi limiti di discriminazione per i modelli più avanzati. Questo fenomeno indica che AA-LCR potrebbe non essere più in grado di distinguere efficacemente tra i modelli di ultima generazione, poiché tutti possiedono le capacità minime richieste per affrontare le domande del benchmark. In questo scenario, il benchmark diventa meno utile come strumento di differenziazione fine, poiché le differenze di punteggio tra i modelli di vertice potrebbero essere attribuite a fattori casuali o a bias del modello giudice piuttosto che a differenze significative nelle capacità di ragionamento. Per mantenere la sua rilevanza, il benchmark potrebbe richiedere l'introduzione di domande ancora più complesse o di task che richiedano livelli superiori di inferenza e sintesi, superando le capacità attuali dei modelli di frontiera.
Interpretazione dei risultati e confronti validi
Per interpretare la classifica di AA-LCR, è essenziale considerare le condizioni di esecuzione. I confronti sono validi solo se effettuati sotto la stessa versione del benchmark e con condizioni di inferenza identiche. Le differenze nella quantizzazione, nel numero di iterazioni (loop) nelle architetture ricorrenti o nella versione del modello giudice possono invalidare i confronti diretti.
Nel caso di NVIDIA Nemotron Labs Dory 1.0 4B, la scheda del modello indica che i risultati di AA-LCR (63/71/73 per 1/2/4 loop) sono stime interne che possono deviare dai punteggi ufficiali di Artificial Analysis. Questo sottolinea la necessità di integrare AA-LCR con altre metriche e di verificare l'indipendenza della valutazione prima di prendere decisioni di deployment basate esclusivamente su questa classifica.
La validità dei confronti in AA-LCR dipende strettamente dalla standardizzazione delle condizioni di esecuzione, poiché anche piccole variazioni nei parametri di inferenza possono avere un impatto significativo sui risultati. La quantizzazione dei modelli, ad esempio, può alterare la precisione dei calcoli interni del modello, influenzando la sua capacità di eseguire ragionamenti complessi su contesti estesi. Allo stesso modo, il numero di iterazioni nelle architetture ricorrenti può modificare la profondità del ragionamento, con implicazioni dirette sulla qualità della risposta finale. Queste variabili devono essere controllate e documentate rigorosamente per garantire che i punteggi siano comparabili tra diversi modelli e versioni del benchmark. Senza questa standardizzazione, i confronti diretti possono essere fuorvianti, poiché le differenze di punteggio potrebbero riflettere le condizioni di esecuzione piuttosto che le capacità intrinseche del modello.
Il caso di NVIDIA Nemotron Labs Dory 1.0 4B illustra perfettamente queste sfide, dove l'uso di chiavi di risposta corrette della versione v1.1 con un modello giudice precedente introduce una discrepanza metodologica che rende i risultati non direttamente confrontabili con quelli della classifica ufficiale. Questa situazione evidenzia la necessità di una trasparenza totale nel processo di valutazione, dove ogni dettaglio, dalla versione del modello giudice alle chiavi di risposta utilizzate, deve essere chiaramente documentato e reso disponibile per la verifica indipendente. Senza questa trasparenza, è difficile per gli utenti finali valutare l'affidabilità dei punteggi e prendere decisioni informate basate sui risultati del benchmark. L'integrazione di AA-LCR con altre metriche e la verifica dell'indipendenza della valutazione diventano quindi passi essenziali per garantire che le decisioni di deployment siano basate su dati solidi e riproducibili.
Questioni aperte
- Non è stata confermata una formula esatta e pubblica di normalizzazione del punteggio del giudice Qwen3 in v1.1 che garantisca la riproducibilità assoluta.
- Il grado di contaminazione dei dati nei 234 documenti utilizzati non è quantificato nelle fonti primarie disponibili.
- La comparabilità esatta tra le valutazioni interne dei fornitori (come NVIDIA) e quelle ufficiali di Artificial Analysis rimane un'area di incertezza metodologica.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione