Introdução: o que é o AA-LCR e por que é relevante
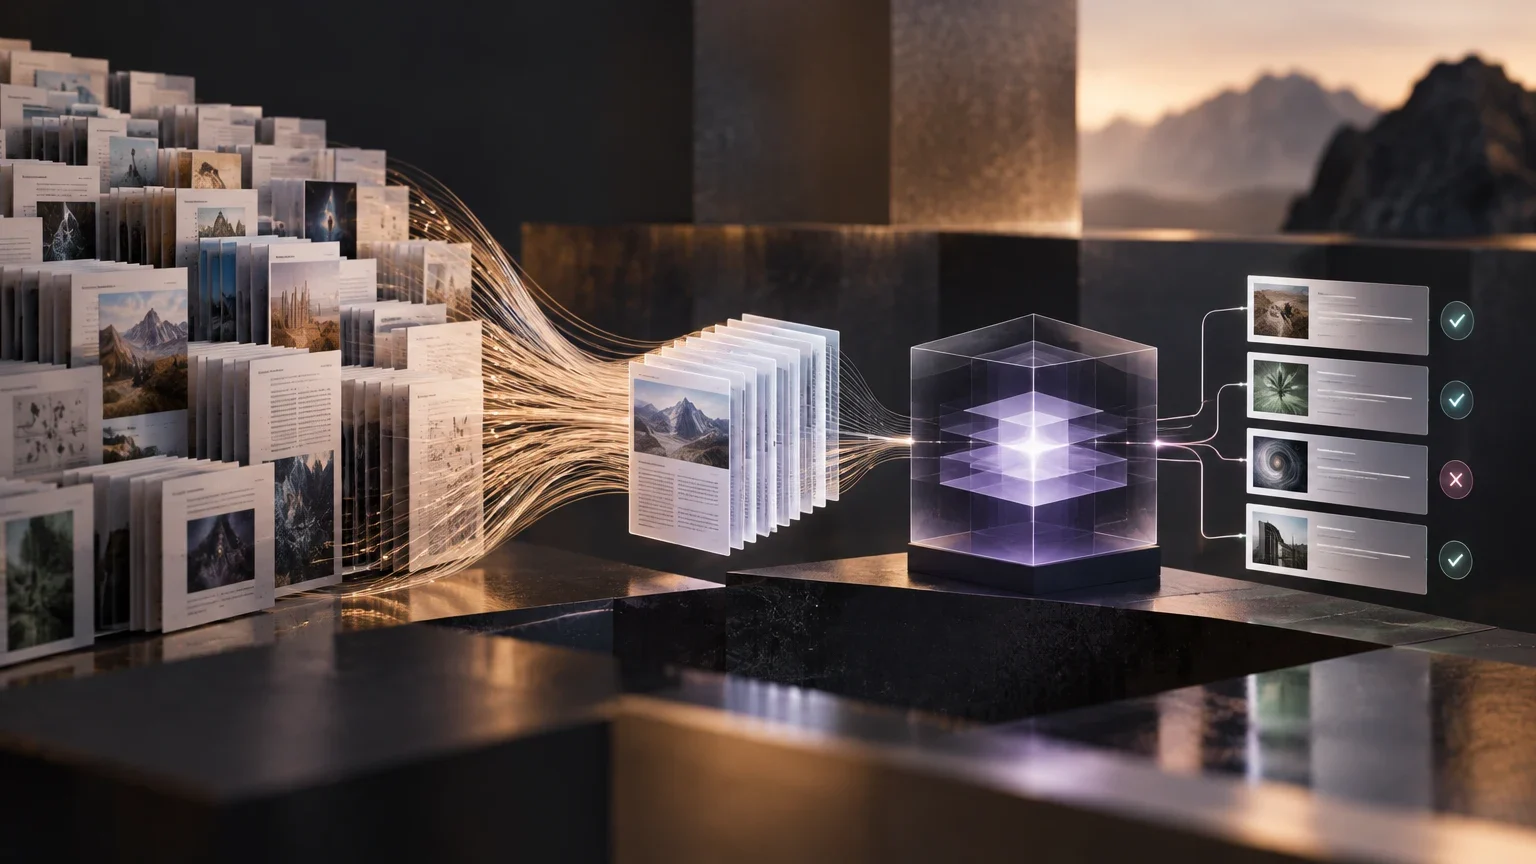
O benchmark Artificial Analysis Long Context Reasoning (AA-LCR) foi projetado para avaliar a capacidade dos modelos de linguagem de realizar raciocínio sobre contextos extensos, superando a simples recuperação de informações. Diferentemente dos testes de retrieval, que medem a capacidade de localizar um dado específico dentro de um texto, o AA-LCR exige que o modelo sintetize informações dispersas em múltiplas fontes para chegar a uma resposta que não está explicitamente presente em nenhum documento individual.
Essa distinção é crucial para engenheiros e arquitetos de sistemas que implementam tarefas de análise documental, compreensão de bases de código complexas ou fluxos de trabalho multi-etapas. A relevância do AA-LCR reside no seu foco em trabalho de conhecimento real, onde a inferência cruzada é mais valiosa do que a mera extração de dados. Ao replicar essas tarefas, o benchmark oferece uma métrica mais próxima das aplicações de produção do que os testes tradicionais de contexto longo.
A exigência de síntese em múltiplas fontes impõe uma carga cognitiva distinta ao modelo, que deve manter coerência lógica ao longo de dezenas de milhares de tokens sem perder o fio condutor da inferência. Isso diferencia o AA-LCR de testes que apenas verificam a retenção de fatos isolados, pois aqui a resposta final depende da capacidade de conectar premissas dispersas em documentos heterogêneos. Para equipes de engenharia, isso significa que o benchmark valida a robustez do raciocínio em cenários onde a informação não é linear, mas fragmentada e contextualmente dependente, refletindo a complexidade de sistemas de informação corporativos reais.
A relevância prática estende-se à arquitetura de sistemas que dependem de agentes autônomos para processar grandes volumes de dados não estruturados. Ao focar na inferência cruzada, o AA-LCR oferece uma métrica que aproxima a avaliação da realidade operacional, onde a extração simples de dados é insuficiente para tomada de decisão. Essa abordagem permite identificar modelos que não apenas recuperam informações, mas que as processam de forma integrada, uma competência crítica para fluxos de trabalho multi-etapas que exigem consistência e precisão em contextos extensos e complexos.
Arquitetura do benchmark: documentos e perguntas
A estrutura do AA-LCR baseia-se em um conjunto de 100 perguntas de alta dificuldade que requerem o processamento de aproximadamente 100.000 tokens de entrada por pergunta. Esses tokens provêm de um corpus de cerca de 230 a 234 documentos reais, abrangendo sete categorias principais: relatórios corporativos, relatórios setoriais, consultas governamentais, academia, jurídico, materiais de marketing e pesquisas.
O design das perguntas é rigoroso: cada uma foi verificada por humanos para garantir que exija inferência genuína. Por exemplo, uma pergunta pode solicitar o EBITDA ajustado de uma empresa específica após uma queda de 13,5% em sua receita operacional, obrigando o modelo a cruzar dados financeiros de vários trimestres e documentos de imprensa. Essa complexidade assegura que apenas modelos com janelas de contexto de pelo menos 128K tokens possam participar de forma competitiva.
A seleção de documentos reais de sete categorias distintas garante que o corpus represente a diversidade de formatos e estilos encontrados em ambientes de produção. Relatórios corporativos, acadêmicos e jurídicos, por exemplo, possuem estruturas e vocabulários específicos que testam a adaptabilidade do modelo a diferentes domínios de conhecimento. Essa variedade impede que o benchmark seja otimizado para um único tipo de texto, forçando os modelos a demonstrarem generalização e flexibilidade interpretativa ao lidar com fontes heterogêneas que exigem diferentes estratégias de análise e síntese.
O requisito de 128K tokens de janela de contexto não é apenas uma especificação técnica, mas uma barreira de entrada que filtra modelos incapazes de manter a atenção distribuída por longas sequências. A verificação humana de cada pergunta assegura que a dificuldade não seja artificial, mas derivada da necessidade genuína de cruzar dados complexos, como o exemplo do EBITDA ajustado após quedas de receita. Essa rigorosidade metodológica valida a utilidade do benchmark como um indicador de capacidade de raciocínio profundo, onde a mera memorização de padrões de texto é insuficiente para alcançar pontuações competitivas.
Estrutura do corpus AA-LCR
Resumo dos componentes principais do benchmark de acordo com a metodologia oficial.
| Componente | Detalhe |
|---|---|
| Perguntas | 100 perguntas de texto baseadas em raciocínio |
| Documentos | ~230-234 documentos reais de 7 categorias |
| Tokens por pergunta | ~100.000 tokens de entrada |
| Requisito de contexto | Mínimo de 128K tokens de janela de contexto |
Metodologia de avaliação v1.1 e o papel do juiz
A avaliação do AA-LCR é conduzida de forma independente pela Artificial Analysis, o que garante a neutralidade do processo. Um aspecto técnico fundamental é o uso de um modelo de linguagem como juiz (LLM-as-a-judge). Na versão v1.1, observou-se que alguns fornecedores, como a NVIDIA em seu modelo Nemotron Labs Dory 1.0 4B, utilizam chaves de resposta corrigidas da versão v1.1, mas mantêm um modelo juiz anterior, o que introduz nuances na comparabilidade.
O protocolo de pontuação normaliza os resultados em uma escala de 0 a 1 (ou porcentagem). A independência da avaliação é fundamental, embora a variabilidade entre execuções do modelo juiz e a possível preferência por respostas mais longas ou de certo estilo sejam vieses inerentes a este método. A reprodutibilidade é afetada se não forem padronizadas tanto as chaves de resposta quanto a versão do modelo juiz utilizado para a classificação.
A independência da Artificial Analysis na condução da avaliação é um pilar para a credibilidade dos resultados, pois evita conflitos de interesse que poderiam enviesar a pontuação. O uso de um modelo de linguagem como juiz, embora eficiente, introduz uma camada de subjetividade que deve ser rigorosamente controlada. A observação de que fornecedores como a NVIDIA utilizam chaves de resposta atualizadas, mas mantêm juízes anteriores, destaca a importância de padronizar todos os componentes do pipeline de avaliação. Sem essa uniformidade, as diferenças nas pontuações podem refletir variações metodológicas em vez de diferenças reais na capacidade dos modelos, comprometendo a comparabilidade dos resultados.
A normalização dos resultados em uma escala de 0 a 1 facilita a interpretação, mas a reprodutibilidade depende da estabilidade do modelo juiz e das chaves de resposta. A variabilidade inerente às execuções do juiz pode gerar flutuações nas pontuações, especialmente em perguntas complexas onde a resposta correta pode ter múltiplas formulações válidas. Portanto, a análise dos resultados deve considerar a margem de erro associada ao método de avaliação, reconhecendo que a precisão absoluta é limitada pela natureza probabilística dos modelos de linguagem utilizados como juízes, o que exige cautela na interpretação de diferenças mínimas entre modelos.
Fluxo de avaliação AA-LCR
Etapas gerais do processo de pontuação no benchmark.
- 01O modelo candidato processa os ~100k tokens de documentos.
- 02O modelo gera uma resposta à pergunta de raciocínio.
- 03Um modelo juiz (ex.: Qwen3) avalia a resposta contra a chave de resposta.
- 04A pontuação é normalizada e agregada para obter o score final do modelo.
Limites e vieses na avaliação de contexto longo
O uso de LLMs como juízes introduz vieses significativos. Esses modelos podem mostrar preferência por respostas mais extensas ou por certos estilos de redação, o que nem sempre correlaciona com a precisão factual. Além disso, a variabilidade entre execuções do juiz pode gerar ruído nas pontuações, especialmente em perguntas onde a resposta é ambígua ou complexa.
Outro limite crítico é a contaminação de dados (data contamination). Dado que os documentos do AA-LCR são reais e públicos, existe o risco de que os modelos de fronteira tenham visto esses textos durante seu treinamento. Embora a Artificial Analysis tente mitigar isso, a generalização dos resultados para tarefas de produção não garantidas é limitada. A saturação do leaderboard, onde os modelos de vanguarda se agrupam em uma faixa estreita de pontos, sugere que o benchmark está atingindo seus limites de discriminação.
Os vieses de estilo e extensão nas respostas avaliadas por LLMs podem distorcer a percepção da qualidade do raciocínio, favorecendo modelos que produzem textos mais elaborados, mesmo que menos precisos. Esse fenômeno é particularmente relevante em perguntas ambíguas, onde a clareza da resposta pode ser confundida com a correção factual. A variabilidade entre execuções do juiz amplifica esse risco, introduzindo ruído que pode mascarar diferenças reais de desempenho. Assim, a interpretação dos resultados deve levar em conta a possibilidade de que a pontuação reflita, em parte, a preferência do modelo juiz por certos padrões de redação, e não apenas a acurácia do raciocínio do modelo candidato.
A contaminação de dados é um desafio persistente, dado que os documentos do AA-LCR são públicos e podem ter sido incluídos nos conjuntos de treinamento de modelos de fronteira. Embora a Artificial Analysis implemente medidas de mitigação, a impossibilidade de garantir que nenhum modelo tenha visto esses textos durante o pré-treino limita a generalização dos resultados para tarefas inéditas. A saturação do leaderboard, com modelos de vanguarda agrupados em uma faixa estreita de pontos, sugere que o benchmark pode estar atingindo o teto de discriminação, tornando difícil diferenciar modelos de alta performance. Isso indica a necessidade de evoluir a metodologia para manter a relevância do AA-LCR como ferramenta de avaliação.
Interpretação de resultados e comparações válidas
Para interpretar o leaderboard do AA-LCR, é essencial considerar as condições de execução. As comparações são válidas apenas se realizadas sob a mesma versão do benchmark e com condições de inferência idênticas. Diferenças na quantização, no número de iterações (loops) em arquiteturas recorrentes ou na versão do modelo juiz podem invalidar comparações diretas.
No caso da NVIDIA Nemotron Labs Dory 1.0 4B, a ficha do modelo indica que os resultados do AA-LCR (63/71/73 para 1/2/4 loops) são estimativas internas que podem se desviar das pontuações oficiais da Artificial Analysis. Isso destaca a necessidade de complementar o AA-LCR com outras métricas e de verificar a independência da avaliação antes de tomar decisões de implantação baseadas exclusivamente neste ranking.
A validade das comparações no leaderboard do AA-LCR está intrinsecamente ligada às condições de inferência, incluindo a versão do benchmark, a quantização do modelo e o número de iterações em arquiteturas recorrentes. Diferenças nesses parâmetros podem invalidar comparações diretas, pois afetam a capacidade do modelo de processar o contexto e a consistência das respostas. A necessidade de padronização é crucial para garantir que as pontuações reflitam a capacidade intrínseca do modelo, e não artefatos de configuração. Portanto, ao interpretar os resultados, é essencial verificar se as condições de execução foram idênticas, evitando conclusões precipitadas baseadas em diferenças metodológicas.
O caso da NVIDIA Nemotron Labs Dory 1.0 4B ilustra os desafios de comparabilidade quando fornecedores utilizam metodologias internas que divergem das oficiais. A melhoria observada ao aumentar o número de loops, de 63 para 73, é significativa, mas a utilização de chaves corrigidas com um juiz antigo impede a comparação direta com o leaderboard oficial da Artificial Analysis. Isso reforça a importância de complementar o AA-LCR com outras métricas e de verificar a independência da avaliação antes de tomar decisões de implantação. A transparência sobre as condições de teste é fundamental para garantir que as decisões de arquitetura de sistemas sejam baseadas em evidências robustas e comparáveis.
Questões em aberto
- Não foi confirmada uma fórmula exata e pública de normalização da pontuação do juiz Qwen3 na v1.1 que garanta a reprodutibilidade absoluta.
- O grau de contaminação de dados nos 234 documentos utilizados não está quantificado nas fontes primárias disponíveis.
- A comparabilidade exata entre as avaliações internas de fornecedores (como a NVIDIA) e as oficiais da Artificial Analysis continua sendo uma área de incerteza metodológica.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção