Introducción: qué es AA-LCR y por qué es relevante
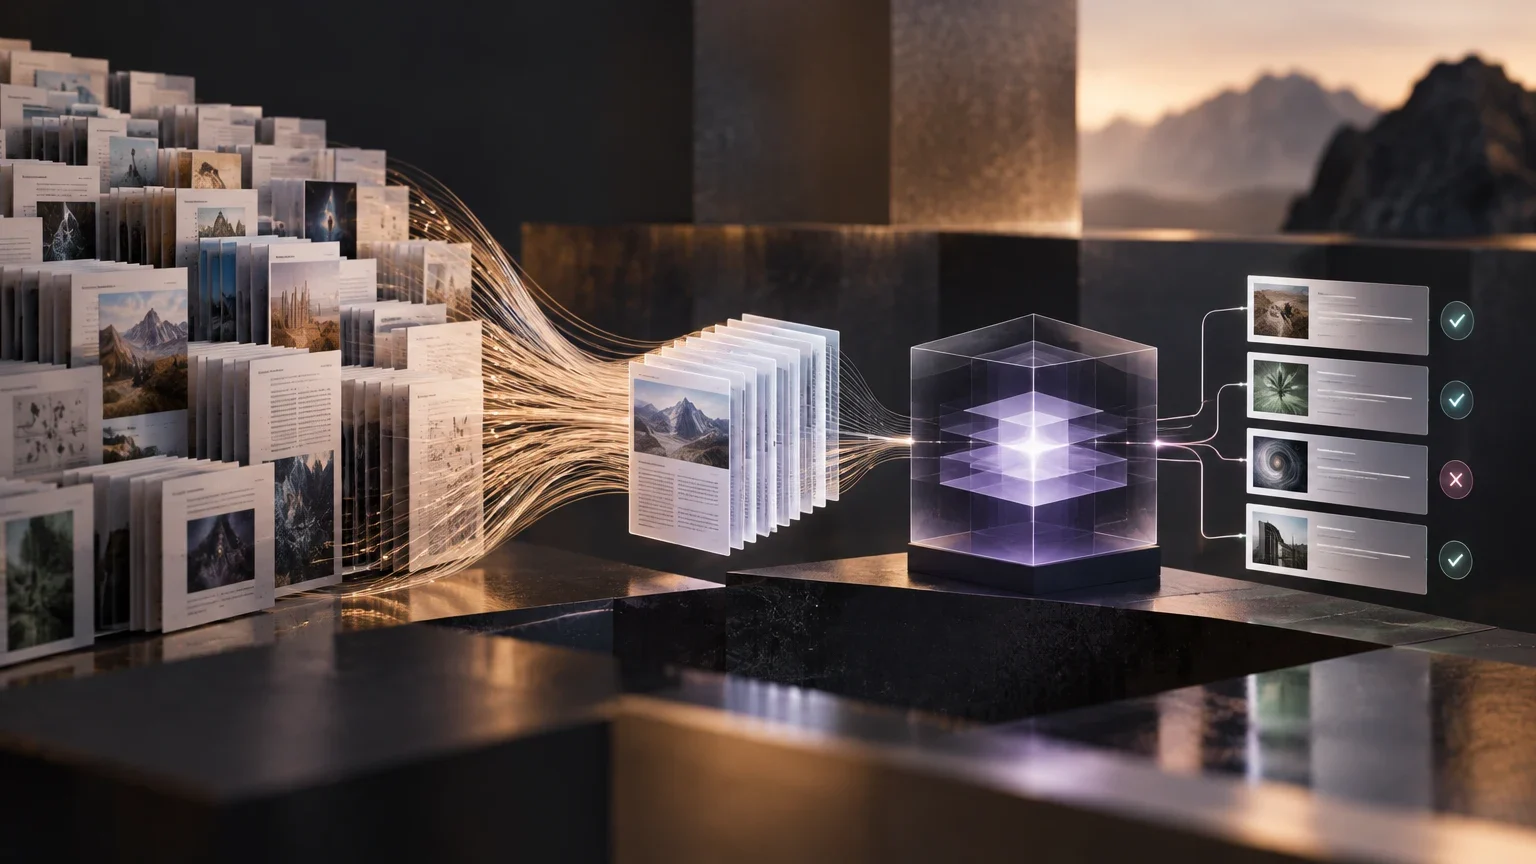
El benchmark Artificial Analysis Long Context Reasoning (AA-LCR) está diseñado para evaluar la capacidad de los modelos de lenguaje para realizar razonamiento sobre contextos extensos, superando la simple recuperación de información. A diferencia de las pruebas de retrieval, que miden la capacidad de localizar un dato específico dentro de un texto, AA-LCR exige que el modelo sintetice información dispersa en múltiples fuentes para llegar a una respuesta que no está explícitamente presente en ningún documento individual.
Esta distinción es crucial para ingenieros y arquitectos de sistemas que implementan tareas de análisis documental, comprensión de bases de código complejas o flujos de trabajo multi-paso. La relevancia de AA-LCR radica en su enfoque en el trabajo de conocimiento real, donde la inferencia cruzada es más valiosa que la mera extracción de datos. Al replicar estas tareas, el benchmark ofrece una métrica más cercana a las aplicaciones de producción que los tests de contexto largo tradicionales.
La distinción entre razonamiento y recuperación no es meramente teórica, sino que tiene implicaciones prácticas directas en la arquitectura de los sistemas de inteligencia artificial generativa. Cuando un modelo se enfrenta a una tarea de recuperación, su rendimiento depende en gran medida de la eficiencia de su mecanismo de atención para localizar patrones específicos dentro de una ventana de memoria. Sin embargo, en el contexto de AA-LCR, la capacidad de atención debe operar en conjunto con habilidades de inferencia lógica y síntesis semántica. Esto significa que un modelo puede tener una ventana de contexto amplia pero, si carece de la capacidad para mantener coherencia lógica a lo largo de miles de tokens, fallará en las tareas de AA-LCR. Por lo tanto, este benchmark actúa como un filtro que separa la capacidad bruta de almacenamiento de la capacidad cognitiva de procesamiento, un matiz que es fundamental para los equipos de ingeniería que buscan modelos capaces de manejar documentos complejos sin degradar la calidad de la respuesta final.
Arquitectura del benchmark: documentos y preguntas
La estructura de AA-LCR se basa en un conjunto de 100 preguntas de alta dificultad que requieren el procesamiento de aproximadamente 100.000 tokens de entrada por pregunta. Estos tokens provienen de un corpus de alrededor de 230 a 234 documentos reales, abarcando siete categorías principales: informes corporativos, informes de industria, consultas gubernamentales, academia, legal, materiales de marketing y encuestas.
El diseño de las preguntas es riguroso: cada una ha sido verificada por humanos para garantizar que requiera inferencia genuina. Por ejemplo, una pregunta podría pedir el EBITDA ajustado de una empresa específica tras una caída del 13,5% en sus ingresos operativos, obligando al modelo a cruzar datos financieros de varios trimestres y documentos de prensa. Esta complejidad asegura que solo los modelos con ventanas de contexto de al menos 128K tokens puedan participar de forma competitiva.
La selección de las siete categorías de documentos no es arbitraria, sino que refleja la diversidad de formatos y densidades de información que se encuentran en el mundo real. Los informes corporativos y de industria, por ejemplo, suelen presentar datos estructurados en tablas y gráficos que requieren una interpretación numérica precisa, mientras que los documentos legales y académicos exigen una comprensión profunda de la terminología específica y las relaciones causales sutiles. Al incluir materiales de marketing y encuestas, el benchmark también evalúa la capacidad del modelo para distinguir entre información factual y contenido persuasivo o subjetivo. Esta heterogeneidad obliga al modelo a adaptar su estrategia de procesamiento dinámicamente, ya que no puede aplicar un único enfoque de extracción para todos los tipos de texto. La verificación humana de cada pregunta asegura que la complejidad no provenga de ambigüedades lingüísticas innecesarias, sino de la necesidad genuina de cruzar información dispersa, lo que valida la relevancia de la métrica para escenarios de producción donde la precisión es crítica.
Estructura del corpus AA-LCR
Resumen de los componentes principales del benchmark según la metodología oficial.
| Componente | Detalle |
|---|---|
| Preguntas | 100 preguntas de texto basadas en razonamiento |
| Documentos | ~230-234 documentos reales de 7 categorías |
| Tokens por pregunta | ~100.000 tokens de entrada |
| Requisito de contexto | Mínimo 128K tokens de ventana de contexto |
Metodología de evaluación v1.1 y el papel del juez
La evaluación de AA-LCR es conducida de forma independiente por Artificial Analysis, lo que garantiza la neutralidad del proceso. Un aspecto técnico fundamental es el uso de un modelo de lenguaje como juez (LLM-as-a-judge). En la versión v1.1, se ha observado que algunos proveedores, como NVIDIA en su modelo Nemotron Labs Dory 1.0 4B, utilizan claves de respuesta corregidas de la versión v1.1 pero mantienen un modelo juez anterior, lo que introduce matices en la comparabilidad.
El protocolo de puntuación normaliza los resultados en una escala del 0 al 1 (o porcentaje). La independencia de la evaluación es clave, aunque la variabilidad entre ejecuciones del modelo juez y la posible preferencia por respuestas más largas o de cierto estilo son sesgos inherentes a este método. La reproducibilidad se ve afectada si no se estandarizan tanto las claves de respuesta como la versión del modelo juez utilizado para la calificación.
El papel del modelo juez en la versión v1.1 es un componente crítico que requiere una atención especial por parte de los analistas. La decisión de utilizar un LLM como juez, en lugar de una comparación exacta de cadenas de texto, se debe a la naturaleza abierta de las preguntas de razonamiento, donde múltiples formulaciones pueden ser correctas. Sin embargo, esta flexibilidad introduce una capa de subjetividad que debe ser gestionada rigurosamente. La observación de que algunos proveedores, como NVIDIA, han utilizado claves de respuesta actualizadas pero con un modelo juez anterior, destaca la importancia de la alineación temporal entre los componentes del pipeline de evaluación. Si el modelo juez no está actualizado para comprender las matices de las claves corregidas, la puntuación resultante puede ser inconsistente con las evaluaciones realizadas por Artificial Analysis. Esto subraya la necesidad de documentar exhaustivamente la versión de cada componente del sistema de evaluación para garantizar que los resultados sean reproducibles y comparables entre diferentes proveedores y configuraciones.
Flujo de evaluación AA-LCR
Pasos generales del proceso de puntuación en el benchmark.
- 01El modelo candidato procesa los ~100k tokens de documentos.
- 02El modelo genera una respuesta a la pregunta de razonamiento.
- 03Un modelo juez (ej. Qwen3) evalúa la respuesta contra la clave de respuesta.
- 04La puntuación se normaliza y se agrega para obtener el score final del modelo.
Límites y sesgos en la evaluación de contexto largo
El uso de LLMs como jueces introduce sesgos significativos. Estos modelos pueden mostrar preferencia por respuestas más extensas o por ciertos estilos de redacción, lo que no siempre correlaciona con la precisión factual. Además, la variabilidad entre ejecuciones del juez puede generar ruido en las puntuaciones, especialmente en preguntas donde la respuesta es ambigua o compleja.
Otro límite crítico es la contaminación de datos (data contamination). Dado que los documentos de AA-LCR son reales y públicos, existe el riesgo de que los modelos de frontera hayan visto estos textos durante su entrenamiento. Aunque Artificial Analysis intenta mitigar esto, la generalización de los resultados a tareas de producción no garantizadas es limitada. La saturación del leaderboard, donde los modelos de vanguardia se agrupan en un rango estrecho de puntos, sugiere que el benchmark está alcanzando sus límites de discriminación.
La contaminación de datos representa uno de los desafíos más difíciles de cuantificar en la evaluación de modelos de lenguaje de gran escala. Dado que los documentos utilizados en AA-LCR son públicos y provienen de fuentes accesibles, es probable que los modelos de frontera hayan sido expuestos a ellos durante su fase de preentrenamiento o afinamiento. Aunque Artificial Analysis implementa medidas para mitigar este riesgo, la ausencia de una cuantificación exacta del grado de exposición limita la capacidad de generalizar los resultados a escenarios donde los documentos no han sido vistos previamente por el modelo. Este factor es particularmente relevante para las empresas que despliegan modelos en entornos con datos propietarios o altamente específicos, donde la capacidad de razonamiento sobre información nueva es más importante que el reconocimiento de patrones memorizados. Por lo tanto, los usuarios deben considerar AA-LCR como una métrica de capacidad de razonamiento en un contexto controlado, pero no como una garantía absoluta de rendimiento en todos los dominos de aplicación.
Interpretación de resultados y comparaciones válidas
Para interpretar el leaderboard de AA-LCR, es esencial considerar las condiciones de ejecución. Las comparaciones son válidas solo si se realizan bajo la misma versión del benchmark y con condiciones de inferencia idénticas. Las diferencias en la cuantización, el número de iteraciones (loops) en arquitecturas recurrentes o la versión del modelo juez pueden invalidar las comparaciones directas.
En el caso de NVIDIA Nemotron Labs Dory 1.0 4B, la tarjeta del modelo indica que los resultados de AA-LCR (63/71/73 para 1/2/4 loops) son estimaciones internas que pueden desviarse de las puntuaciones oficiales de Artificial Analysis. Esto subraya la necesidad de complementar AA-LCR con otras métricas y de verificar la independencia de la evaluación antes de tomar decisiones de despliegue basadas únicamente en este ranking.
La interpretación de los resultados de AA-LCR requiere un enfoque crítico que vaya más allá de la simple lectura del ranking. Las diferencias en las condiciones de inferencia, como la cuantización del modelo o el número de iteraciones en arquitecturas recurrentes, pueden tener un impacto significativo en la puntuación final. En el caso de NVIDIA Nemotron Labs Dory 1.0 4B, la mejora observada al aumentar el número de loops ilustra cómo la configuración del modelo puede alterar su rendimiento en tareas de contexto largo. Sin embargo, dado que estas evaluaciones internas utilizan componentes que no son idénticos a los del leaderboard oficial, como un modelo juez anterior, los números publicados por el proveedor deben ser tratados con cautela. Los equipos de ingeniería deben complementar la información de AA-LCR con pruebas de estrés propias y evaluaciones en dominos específicos de su aplicación para tomar decisiones de despliegue informadas. La transparencia sobre las condiciones de evaluación es, por tanto, un requisito indispensable para cualquier comparación válida entre modelos.
Qué sigue abierto
- No se ha confirmado una fórmula exacta y pública de normalización de la puntuación del juez Qwen3 en v1.1 que garantice la reproducibilidad absoluta.
- El grado de contaminación de datos en los 234 documentos utilizados no está cuantificado en las fuentes primarias disponibles.
- La comparabilidad exacta entre las evaluaciones internas de proveedores (como NVIDIA) y las oficiales de Artificial Analysis sigue siendo un área de incertidumbre metodológica.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección