Token für Token generieren: Welche Kosten die Technik senken soll
Bei der üblichen autoregressiven Generierung erzeugt das Modell zunächst ein Token und wird anschließend erneut ausgeführt, um das nächste Token zu erzeugen – abhängig von den vorangegangenen Tokens. Diese Folge von Schritten begrenzt, wie viel sich innerhalb einer einzelnen Antwort parallelisieren lässt: Das nächste Token hängt vom Zustand ab, den das vorherige hinterlassen hat. Das bedeutet nicht, dass sämtliche Operationen eines Durchlaufs strikt sequenziell ablaufen. Die Generierung bildet jedoch eine Abhängigkeitskette zwischen den Tokens.
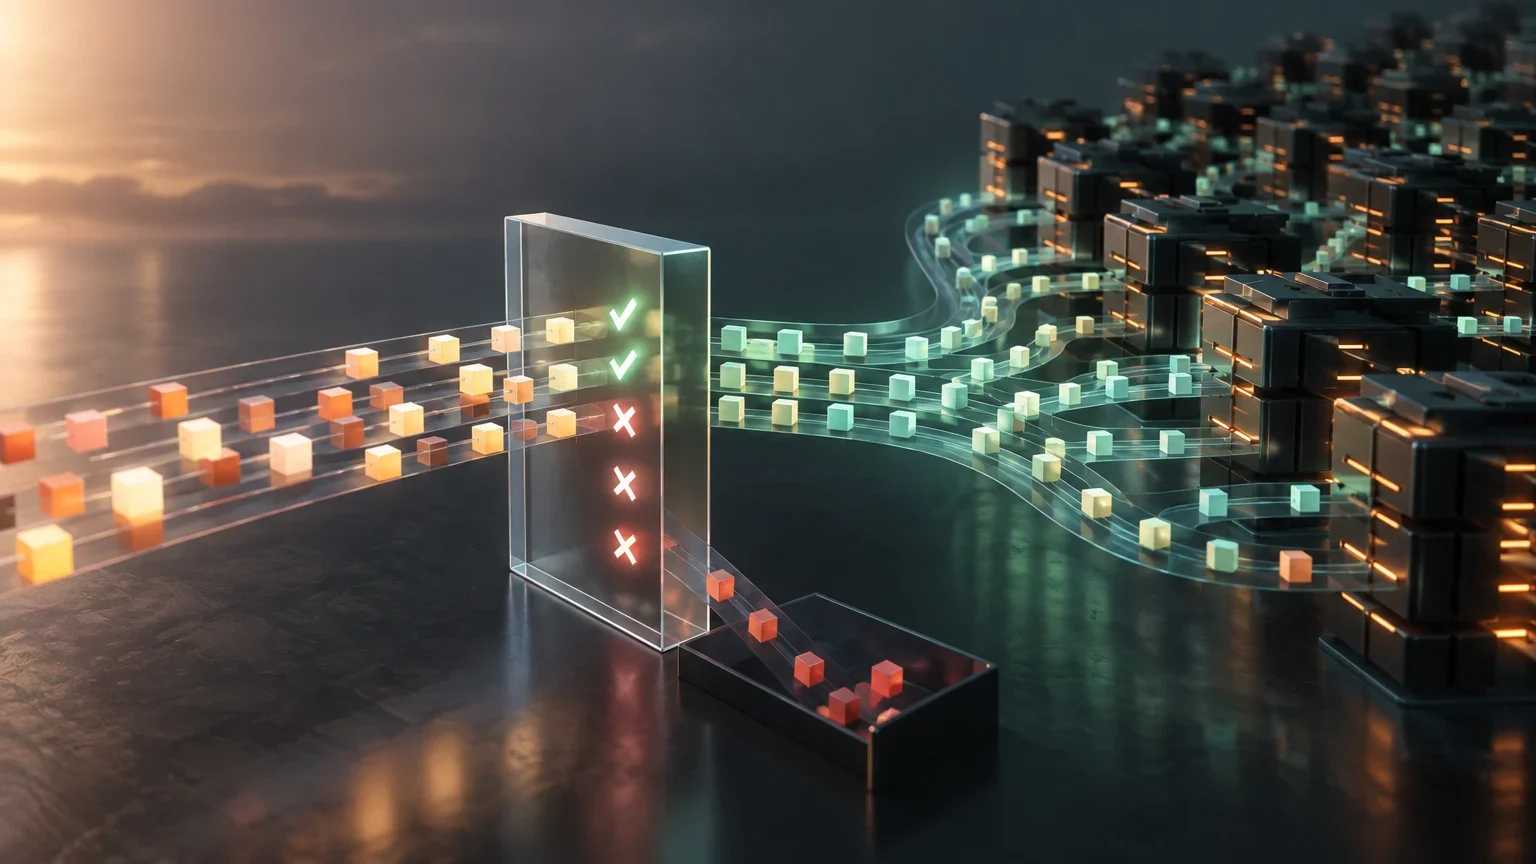
Spekulatives Decoding versucht, eine Asymmetrie auszunutzen: Es kann günstiger sein, mehrere Tokens mit einem Hilfsmodell oder einem anderen Hilfsmechanismus vorzuschlagen und sie gemeinsam mit dem Zielmodell zu überprüfen, als jedes Ausgabetoken durch einen erneuten Durchlauf des Zielmodells zu erzeugen. Die Methode erspart dem Zielmodell nicht die Arbeit. Sie ordnet sie so um, dass ein Durchlauf mehr als ein Token validieren kann, wenn die Vorschläge nützlich sind und die Verifikation effizient erfolgt.
Bei der Leistungsbewertung geht es daher nicht nur darum, wie viele Tokens der Entwurf vorschlägt oder wie viele das Zielmodell akzeptiert. Entscheidend ist auch, welche Kosten bei der Erzeugung der Kandidaten anfallen, wie aufwendig ihre Verifikation ist und wie die Runtime diese Operationen plant. Eine Technik kann sequenzielle Schritte reduzieren und zugleich zusätzliche Berechnungen verursachen, die den Gewinn wieder aufheben.
So funktioniert Draft-and-Verify
Beim einfachen Verfahren schlägt ein Entwurfsmodell eine Folge von Kandidaten vor. Das Zielmodell berechnet die zugehörigen Verteilungen für die Positionen dieser Folge. Das Verifikationsverfahren entscheidet anschließend, welche Kandidaten übernommen werden können. Besteht ein Kandidat die Prüfung nicht, wird der betreffende Schritt korrigiert und die Generierung vom passenden Ergebnis aus fortgesetzt. Die gemeinsame Verifikation mehrerer Kandidaten in einem Durchlauf eröffnet mehr Parallelität als die Generierung Token für Token.
Der Entwurf muss nicht immer mit dem übereinstimmen, was das Zielmodell erzeugt hätte. Entscheidend ist, dass Akzeptanz und Korrektur der Kandidaten beim Sampling so gestaltet sind, dass das Endergebnis unter den Voraussetzungen des Verfahrens dieselbe Verteilung wie das Zielmodell hat. Deshalb sollte man das Verfahren nicht als ungefähren Ersatz für das Zielmodell beschreiben: Die Ausgabeverteilung wird weiterhin vom Zielmodell bestimmt.
Die Zahl der akzeptierten Tokens ist nur ein Teil der Rechnung und kein vollständiges Geschwindigkeitsmaß. Eine hohe Akzeptanz kann mit einer kostspieligen Verifikation einhergehen. Eine niedrigere Akzeptanz kann wettbewerbsfähig sein, wenn der Entwurf günstig ist und die Runtime die zusätzliche Arbeit effizient ausführt. Auch die Länge der spekulativen Sequenz ist ein Kompromiss: Mehr vorgeschlagene Kandidaten können die Kosten für Entwurf und Verifikation erhöhen.
Vereinfachter Ablauf von Vorschlag und Verifikation
- 01Der Entwurfsmechanismus schlägt ein oder mehrere Kandidatentokens vor.
- 02Das Zielmodell wertet die Kandidaten aus und berechnet die für ihre Verifikation erforderlichen Verteilungen.
- 03Das Verfahren akzeptiert Kandidaten, die mit dem spekulativen Sampling vereinbar sind, und korrigiert gegebenenfalls die Stelle, an der ein Kandidat abgelehnt wird.
- 04Die Generierung wird mit der validierten Sequenz fortgesetzt. Ob dadurch Arbeit eingespart wird, hängt von den Gesamtkosten dieses Ablaufs im Vergleich zum Referenzverfahren ab.
Die Ausgabeverteilung zu bewahren, garantiert keine Leistungssteigerung
Die Arbeit von Leviathan und seinen Mitautoren beschreibt spekulatives Decoding als Möglichkeit, die Inferenz zu beschleunigen, ohne die Ausgabeverteilung des Zielmodells zu verändern. Diese Garantie hängt vom Samplingverfahren und den mathematischen Voraussetzungen der Methode ab. Sie besagt nicht, dass jede erzeugte Antwort mit einer konkreten Antwort aus einem gewöhnlichen Decoding-Durchlauf identisch ist. Es geht um die Verteilung der Ausgaben, nicht um die zwingende Übereinstimmung jedes zufälligen Generierungspfads.
Die Garantie sagt auch nicht aus, dass jede Konfiguration schneller ist. Sie legt weder die Kosten des Entwurfs fest noch die Effizienz der Operationen auf dem Beschleuniger, das Verhalten des Schedulers bei parallelen Anfragen oder den verfügbaren Speicher. Diese Faktoren gehören zur Ausführung. In der Praxis müssen die Korrektheit des Samplings und der betriebliche Nutzen getrennt voneinander geprüft werden.
Diese Unterscheidung verhindert einen häufigen, aber falschen Schluss: Dass ein Verfahren die Zielverteilung erhält, bedeutet nicht, dass es das Modell universell beschleunigt. Die präzisere Aussage lautet: Das Verfahren kann die Verteilung bewahren und einen Leistungsgewinn erzielen, wenn Vorschlag, Verifikation und Implementierung unter den gemessenen Bedingungen günstig zusammenwirken.
Von EAGLE zu EAGLE-3: Der Vorschlag ändert sich, nicht der Bewertungsmaßstab
EAGLE gestaltet spekulative Vorhersagen mithilfe interner Merkmalsinformationen neu, anstatt den Entwurf lediglich als unabhängige Quelle von Tokens zu behandeln. Die Arbeit stellt einen Ansatz vor, der auf die Unsicherheit dieser Merkmale ausgerichtet ist. Dieser Designunterschied ist relevant, weil der Vorschlagsmechanismus beeinflusst, welche Kandidaten zur Verifikation gelangen und welche Kosten bei ihrer Erzeugung entstehen.
EAGLE-3 ist eine spätere Variante. Die zugehörige Arbeit befasst sich mit der Skalierung der Beschleunigung durch einen Trainingsansatz, der im Titel des Artikels als „training-time test“ bezeichnet wird. Ihre Messwerte sollten nicht so dargestellt werden, als wären sie unmittelbar mit denen jeder beliebigen EAGLE-Implementierung oder des einfachen Grundverfahrens vergleichbar. Für einen belastbaren Vergleich müssen Modell, Runtime, Hardware, Generierungskonfiguration und Workload jedes Experiments bekannt sein.
Insbesondere lässt sich ein für SGLang berichtetes Ergebnis nicht ohne Weiteres auf vLLM übertragen. Ebenso wenig ist ein Ergebnis bei einer bestimmten Batch-Größe eine Vorhersage für ein anderes Verkehrsmuster. Die Methodenunterschiede sind wichtig, aber auch Infrastruktur und Evaluierungsprotokoll sind Teil des Ergebnisses.
Was beim Vergleich von Varianten getrennt betrachtet werden muss
| Aspekt | Zu prüfende Frage | Warum es wichtig ist |
|---|---|---|
| Methode | Wird einfaches spekulatives Decoding, EAGLE, EAGLE-3 oder eine andere Variante verwendet? | Vorschlagsstrategien und ihre Kosten sind nicht notwendigerweise gleich. |
| Runtime | Bezieht sich die Messung auf vLLM, SGLang oder eine andere Umgebung? | Planung und Implementierung können die tatsächlich anfallende Arbeit verändern. |
| Workload | Welche Batch-Größen, Parallelitätsgrade und Anfrageprofile wurden gemessen? | Ein Gewinn bei einem Workload belegt keinen Gewinn bei einem anderen. |
| Metrik | Werden Latenz, Durchsatz, Akzeptanz oder andere Größen angegeben? | Jede Metrik beantwortet eine andere Frage. |
Was die Studie von 2026 zeigt – und was sie nicht belegen kann
Das Preprint „Speculative Decoding: Performance or Illusion?“ untersucht verschiedene Varianten des spekulativen Decodings systematisch mit vLLM und unterschiedlichen Modellen, Workloads und Batch-Größen. Zu den in der Beschreibung der Arbeit hervorgehobenen Ergebnissen zählt, dass die Verifikation durch das Zielmodell einen erheblichen Teil der Ausführung beanspruchen kann und die Token-Akzeptanz je nach Position, Anfrage und Datensatz variiert. Diese Beobachtungen stellen infrage, ob eine einzige durchschnittliche Akzeptanzrate als ausreichender Indikator dienen kann.
Die sinnvolle Schlussfolgerung lautet nicht, dass die Technik niemals beschleunigt, sondern dass es darauf ankommt, wo die Zeit anfällt. Wenn die Verifikation der Kandidaten einen großen Teil der Rechenarbeit beansprucht, kann der Vorteil, mehrere Tokens zu akzeptieren, kleiner werden. Und wenn die Akzeptanz zwischen Positionen oder Anfragen schwankt, kann ein aggregierter Durchschnitt Fälle verbergen, in denen sich die zusätzliche Arbeit des Entwurfs nicht auszahlt.
Die für diesen Beitrag geprüften Informationen reichen nicht aus, um sämtliche Varianten, Modelle, Workloads, Batch-Größen, primären Metriken und genauen Konfigurationen des Preprints vollständig aufzulisten. Sie ermöglichen auch nicht, die Werte aller Experimente zu reproduzieren. Deshalb werden hier weder Zahlen zugeschrieben noch Aussagen getroffen, wonach eine bestimmte Variante in allen Szenarien überlegen wäre. Für eine quantitative Bewertung müssen diese Details im vollständigen Text und in der Konfiguration jedes Experiments geprüft werden.
Das Preprint und die Grundlagenarbeit beantworten unterschiedliche Fragen. Die erste Arbeit untersucht das Verhalten von Implementierungen und Workloads in einer Runtime. Die zweite begründet, wie das Samplingverfahren die Ausgabeverteilung bewahren kann. Das mathematische Ergebnis der Grundlagenarbeit als Leistungsnachweis für eine bestimmte vLLM-Konfiguration zu verwenden, würde unterschiedliche Evidenzebenen vermischen.
Warum die Akzeptanz allein die Geschwindigkeit nicht erklärt
Eine Akzeptanzrate oder -länge beschreibt, welcher Anteil des Vorschlags die Verifikation übersteht. Sie erfasst jedoch nicht weitere Kosten: die Ausführung des Entwurfsmodells, die Vorbereitung benötigter Zustände, die Verifikation der Kandidaten und die Koordination der Operationen innerhalb der Runtime. Für sich genommen zeigt sie auch nicht, wie lange eine vollständige Anfrage dauert oder wie viele Anfragen das System pro Zeiteinheit bedienen kann.
Bei paralleler Verarbeitung wird diese Unterscheidung noch wichtiger. Ein gemeinsam genutzter Dienst verarbeitet Anfragen, die um Ressourcen konkurrieren und unterschiedlich lang sein können. Wenn Batch-Größe oder Parallelität zunehmen, kann sich die nützliche Arbeit pro Durchlauf ebenso ändern wie der Druck auf Speicher und Planung. Eine bei kleiner Batch-Größe gemessene Latenzverbesserung beweist weder, dass die Warteschlangenlatenz in einem ausgelasteten Dienst sinkt, noch, dass dessen Kapazität steigt.
Mindestens drei Ergebnisse sollten getrennt betrachtet werden. Die Gesamtlatenz gibt an, wie lange eine Anfrage bis zum Abschluss wartet. Die Latenz pro Token beschreibt das Generierungstempo, wobei die Definition der Messung explizit angegeben werden muss. Der Durchsatz misst die pro Zeiteinheit abgeschlossene Arbeitsmenge. Diese Größen sind nicht austauschbar; eine Optimierung kann eine davon verbessern, ohne die anderen im gleichen Umfang zu steigern.
Wie sich eine Beschleunigungsbehauptung bewerten lässt
Der Vergleich braucht eine eindeutige Referenz: das autoregressive Decoding, das dasselbe Modell in derselben Umgebung verwenden würde. Wenn Runtime, Hardware oder Konfiguration gleichzeitig geändert werden, lässt sich der Unterschied nicht sicher der spekulativen Technik zuschreiben. Auch die Bedingungen der Generierung müssen genau angegeben werden, denn sie beeinflussen die geprüften Verteilungen und das Arbeitsprofil.
Anschließend sollten Teams Metriken auswählen, die zum Ziel passen. Bei einer einzelnen Interaktion kann die wahrgenommene Latenz entscheidend sein; bei einem Dienst mit schwankender Nachfrage die Latenzverteilung und die Kapazität unter Parallelität; für die Gesamtkapazität der Durchsatz. Token-Akzeptanz und Verifikationskosten helfen, ein Ergebnis zu erklären, ersetzen aber keine Dienstmetriken.
Die offizielle vLLM-Dokumentation weist darauf hin, dass die Ergebnisse von Modell, Traffic, Hardware und Konfiguration abhängen, und empfiehlt Messungen in der vorgesehenen Umgebung. Dieser Hinweis macht ein offengelegtes Protokoll nicht überflüssig: Erst dadurch wird erkennbar, für welchen Kontext das Ergebnis gilt und ob eine Reproduktion sinnvoll möglich ist.
Praktisches Evaluierungsprotokoll
- 01Zielmodell, Referenzmethode, Runtime, Hardware und Generierungskonfiguration festlegen.
- 02Einen repräsentativen Workload definieren, einschließlich der zu untersuchenden Batch-Größen und Parallelitätsstufen.
- 03Die zum Dienstziel passenden Latenz- und Durchsatzmetriken messen; außerdem Akzeptanz und Verifikationskosten erfassen, um das Ergebnis erklären zu können.
- 04Messungen unter identischen Bedingungen wiederholen und Unterschiede zwischen Batch-Größen und Traffic-Mustern dokumentieren.
- 05Ergebnisse für jede Variante und Umgebung getrennt angeben, statt Messwerte aus unterschiedlichen Protokollen zu einer einzigen Rangliste zusammenzufassen.
Fazit: Belastbare Evidenz bezieht sich auf das gesamte System
Spekulatives Decoding bietet eine Strategie, die sequenziellen Kosten der Token-Generierung zu senken: Mehrere Kandidaten werden vorgeschlagen und anschließend mit dem Zielmodell verifiziert. Das Samplingverfahren kann die Ausgabeverteilung des Zielmodells bewahren. Diese Eigenschaft verspricht für sich genommen jedoch weder eine niedrigere Latenz noch einen höheren Durchsatz oder geringere Betriebskosten.
Die Grundlagenarbeit, Varianten wie EAGLE und EAGLE-3 sowie die Studie von 2026 liefern unterschiedliche Arten von Evidenz. Die Samplingtheorie erklärt eine Garantie; die Arbeiten zu den Varianten beschreiben andere Mechanismen und deren Evaluierungen; die vLLM-Studie untersucht, wie Methoden, Workloads und Batch-Größen in einer Runtime zusammenspielen. Diese Ergebnisse dürfen nicht so zusammengeführt werden, als stammten sie aus einem einzigen kontrollierten Test.
Für eine Produktionsentscheidung ist entscheidend, ob die konkrete Kombination aus Modell, Vorschlagsmechanismus, Runtime, Beschleuniger und Anfrageprofil die für den Dienst wichtigen Metriken verbessert. Die Mindestgrundlage ist ein reproduzierbarer Vergleich mit einer gleichwertigen Referenz und unter der erwarteten Parallelität. Bis ein solcher Nachweis vorliegt, ist eine in einem begrenzten Test beobachtete Beschleunigung eine zu prüfende Hypothese – keine Garantie für mehr Kapazität.
Entscheidungshilfe für Inferenzteams
| Wenn die Frage lautet … | Benötigte Evidenz |
|---|---|
| Bleibt die Zielverteilung erhalten? | Das Samplingverfahren und die Bedingungen, unter denen seine Korrektheit gilt. |
| Sinkt die Latenz einer einzelnen Anfrage? | Eine Latenzmessung mit gleichwertiger Referenz und Konfiguration. |
| Steigt die Kapazität des Dienstes? | Durchsatzmessungen unter der erwarteten Parallelität und dem vorgesehenen Traffic-Muster. |
| Lässt sich das Ergebnis verallgemeinern? | Tests mit den Modellen, der Runtime, der Hardware und den Workloads, für die die Technik eingesetzt werden soll. |
Offene Fragen
- Die für diesen Beitrag geprüften Informationen schlüsseln nicht sämtliche im Preprint von 2026 untersuchten Varianten, Modelle, Workloads, Batch-Größen und primären Metriken auf.
- Hier werden keine experimentellen Zahlen genannt; außerdem liegen nicht genügend Details vor, um jeden Vergleich der Studie von 2026 unabhängig zu rekonstruieren.
- Ausmaß und Entwicklung der Beschleunigung bei höherer Parallelität hängen von der konkreten Konfiguration ab. Aus den zusammengefassten Quellen lässt sich kein universeller quantitativer Trend ableiten.
- Die Evaluierungen von EAGLE und EAGLE-3 fanden unter Bedingungen statt, die weder untereinander noch mit denen der vLLM-Studie als gleichwertig angenommen werden dürfen.
Weiter entdecken
Verwendete Quellen
Korrekturen und Transparenz
Wenn du falsche oder veraltete Angaben findest, sende uns die Seite und die zu prüfende Quelle.
Korrektur vorschlagen