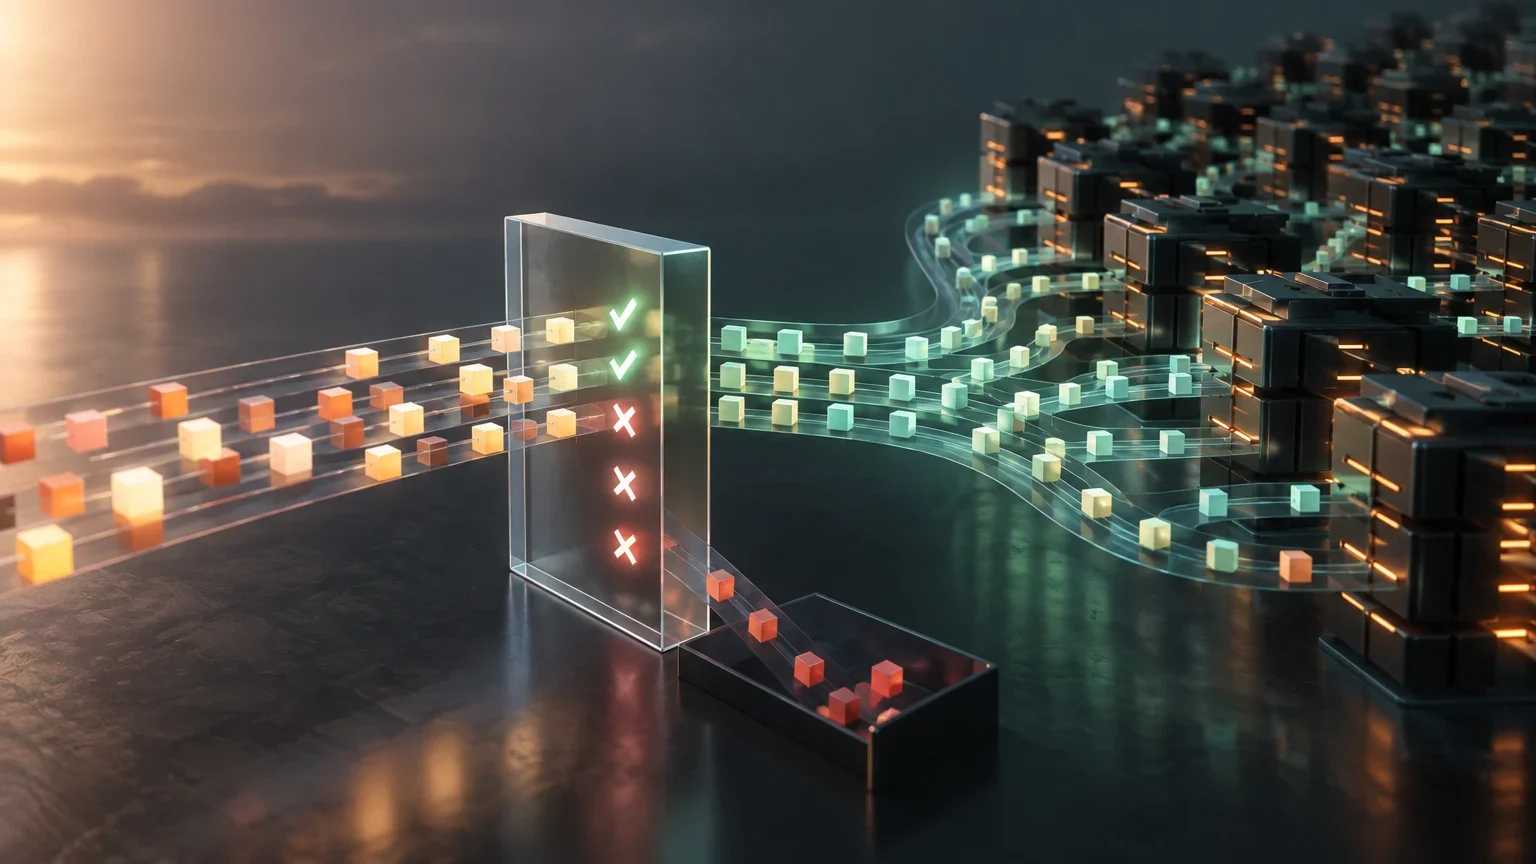
Gerar token a token: o custo que a técnica tenta reduzir
Na geração autorregressiva habitual, o modelo produz um token e, em seguida, volta a ser executado para produzir o seguinte, condicionado pelos tokens anteriores. A sequência de etapas limita o quanto é possível paralelizar o cálculo ao longo de uma mesma resposta: o token seguinte depende do estado deixado pelo anterior. Isso não significa que todas as operações de uma execução sejam estritamente sequenciais, mas a geração impõe uma cadeia de dependências entre tokens.
A decodificação especulativa tenta tirar partido de uma assimetria: pode ser mais barato propor vários tokens com um modelo ou mecanismo auxiliar e verificá-los em conjunto com o modelo-alvo do que gerar cada token de saída com uma nova passagem deste último. A ideia não elimina o trabalho do modelo-alvo. Reorganiza-o para que, quando os candidatos forem úteis e a verificação for eficiente, uma execução consiga validar mais de um token.
A questão do desempenho, portanto, não é apenas quantos tokens o modelo auxiliar propõe ou quantos o modelo-alvo aceita. Também importa o custo de preparar os candidatos, o trabalho necessário para os verificar e a forma como o runtime agenda essas operações. Uma técnica pode reduzir o número de etapas sequenciais e, ao mesmo tempo, acrescentar cálculos que anulam a poupança.
Como funciona o esquema draft-and-verify
No esquema básico, um modelo auxiliar propõe uma sequência de candidatos. O modelo-alvo calcula as distribuições correspondentes às posições dessa sequência, e o procedimento de verificação decide quais candidatos podem ser mantidos. Se um candidato não passar na verificação, a etapa é corrigida e a geração prossegue a partir do resultado apropriado. Verificar vários candidatos numa execução permite procurar mais paralelismo do que na geração token a token.
A proposta do modelo auxiliar não tem de coincidir sempre com aquilo que o modelo-alvo teria gerado. A chave do procedimento de amostragem é que a aceitação e a correção dos candidatos são concebidas para que o resultado final tenha a distribuição do modelo-alvo, nas condições do método. Por isso, não se deve descrever o método como uma substituição aproximada do modelo-alvo: é o modelo-alvo que continua a determinar a distribuição de saída.
A quantidade de tokens aceites é uma parte do cálculo, não uma medida completa da velocidade. Uma taxa de aceitação elevada pode vir acompanhada de uma verificação dispendiosa; uma taxa mais baixa pode ser competitiva se o modelo auxiliar for barato e o runtime executar o trabalho adicional de forma eficiente. O comprimento da sequência especulativa também implica um compromisso: propor mais candidatos pode aumentar o trabalho do modelo auxiliar e da verificação.
Ciclo simplificado de proposta e verificação
- 01O mecanismo auxiliar propõe um ou mais tokens candidatos.
- 02O modelo-alvo avalia os candidatos e calcula as distribuições necessárias para os verificar.
- 03O procedimento aceita os candidatos compatíveis com a amostragem especulativa e corrige o ponto de rejeição, quando aplicável.
- 04A geração prossegue a partir da sequência validada; a poupança depende do custo total deste ciclo em comparação com o método de referência.
Preservar a distribuição não garante uma melhoria
O trabalho de Leviathan e coautores apresenta a decodificação especulativa como uma forma de acelerar a inferência sem alterar a distribuição dos resultados do modelo-alvo. Esta garantia depende do procedimento de amostragem e das condições matemáticas do método; não significa que cada resposta produzida seja idêntica a uma resposta específica obtida com a decodificação convencional. Refere-se à distribuição das saídas, não a uma correspondência obrigatória entre cada trajetória aleatória.
A garantia também não afirma que todas as configurações sejam mais rápidas. Por si só, não determina o custo do modelo auxiliar, a eficiência das operações no acelerador, o comportamento do escalonador perante pedidos concorrentes nem a memória disponível. Esses fatores pertencem à execução. Na prática, a correção da amostragem e a utilidade operacional têm de ser avaliadas separadamente.
Esta distinção evita uma interpretação frequente, mas incorreta: o facto de uma técnica preservar a distribuição-alvo não significa que «acelere o modelo» universalmente. A afirmação correta é mais limitada: o método pode preservar a distribuição e proporcionar uma melhoria quando a proposta, a verificação e a implementação são favoráveis nas condições avaliadas.
De EAGLE a EAGLE-3: muda a proposta, não o critério de avaliação
EAGLE reformula a previsão especulativa recorrendo a informação de características internas, em vez de tratar o modelo auxiliar apenas como uma fonte independente de tokens. O trabalho apresenta uma proposta centrada na incerteza dessas características. Esta diferença de conceção importa porque o mecanismo de proposta influencia os candidatos que chegam à verificação e o custo necessário para os gerar.
EAGLE-3 é uma variante posterior cujo trabalho se centra em escalar a aceleração através de uma abordagem de treino denominada «training-time test» no título do artigo. Não convém apresentar os seus valores como se fossem diretamente comparáveis aos de qualquer implementação de EAGLE ou do esquema básico. Para fazer uma comparação válida, é preciso identificar o modelo, o runtime, o hardware, a configuração de geração e a carga de trabalho de cada experiência.
Em particular, um resultado comunicado para SGLang não deve ser transposto automaticamente para vLLM, nem um resultado obtido com determinado tamanho de lote deve ser entendido como uma previsão para outro padrão de tráfego. As diferenças entre métodos são relevantes, mas a infraestrutura e o protocolo de avaliação também fazem parte do resultado.
O que deve ser mantido separado ao comparar variantes
| Aspeto | Pergunta a fazer | Por que importa |
|---|---|---|
| Método | É usada a decodificação especulativa básica, EAGLE, EAGLE-3 ou outra variante? | As estratégias de proposta e os respetivos custos não são necessariamente iguais. |
| Runtime | A medição corresponde a vLLM, SGLang ou outro ambiente? | O escalonamento e a implementação podem alterar o trabalho efetivamente realizado. |
| Carga de trabalho | Que tamanhos de lote, níveis de concorrência e padrões de pedidos foram avaliados? | Uma melhoria numa carga de trabalho não demonstra uma melhoria noutra. |
| Métrica | São comunicados latência, throughput, aceitação ou outro indicador? | Cada métrica responde a uma pergunta diferente. |
O que o estudo de 2026 acrescenta — e o que não permite concluir
O preprint «Speculative Decoding: Performance or Illusion?» apresenta um estudo sistemático de variantes de decodificação especulativa em vLLM, com diferentes modelos, cargas de trabalho e tamanhos de lote. Entre as conclusões destacadas na descrição do trabalho estão a possibilidade de a verificação pelo modelo-alvo dominar uma parte significativa da execução e a variação da aceitação de tokens conforme a posição, o pedido e o conjunto de dados. São observações que põem em causa o uso de uma única taxa média de aceitação como indicador suficiente.
A interpretação útil não é que a técnica nunca acelere, mas sim que o resultado depende de onde o tempo é gasto. Se a verificação dos candidatos consumir uma parte substancial do cálculo, a vantagem de aceitar vários tokens pode diminuir. E, se a aceitação variar entre posições ou pedidos, uma média agregada pode ocultar casos em que o trabalho adicional do modelo auxiliar não é compensado.
A informação verificada disponível para este artigo não permite enumerar com precisão todas as variantes, modelos, cargas de trabalho, tamanhos de lote, métricas primárias ou configurações exatas do preprint. Também não é suficiente para reproduzir os valores de cada experiência. Por isso, não são atribuídos aqui valores numéricos nem se afirma que uma determinada variante vence em todos os cenários. Para uma análise quantitativa, estes pormenores devem ser confirmados no texto integral e na configuração de cada experiência.
O preprint e o trabalho fundador respondem a perguntas diferentes. O primeiro estuda o comportamento de implementações e cargas de trabalho num runtime; o segundo fundamenta a possibilidade de preservar a distribuição através do procedimento de amostragem. Usar o resultado matemático do trabalho fundador como prova do desempenho de uma configuração de vLLM seria misturar níveis de evidência.
Por que a aceitação não basta para explicar a velocidade
Uma taxa ou um comprimento de aceitação descreve quanto da proposta sobrevive à verificação, mas não inclui outros custos: executar o modelo auxiliar, preparar os estados necessários, verificar candidatos e coordenar as operações no runtime. Também não indica, por si só, quanto demora um pedido completo nem quantos pedidos o sistema consegue processar por unidade de tempo.
A concorrência torna esta distinção ainda mais importante. Um serviço partilhado processa pedidos que competem por recursos e podem ter comprimentos diferentes. À medida que o tamanho do lote ou a concorrência aumenta, o trabalho útil por execução pode mudar, tal como a pressão sobre a memória e o escalonamento. Uma melhoria de latência medida com um lote pequeno não prova que a latência de fila diminua num serviço concorrente, nem que a capacidade do serviço aumente.
Convém distinguir pelo menos três resultados. A latência total responde à pergunta sobre quanto espera um pedido até estar concluído; a latência por token descreve o ritmo de geração segundo uma definição de medição que deve ser explicitada; o throughput mede a quantidade de trabalho concluído por unidade de tempo. Não são medidas intercambiáveis, e uma otimização pode favorecer uma sem melhorar as restantes na mesma proporção.
Como avaliar uma alegação de aceleração
A comparação deve começar por uma referência clara: a decodificação autorregressiva que seria usada com o mesmo modelo e no mesmo ambiente. Se o runtime, o hardware ou a configuração mudarem ao mesmo tempo, não é possível atribuir com segurança a diferença à técnica especulativa. Também é preciso especificar as condições de geração, porque influenciam as distribuições verificadas e o padrão de trabalho.
Em seguida, a equipa deve escolher métricas alinhadas com o objetivo. Numa interação individual, pode importar a latência percebida; num serviço com procura variável, a distribuição das latências e a capacidade sob concorrência; para a capacidade total, o throughput. A aceitação de tokens e o custo da verificação ajudam a explicar o resultado, mas não substituem as métricas do serviço.
A documentação oficial do vLLM alerta que os resultados dependem do modelo, do tráfego, do hardware e da configuração, e recomenda medições no ambiente previsto. Esse conselho não elimina a necessidade de publicar o protocolo: permite saber a que contexto se aplica o resultado e se uma reprodução é razoável.
Protocolo prático de avaliação
- 01Fixar o modelo-alvo, o método de referência, o runtime, o hardware e a configuração de geração.
- 02Definir uma carga de trabalho representativa, incluindo os tamanhos de lote e os níveis de concorrência a avaliar.
- 03Medir a latência e o throughput adequados ao objetivo do serviço; registar também a aceitação e o custo de verificação para explicar o resultado.
- 04Repetir as medições nas mesmas condições e documentar as diferenças entre tamanhos de lote e padrões de tráfego.
- 05Comunicar separadamente os resultados de cada variante e ambiente, sem os combinar numa classificação única quando tiverem sido obtidos com protocolos diferentes.
Conclusão: a evidência válida diz respeito ao sistema completo
A decodificação especulativa oferece uma estratégia para reduzir o custo sequencial da geração de tokens: propor vários candidatos e verificá-los com o modelo-alvo. O procedimento de amostragem pode preservar a distribuição de saída do modelo-alvo, mas essa propriedade não promete, por si só, menor latência, maior throughput ou menor custo operacional.
O trabalho fundador, as variantes como EAGLE e EAGLE-3 e o estudo de 2026 fornecem tipos diferentes de evidência. A teoria da amostragem explica uma garantia; os trabalhos sobre variantes descrevem outros mecanismos e as respetivas avaliações; o estudo em vLLM analisa como métodos, cargas de trabalho e tamanhos de lote interagem num runtime. Os resultados não devem ser fundidos como se tivessem sido obtidos num único teste controlado.
Para tomar uma decisão de produção, a questão central é saber se a combinação específica de modelo, mecanismo de proposta, runtime, acelerador e padrão de pedidos melhora as métricas relevantes para o serviço. A evidência mínima é uma comparação reproduzível com uma referência equivalente e sob a concorrência prevista. Até existir essa evidência, a aceleração observada num teste limitado é uma hipótese a validar, não uma garantia de capacidade.
Guia de decisão para equipas de inferência
| Se a pergunta for… | A evidência necessária |
|---|---|
| A distribuição-alvo é preservada? | O procedimento de amostragem e as condições em que é correto. |
| A latência de um pedido diminui? | Uma medição de latência com referência e configuração equivalentes. |
| A capacidade do serviço melhora? | Throughput medido com a concorrência e o padrão de tráfego previstos. |
| É possível generalizar o resultado? | Testes nos modelos, runtime, hardware e cargas de trabalho em que se pretende usar a técnica. |
Questões em aberto
- A informação verificada disponível para esta redação não discrimina todas as variantes, modelos, cargas de trabalho, tamanhos de lote ou métricas primárias avaliados no preprint de 2026.
- Não são apresentados aqui valores experimentais nem pormenores suficientes para reconstruir de forma independente cada comparação do estudo de 2026.
- A dimensão da aceleração e a forma como evolui com a concorrência dependem da configuração concreta; não é possível inferir uma tendência quantitativa universal a partir das fontes resumidas.
- As avaliações de EAGLE e EAGLE-3 foram realizadas em condições que não devem ser consideradas equivalentes entre si nem às do estudo em vLLM.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção