Generar token a token: el coste que intenta reducir la técnica
En la generación autorregresiva habitual, el modelo produce un token y después vuelve a ejecutarse para producir el siguiente, condicionado por los tokens anteriores. La secuencia de pasos limita cuánto cálculo se puede paralelizar a lo largo de una misma respuesta: el token siguiente depende del estado que dejó el anterior. Esto no significa que todas las operaciones de una ejecución sean estrictamente secuenciales, pero sí que la generación impone una cadena de dependencias entre tokens.
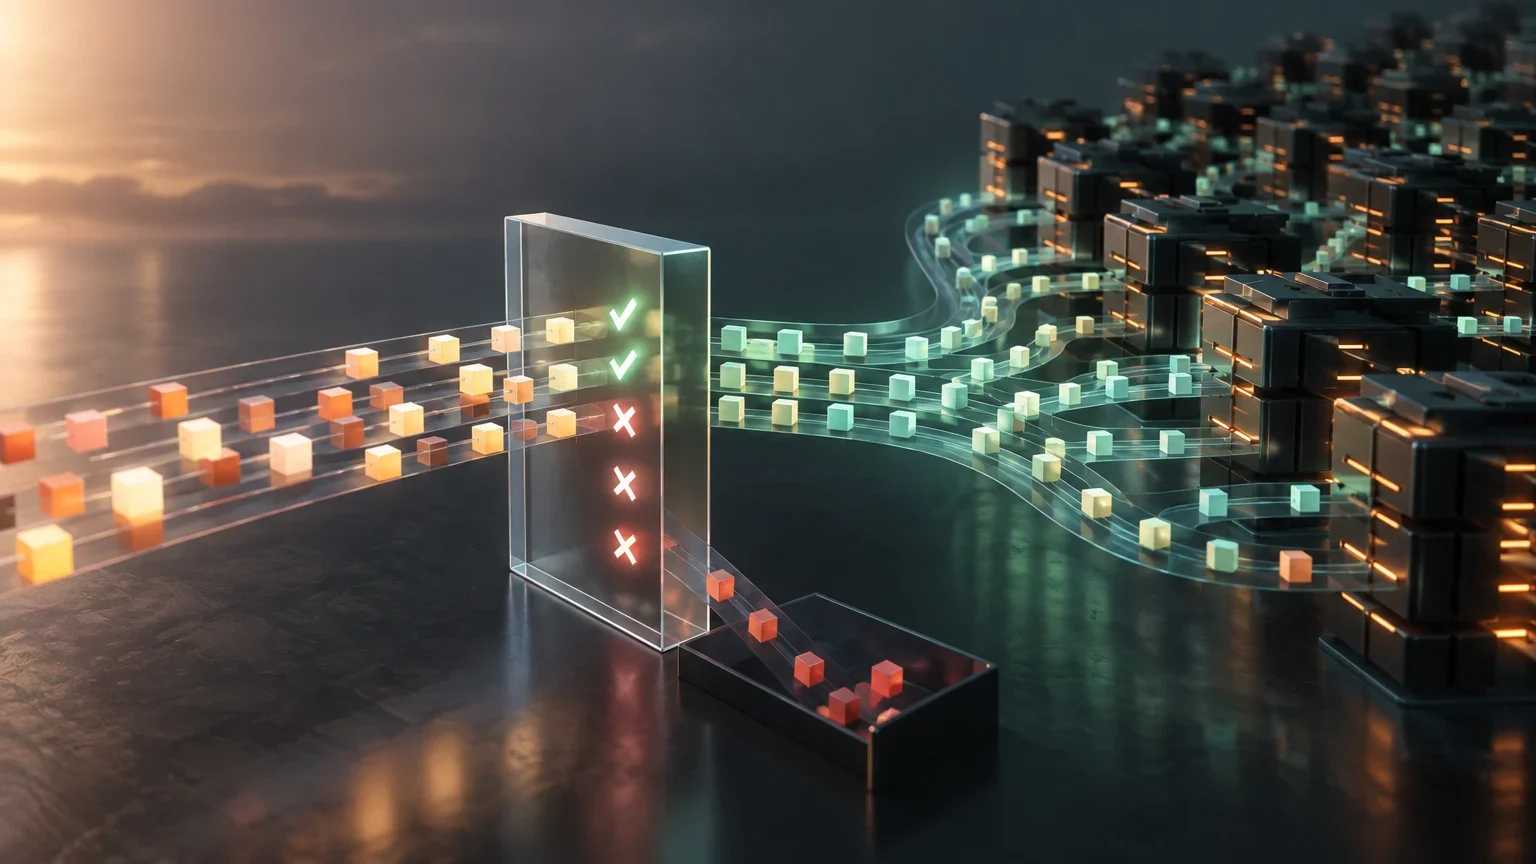
La decodificación especulativa intenta aprovechar una asimetría: puede ser más barato proponer varios tokens con un modelo o mecanismo auxiliar y comprobarlos en conjunto con el modelo objetivo, que generar cada token de salida mediante una nueva pasada de este último. La idea no elimina el trabajo del modelo objetivo. Lo reorganiza para que, cuando los candidatos sean útiles y la verificación resulte eficiente, una ejecución pueda validar más de un token.
La pregunta de rendimiento no es, por tanto, solo cuántos tokens propone el borrador o cuántos acepta el objetivo. También importa cuánto cuesta preparar los candidatos, cuánto trabajo requiere verificarlos y cómo programa esas operaciones el runtime. Una técnica puede reducir pasos secuenciales y, al mismo tiempo, añadir cálculos que anulen el ahorro.
Cómo funciona draft-and-verify
En el esquema básico, un borrador propone una secuencia de candidatos. El modelo objetivo calcula las distribuciones que corresponden a las posiciones de esa secuencia y el procedimiento de verificación decide qué candidatos pueden conservarse. Si un candidato no pasa la comprobación, se corrige el paso y la generación continúa desde el resultado apropiado. La verificación de varios candidatos en una ejecución permite buscar más paralelismo que en la generación token a token.
La propuesta de borrador no tiene que coincidir siempre con lo que habría generado el objetivo. La clave del procedimiento de muestreo es que la aceptación y la corrección de los candidatos se diseñan para que el resultado final tenga la distribución del modelo objetivo, bajo las condiciones del método. Por eso no debe describirse como una sustitución aproximada del modelo objetivo: el objetivo sigue determinando la distribución de salida.
La cantidad de tokens aceptados es una parte del cálculo, no una medida completa de velocidad. Una aceptación alta puede acompañarse de una verificación costosa; una aceptación menor puede resultar competitiva si el borrador es barato y el runtime ejecuta con eficiencia el trabajo adicional. El tamaño de la secuencia especulativa también supone un compromiso: proponer más candidatos puede aumentar el trabajo de borrador y verificación.
Ciclo simplificado de propuesta y verificación
- 01El mecanismo de borrador propone uno o más tokens candidatos.
- 02El modelo objetivo evalúa los candidatos y calcula las distribuciones necesarias para verificarlos.
- 03El procedimiento acepta los candidatos compatibles con el muestreo especulativo y corrige el punto de rechazo cuando corresponde.
- 04La generación continúa a partir de la secuencia validada; el ahorro depende del coste total de este ciclo frente al método de referencia.
Preservar la distribución no es garantizar una mejora
El trabajo de Leviathan y sus coautores presenta la decodificación especulativa como una forma de acelerar la inferencia sin cambiar la distribución de los resultados del modelo objetivo. Esta garantía depende del procedimiento de muestreo y de las condiciones matemáticas del método; no es una afirmación de que cada respuesta producida sea idéntica a una respuesta concreta de la decodificación ordinaria. Se refiere a la distribución de las salidas, no a una coincidencia obligatoria de cada trayectoria aleatoria.
La garantía tampoco dice que toda configuración sea más rápida. No fija por sí misma el coste del borrador, la eficiencia de las operaciones en el acelerador, el comportamiento del planificador ante solicitudes concurrentes ni el volumen de memoria disponible. Esos factores pertenecen a la ejecución. En términos prácticos, la corrección del muestreo y la utilidad operativa deben probarse por separado.
Esta distinción evita una lectura frecuente pero incorrecta: que una técnica conserve la distribución objetivo no significa que «acelere el modelo» de forma universal. La afirmación correcta es más acotada: el método puede preservar la distribución y ofrecer una mejora cuando la propuesta, la verificación y la implementación son favorables en las condiciones medidas.
De EAGLE a EAGLE-3: cambia la propuesta, no el criterio de evaluación
EAGLE replantea la predicción especulativa mediante información de características internas, en vez de limitarse a tratar el borrador como una fuente independiente de tokens. El trabajo presenta una propuesta centrada en la incertidumbre de esas características. Esta diferencia de diseño importa porque el mecanismo de propuesta influye en qué candidatos llegan a la verificación y en qué coste se incurre para generarlos.
EAGLE-3 es una variante posterior cuyo trabajo se centra en escalar la aceleración mediante un enfoque de entrenamiento denominado en el título del artículo «training-time test». No conviene presentar sus cifras como si fueran directamente comparables con las de cualquier implementación de EAGLE o del esquema básico. Para hacer una comparación válida hay que identificar el modelo, el runtime, el hardware, la configuración de generación y la carga de cada experimento.
En particular, un resultado comunicado para SGLang no debe trasladarse sin más a vLLM, ni un resultado con un lote determinado debe leerse como una predicción para otro patrón de tráfico. Las diferencias de método son relevantes, pero la infraestructura y el protocolo de evaluación también forman parte del resultado.
Qué debe mantenerse separado al comparar variantes
| Aspecto | Pregunta de lectura | Por qué importa |
|---|---|---|
| Método | ¿Se usa decodificación especulativa básica, EAGLE, EAGLE-3 u otra variante? | Las estrategias de propuesta y su coste no son necesariamente iguales. |
| Runtime | ¿La medición corresponde a vLLM, SGLang u otro entorno? | La planificación y la implementación pueden alterar el trabajo efectivo. |
| Carga | ¿Qué tamaños de lote, concurrencia y patrón de solicitudes se midieron? | Una mejora en una carga no demuestra una mejora en otra. |
| Métrica | ¿Se informa latencia, throughput, aceptación u otra medida? | Cada métrica responde a una pregunta diferente. |
Qué aporta el estudio de 2026 y qué no permite concluir
El preprint «Speculative Decoding: Performance or Illusion?» plantea un estudio sistemático de variantes de decodificación especulativa en vLLM bajo distintos modelos, cargas y tamaños de lote. Entre los hallazgos destacados en la descripción del trabajo figuran que la verificación del modelo objetivo puede dominar una parte importante de la ejecución y que la aceptación de tokens varía según la posición, la solicitud y el conjunto de datos. Son observaciones que ponen en cuestión el uso de una única tasa media de aceptación como indicador suficiente.
La lectura útil no es que la técnica nunca acelere, sino que el resultado depende de dónde se gasta el tiempo. Si verificar los candidatos absorbe una parte grande del cómputo, la ventaja de aceptar varios tokens puede reducirse. Y si la aceptación cambia entre posiciones o solicitudes, una media agregada puede ocultar casos donde el trabajo extra del borrador no se recupera.
La información verificada disponible para esta pieza no permite enumerar con precisión todas las variantes, modelos, cargas, tamaños de lote, métricas primarias ni configuraciones exactas del preprint. Tampoco basta para reproducir los valores de cada experimento. Por eso no se atribuyen aquí cifras ni se afirma que una variante concreta gane en todos los escenarios. Para una lectura cuantitativa, esos detalles deben comprobarse en el texto completo y en la configuración de cada experimento.
El preprint y el trabajo fundacional contestan preguntas distintas. El primero estudia el comportamiento de implementaciones y cargas en un runtime; el segundo sustenta la posibilidad de preservar la distribución mediante el procedimiento de muestreo. Usar el resultado matemático del trabajo fundacional como prueba de rendimiento de una configuración de vLLM sería mezclar niveles de evidencia.
Por qué la aceptación no basta para explicar la velocidad
Una tasa o longitud de aceptación describe cuánto de la propuesta sobrevive a la verificación, pero deja fuera otros costes: ejecutar el borrador, preparar los estados necesarios, verificar candidatos y coordinar las operaciones dentro del runtime. Tampoco indica, por sí sola, cuánto tarda una solicitud completa ni cuántas solicitudes puede atender el sistema por unidad de tiempo.
La concurrencia hace más importante esa distinción. Un servicio compartido procesa solicitudes que compiten por recursos y pueden tener longitudes distintas. Al aumentar el lote o la concurrencia, el trabajo útil por ejecución puede cambiar, al igual que la presión sobre memoria y planificación. Una mejora de latencia medida con un lote pequeño no prueba que se reduzca la latencia de cola en un servicio concurrido, ni que aumente su capacidad.
Conviene separar al menos tres resultados. La latencia total responde cuánto espera una solicitud hasta terminar; la latencia por token describe el ritmo de generación bajo una definición de medición que debe explicitarse; el throughput mide la cantidad de trabajo completado por unidad de tiempo. No son intercambiables, y una optimización puede favorecer una medida sin mejorar las demás en la misma proporción.
Cómo evaluar una afirmación de aceleración
La comparación debe partir de una referencia clara: la decodificación autorregresiva que usaría el mismo modelo en el mismo entorno. Si cambian a la vez el runtime, el hardware o la configuración, no es posible atribuir con seguridad la diferencia a la técnica especulativa. También hay que precisar las condiciones de generación, porque influyen en las distribuciones que se verifican y en el patrón de trabajo.
Después, el equipo debe elegir métricas alineadas con el objetivo. Para una interacción individual puede importar la latencia percibida; para un servicio con demanda variable, la distribución de latencias y la capacidad bajo concurrencia; para capacidad total, el throughput. Aceptación de tokens y coste de verificación ayudan a explicar el resultado, pero no sustituyen a las métricas de servicio.
La documentación oficial de vLLM advierte que el resultado depende del modelo, el tráfico, el hardware y la configuración, y recomienda medir en el entorno previsto. Ese consejo no elimina la necesidad de publicar el protocolo: permite saber a qué contexto se aplica el resultado y si una reproducción es razonable.
Protocolo práctico de evaluación
- 01Fijar el modelo objetivo, el método de referencia, el runtime, el hardware y la configuración de generación.
- 02Definir una carga representativa, incluyendo el tamaño de lote y los niveles de concurrencia que se quieren evaluar.
- 03Medir la latencia y el throughput que correspondan al objetivo del servicio; registrar también aceptación y coste de verificación para explicar el resultado.
- 04Repetir las mediciones bajo las mismas condiciones y documentar las diferencias entre lotes y patrones de tráfico.
- 05Informar por separado los resultados de cada variante y entorno, sin combinar como una clasificación única cifras obtenidas con protocolos distintos.
Conclusión: la evidencia válida es la del sistema completo
La decodificación especulativa ofrece una estrategia para reducir el coste secuencial de generar tokens: proponer varios candidatos y verificarlos con el modelo objetivo. El procedimiento de muestreo puede preservar la distribución de salida del objetivo, pero esa propiedad no promete por sí misma menos latencia, más throughput ni menor coste operativo.
El trabajo fundacional, las variantes como EAGLE y EAGLE-3 y el estudio de 2026 aportan tipos de evidencia diferentes. La teoría del muestreo explica una garantía; los trabajos de variantes describen otros mecanismos y sus evaluaciones; el estudio en vLLM examina cómo interactúan métodos, cargas y tamaños de lote en un runtime. Sus resultados no deben fusionarse como si provinieran de una única prueba controlada.
Para una decisión de producción, la pregunta central es si la combinación concreta de modelo, propuesta, runtime, acelerador y patrón de solicitudes mejora las métricas que importan al servicio. La evidencia mínima es una comparación reproducible frente a una referencia equivalente y bajo la concurrencia prevista. Hasta contar con ella, la aceleración observada en una prueba limitada es una hipótesis para validar, no una garantía de capacidad.
Guía de decisión para equipos de inferencia
| Si la pregunta es… | La evidencia que hace falta |
|---|---|
| ¿Se conserva la distribución objetivo? | El procedimiento de muestreo y sus condiciones de corrección. |
| ¿Baja la latencia de una solicitud? | Una medición de latencia con referencia y configuración equivalentes. |
| ¿Mejora la capacidad del servicio? | Throughput medido bajo la concurrencia y el patrón de tráfico previstos. |
| ¿Se puede generalizar el resultado? | Pruebas en los modelos, runtime, hardware y cargas para los que se pretende usar la técnica. |
Qué sigue abierto
- La información verificada disponible para esta redacción no desglosa todas las variantes, modelos, cargas, tamaños de lote ni métricas primarias evaluados en el preprint de 2026.
- No se proporcionan aquí cifras experimentales ni detalles suficientes para reconstruir de forma independiente cada comparación del estudio de 2026.
- La magnitud de la aceleración y su evolución con la concurrencia dependen de la configuración concreta; no se puede inferir una tendencia cuantitativa universal a partir de las fuentes resumidas.
- Las evaluaciones de EAGLE y EAGLE-3 se realizaron bajo condiciones que no deben suponerse equivalentes entre sí ni con las del estudio en vLLM.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección