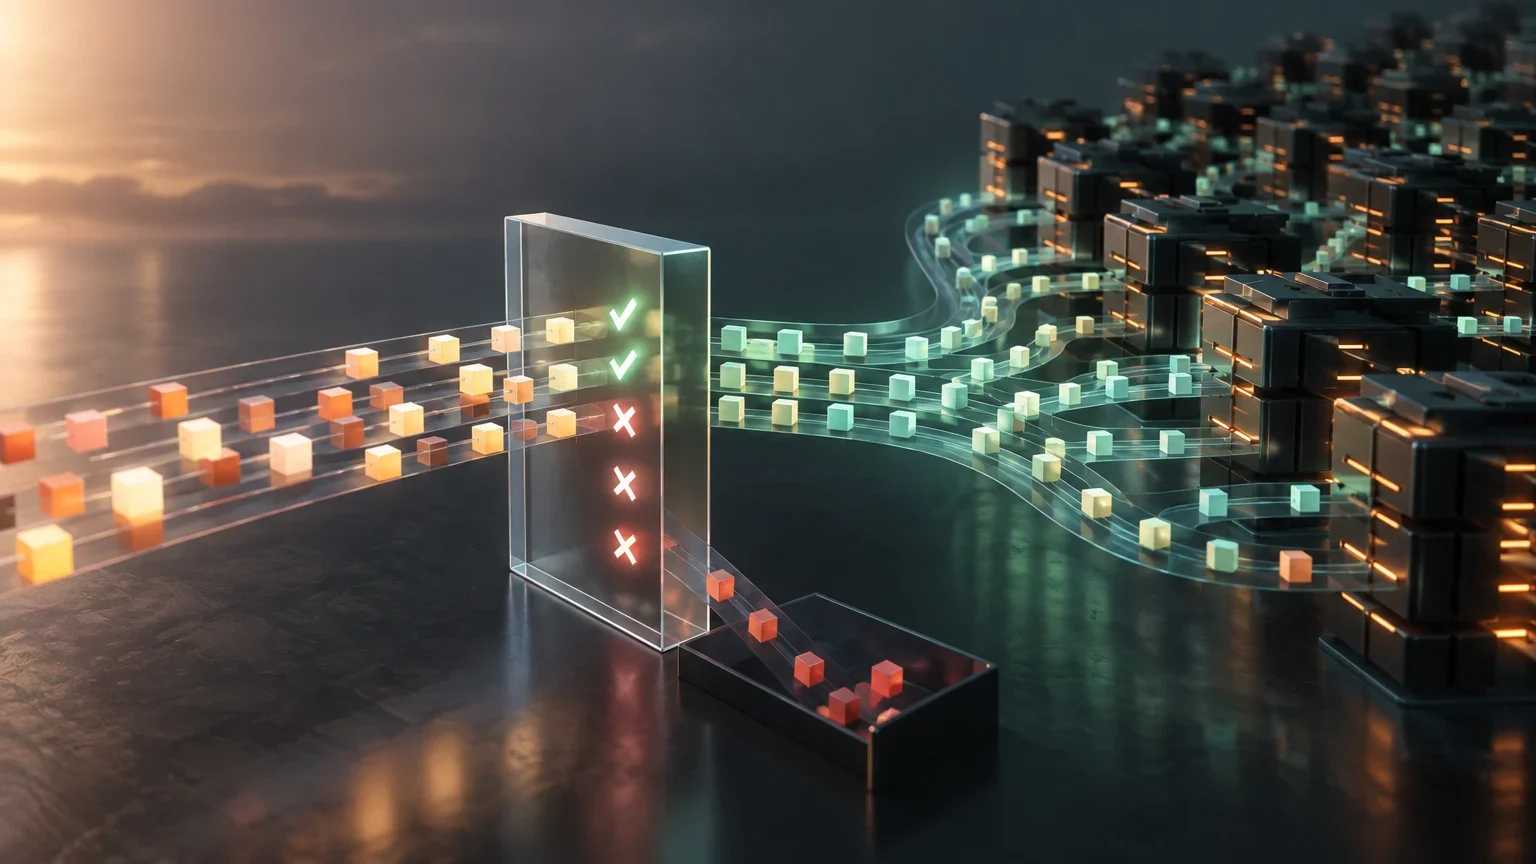
Generare un token alla volta: il costo che la tecnica cerca di ridurre
Nella consueta generazione autoregressiva, il modello produce un token e poi viene eseguito di nuovo per produrre il successivo, condizionato dai token precedenti. La sequenza di passaggi limita la quantità di calcolo parallelizzabile all’interno di una stessa risposta: il token successivo dipende dallo stato lasciato dal precedente. Ciò non significa che tutte le operazioni di un’esecuzione siano strettamente sequenziali, ma la generazione impone una catena di dipendenze tra token.
La decodifica speculativa cerca di sfruttare un’asimmetria: può costare meno proporre diversi token con un modello o un meccanismo ausiliario e verificarli insieme con il modello target, anziché generare ogni token di output con una nuova passata di quest’ultimo. L’idea non elimina il lavoro del modello target. Lo riorganizza, così che, quando i candidati sono utili e la verifica è efficiente, una singola esecuzione possa convalidare più di un token.
La questione delle prestazioni, quindi, non riguarda soltanto quanti token propone il modello bozza o quanti ne accetta il target. Contano anche il costo di preparazione dei candidati, il lavoro necessario per verificarli e il modo in cui il runtime pianifica queste operazioni. Una tecnica può ridurre i passaggi sequenziali e, al tempo stesso, aggiungere calcoli che annullano il risparmio.
Come funziona il meccanismo draft-and-verify
Nello schema di base, un modello bozza propone una sequenza di candidati. Il modello target calcola le distribuzioni associate alle posizioni della sequenza e la procedura di verifica stabilisce quali candidati possono essere mantenuti. Se un candidato non supera il controllo, il passaggio viene corretto e la generazione prosegue dal risultato appropriato. Verificare più candidati in una singola esecuzione permette di cercare un parallelismo maggiore rispetto alla generazione token per token.
La proposta del modello bozza non deve necessariamente coincidere con ciò che avrebbe generato il target. Il punto fondamentale della procedura di campionamento è che l’accettazione e la correzione dei candidati vengono progettate in modo che il risultato finale segua la distribuzione del modello target, alle condizioni previste dal metodo. Per questo non va descritta come una sostituzione approssimativa del modello target: è il target a continuare a determinare la distribuzione di output.
La quantità di token accettati è una parte del calcolo, non una misura completa della velocità. Un tasso di accettazione elevato può accompagnarsi a una verifica costosa; un tasso più basso può risultare competitivo se il modello bozza è economico e il runtime esegue con efficienza il lavoro aggiuntivo. Anche la lunghezza della sequenza speculativa comporta un compromesso: proporre più candidati può aumentare il lavoro del modello bozza e quello di verifica.
Ciclo semplificato di proposta e verifica
- 01Il meccanismo bozza propone uno o più token candidati.
- 02Il modello target valuta i candidati e calcola le distribuzioni necessarie per verificarli.
- 03La procedura accetta i candidati compatibili con il campionamento speculativo e corregge il punto di rifiuto, quando necessario.
- 04La generazione riprende dalla sequenza convalidata; il risparmio dipende dal costo complessivo di questo ciclo rispetto al metodo di riferimento.
Preservare la distribuzione non significa garantire un miglioramento
Il lavoro di Leviathan e dei suoi coautori presenta la decodifica speculativa come un modo per accelerare l’inferenza senza modificare la distribuzione dei risultati del modello target. Questa garanzia dipende dalla procedura di campionamento e dalle condizioni matematiche del metodo; non afferma che ogni risposta generata sia identica a una specifica risposta prodotta dalla decodifica ordinaria. Riguarda la distribuzione degli output, non la coincidenza obbligatoria di ogni traiettoria casuale.
La garanzia, inoltre, non afferma che ogni configurazione sia più veloce. Non determina di per sé il costo del modello bozza, l’efficienza delle operazioni sull’acceleratore, il comportamento dello scheduler in presenza di richieste concorrenti o la quantità di memoria disponibile. Questi fattori riguardano l’esecuzione. In pratica, la correttezza del campionamento e l’utilità operativa vanno verificate separatamente.
Questa distinzione evita un’interpretazione frequente ma errata: il fatto che una tecnica preservi la distribuzione target non significa che «acceleri il modello» in modo universale. L’affermazione corretta è più circoscritta: il metodo può preservare la distribuzione e offrire un miglioramento quando proposta, verifica e implementazione sono favorevoli nelle condizioni misurate.
Da EAGLE a EAGLE-3: cambia la proposta, non il criterio di valutazione
EAGLE riformula la predizione speculativa usando informazioni sulle caratteristiche interne, invece di trattare il modello bozza soltanto come una fonte indipendente di token. Il lavoro propone un approccio incentrato sull’incertezza di queste caratteristiche. La differenza di progettazione è importante perché il meccanismo di proposta influisce sia sui candidati sottoposti a verifica sia sul costo necessario per generarli.
EAGLE-3 è una variante successiva, il cui lavoro si concentra sull’estensione dell’accelerazione attraverso un approccio di training chiamato, nel titolo dell’articolo, «training-time test». È meglio non presentare i suoi numeri come se fossero direttamente confrontabili con quelli di qualsiasi implementazione di EAGLE o dello schema di base. Per un confronto valido occorre identificare il modello, il runtime, l’hardware, la configurazione di generazione e il carico di ogni esperimento.
In particolare, un risultato riportato per SGLang non va trasferito senza riserve a vLLM, né un risultato ottenuto con una determinata dimensione del batch va interpretato come previsione per un altro schema di traffico. Le differenze tra i metodi sono rilevanti, ma anche l’infrastruttura e il protocollo di valutazione fanno parte del risultato.
Che cosa tenere distinto nel confronto tra varianti
| Aspetto | Domanda da porsi | Perché è importante |
|---|---|---|
| Metodo | Si usa la decodifica speculativa di base, EAGLE, EAGLE-3 o un’altra variante? | Le strategie di proposta e i relativi costi non sono necessariamente uguali. |
| Runtime | La misurazione riguarda vLLM, SGLang o un altro ambiente? | La pianificazione e l’implementazione possono modificare il lavoro effettivo. |
| Carico | Quali dimensioni del batch, livelli di concorrenza e schemi di richiesta sono stati misurati? | Un miglioramento su un carico non dimostra un miglioramento su un altro. |
| Metrica | Sono riportati latenza, throughput, accettazione o un’altra misura? | Ogni metrica risponde a una domanda diversa. |
Che cosa mostra lo studio del 2026 e che cosa non consente di concludere
Il preprint «Speculative Decoding: Performance or Illusion?» propone uno studio sistematico di varianti della decodifica speculativa in vLLM, con modelli, carichi e dimensioni del batch diversi. Tra i risultati evidenziati nella descrizione del lavoro figurano il possibile peso della verifica del modello target nell’esecuzione e la variabilità dell’accettazione dei token a seconda della posizione, della richiesta e del dataset. Sono osservazioni che mettono in discussione l’uso di un unico tasso medio di accettazione come indicatore sufficiente.
La conclusione utile non è che la tecnica non acceleri mai, ma che il risultato dipende da dove viene impiegato il tempo. Se la verifica dei candidati assorbe una parte consistente del calcolo, il vantaggio di accettare più token può ridursi. E se l’accettazione varia tra posizioni o richieste, una media aggregata può nascondere i casi in cui il lavoro aggiuntivo del modello bozza non viene compensato.
Le informazioni verificate disponibili per questo articolo non consentono di elencare con precisione tutte le varianti, i modelli, i carichi, le dimensioni del batch, le metriche primarie o le configurazioni esatte del preprint. Non sono sufficienti neppure per riprodurre i valori di ogni esperimento. Per questo non vengono attribuiti numeri né si afferma che una specifica variante prevalga in tutti gli scenari. Per un’analisi quantitativa, questi dettagli vanno verificati nel testo completo e nella configurazione di ciascun esperimento.
Il preprint e il lavoro fondativo rispondono a domande diverse. Il primo studia il comportamento delle implementazioni e dei carichi all’interno di un runtime; il secondo sostiene la possibilità di preservare la distribuzione tramite la procedura di campionamento. Usare il risultato matematico del lavoro fondativo come prova delle prestazioni di una configurazione vLLM significherebbe confondere livelli diversi di evidenza.
Perché l’accettazione non basta a spiegare la velocità
Un tasso o una lunghezza di accettazione descrivono quanta parte della proposta supera la verifica, ma non includono altri costi: l’esecuzione del modello bozza, la preparazione degli stati necessari, la verifica dei candidati e il coordinamento delle operazioni all’interno del runtime. Da soli, inoltre, non indicano quanto dura una richiesta completa né quante richieste il sistema può servire nell’unità di tempo.
La concorrenza rende questa distinzione ancora più importante. Un servizio condiviso gestisce richieste che competono per le risorse e possono avere lunghezze diverse. Quando aumentano batch o concorrenza, può cambiare il lavoro utile per esecuzione, così come la pressione sulla memoria e sulla pianificazione. Un miglioramento della latenza misurato con un batch piccolo non dimostra che la latenza in coda diminuisca in un servizio concorrente, né che la sua capacità aumenti.
È utile distinguere almeno tre risultati. La latenza totale indica quanto attende una richiesta prima di terminare; la latenza per token descrive il ritmo di generazione secondo una definizione di misurazione che va esplicitata; il throughput misura la quantità di lavoro completata per unità di tempo. Non sono metriche intercambiabili e un’ottimizzazione può favorirne una senza migliorare le altre nella stessa proporzione.
Come valutare un’affermazione di accelerazione
Il confronto deve partire da un riferimento chiaro: la decodifica autoregressiva che userebbe lo stesso modello nello stesso ambiente. Se cambiano contemporaneamente runtime, hardware o configurazione, non è possibile attribuire con sicurezza la differenza alla tecnica speculativa. Occorre anche specificare le condizioni di generazione, perché influiscono sulle distribuzioni da verificare e sullo schema di lavoro.
In seguito, il team deve scegliere metriche coerenti con l’obiettivo. Per un’interazione singola può contare la latenza percepita; per un servizio con domanda variabile, la distribuzione delle latenze e la capacità sotto concorrenza; per la capacità complessiva, il throughput. L’accettazione dei token e il costo della verifica aiutano a spiegare il risultato, ma non sostituiscono le metriche del servizio.
La documentazione ufficiale di vLLM avverte che i risultati dipendono da modello, traffico, hardware e configurazione, e raccomanda misurazioni nell’ambiente previsto. Questo consiglio non elimina la necessità di pubblicare il protocollo: permette di capire a quale contesto si applica il risultato e se sia ragionevole riprodurlo.
Protocollo pratico di valutazione
- 01Definire il modello target, il metodo di riferimento, il runtime, l’hardware e la configurazione di generazione.
- 02Stabilire un carico rappresentativo, includendo la dimensione del batch e i livelli di concorrenza da valutare.
- 03Misurare la latenza e il throughput pertinenti all’obiettivo del servizio; registrare anche accettazione e costo della verifica per spiegare il risultato.
- 04Ripetere le misurazioni nelle stesse condizioni e documentare le differenze tra batch e schemi di traffico.
- 05Riportare separatamente i risultati di ciascuna variante e ambiente, senza riunire in un’unica classifica numeri ottenuti con protocolli diversi.
Conclusione: l’evidenza valida riguarda il sistema completo
La decodifica speculativa offre una strategia per ridurre il costo sequenziale della generazione di token: proporre diversi candidati e verificarli con il modello target. La procedura di campionamento può preservare la distribuzione di output del target, ma questa proprietà non promette, da sola, una latenza inferiore, un throughput superiore o costi operativi più bassi.
Il lavoro fondativo, le varianti come EAGLE ed EAGLE-3 e lo studio del 2026 forniscono tipi diversi di evidenza. La teoria del campionamento spiega una garanzia; i lavori sulle varianti descrivono altri meccanismi e le loro valutazioni; lo studio in vLLM esamina le interazioni tra metodi, carichi e dimensioni del batch all’interno di un runtime. I risultati non vanno fusi come se provenissero da un unico test controllato.
Per una decisione di produzione, la domanda centrale è se la combinazione specifica di modello, proposta, runtime, acceleratore e schema di richieste migliori le metriche importanti per il servizio. L’evidenza minima consiste in un confronto riproducibile con un riferimento equivalente e nelle condizioni di concorrenza previste. Fino ad allora, l’accelerazione osservata in un test circoscritto è un’ipotesi da verificare, non una garanzia di capacità.
Guida decisionale per i team di inferenza
| Se la domanda è… | Quale evidenza serve |
|---|---|
| La distribuzione target viene preservata? | La procedura di campionamento e le condizioni in cui è corretta. |
| La latenza di una richiesta diminuisce? | Una misurazione della latenza con riferimento e configurazione equivalenti. |
| La capacità del servizio migliora? | Throughput misurato con la concorrenza e lo schema di traffico previsti. |
| Il risultato è generalizzabile? | Test sui modelli, runtime, hardware e carichi per cui si intende usare la tecnica. |
Questioni aperte
- Le informazioni verificate disponibili per questa stesura non descrivono nel dettaglio tutte le varianti, i modelli, i carichi, le dimensioni del batch o le metriche primarie valutati nel preprint del 2026.
- Qui non vengono forniti valori sperimentali né dettagli sufficienti per ricostruire in modo indipendente ogni confronto dello studio del 2026.
- L’entità dell’accelerazione e il suo andamento con la concorrenza dipendono dalla configurazione specifica; dalle fonti riassunte non si può dedurre una tendenza quantitativa universale.
- Le valutazioni di EAGLE ed EAGLE-3 sono state condotte in condizioni che non vanno considerate equivalenti tra loro o a quelle dello studio in vLLM.
Continua a esplorare
Fonti consultate
Correzioni e trasparenza
Se trovi un dato errato o non aggiornato, inviaci la pagina e la fonte da verificare.
Proponi una correzione