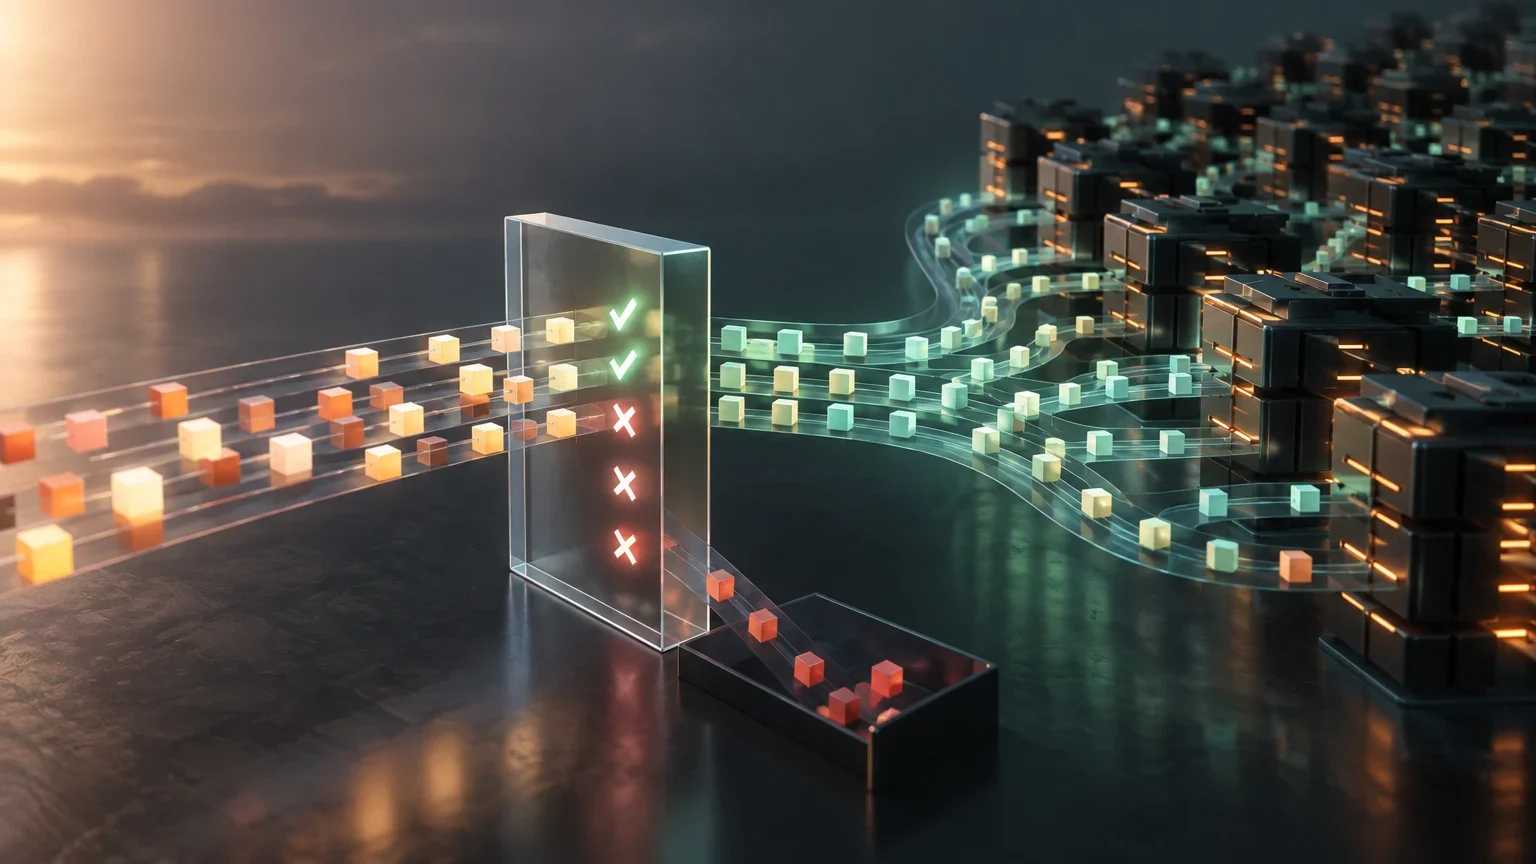
Générer token par token : le coût que la technique cherche à réduire
Dans la génération autorégressive habituelle, le modèle produit un token, puis s’exécute de nouveau pour produire le suivant, en tenant compte des tokens précédents. La succession des étapes limite le calcul qui peut être parallélisé au sein d’une même réponse : le token suivant dépend de l’état laissé par le précédent. Cela ne signifie pas que toutes les opérations d’une exécution sont strictement séquentielles, mais bien que la génération impose une chaîne de dépendances entre les tokens.
Le décodage spéculatif cherche à tirer parti d’une asymétrie : il peut être moins coûteux de proposer plusieurs tokens à l’aide d’un modèle ou d’un mécanisme auxiliaire, puis de les vérifier ensemble avec le modèle cible, que de générer chaque token de sortie au moyen d’une nouvelle passe de ce dernier. L’idée ne supprime pas le travail du modèle cible. Elle le réorganise pour que, lorsque les candidats sont utiles et que la vérification est efficace, une exécution puisse en valider plusieurs.
La question des performances ne se résume donc pas au nombre de tokens proposés par le modèle de brouillon ni au nombre de tokens acceptés par le modèle cible. Le coût de préparation des candidats, le travail nécessaire à leur vérification et la manière dont le runtime planifie ces opérations comptent également. Une technique peut réduire le nombre d’étapes séquentielles tout en ajoutant des calculs qui annulent les économies réalisées.
Fonctionnement du schéma « draft-and-verify »
Dans le schéma de base, un modèle de brouillon propose une séquence de candidats. Le modèle cible calcule les distributions correspondant aux positions de cette séquence, puis la procédure de vérification détermine quels candidats peuvent être conservés. Si un candidat échoue à la vérification, l’étape est corrigée et la génération reprend à partir du résultat approprié. Vérifier plusieurs candidats lors d’une même exécution permet de rechercher davantage de parallélisme que dans la génération token par token.
La proposition du modèle de brouillon ne doit pas nécessairement coïncider avec ce que le modèle cible aurait généré. Le point essentiel est que la procédure d’échantillonnage organise l’acceptation et la correction des candidats de sorte que le résultat final suive la distribution du modèle cible, sous réserve que les conditions de la méthode soient respectées. Il ne faut donc pas décrire cette approche comme un remplacement approximatif du modèle cible : c’est toujours le modèle cible qui détermine la distribution de sortie.
Le nombre de tokens acceptés ne représente qu’une partie du calcul ; ce n’est pas une mesure complète de la vitesse. Un taux d’acceptation élevé peut aller de pair avec une vérification coûteuse. À l’inverse, un taux plus faible peut rester compétitif si le modèle de brouillon est peu coûteux et si le runtime exécute efficacement le travail supplémentaire. La longueur de la séquence spéculative implique elle aussi un compromis : proposer davantage de candidats peut accroître le coût du brouillon et de la vérification.
Cycle simplifié de proposition et de vérification
- 01Le mécanisme de brouillon propose un ou plusieurs tokens candidats.
- 02Le modèle cible évalue les candidats et calcule les distributions nécessaires à leur vérification.
- 03La procédure accepte les candidats compatibles avec l’échantillonnage spéculatif et corrige le point de rejet, le cas échéant.
- 04La génération reprend à partir de la séquence validée ; les économies dépendent du coût total de ce cycle par rapport à la méthode de référence.
Préserver la distribution ne garantit pas un gain de performance
Les travaux de Leviathan et de ses coauteurs présentent le décodage spéculatif comme une manière d’accélérer l’inférence sans modifier la distribution des résultats du modèle cible. Cette garantie dépend de la procédure d’échantillonnage et des conditions mathématiques de la méthode ; elle ne signifie pas que chaque réponse produite sera identique à une réponse particulière obtenue par décodage ordinaire. Elle porte sur la distribution des sorties, et non sur l’obligation de reproduire chaque trajectoire aléatoire à l’identique.
Cette garantie ne signifie pas non plus que toute configuration sera plus rapide. Elle ne détermine pas, à elle seule, le coût du modèle de brouillon, l’efficacité des opérations sur l’accélérateur, le comportement de l’ordonnanceur face à des requêtes concurrentes ni la mémoire disponible. Ces facteurs relèvent de l’exécution. En pratique, la correction de l’échantillonnage et l’intérêt opérationnel doivent être évalués séparément.
Cette distinction évite une interprétation fréquente, mais erronée : préserver la distribution cible ne veut pas dire « accélérer le modèle » de façon universelle. L’affirmation juste est plus circonscrite : la méthode peut préserver la distribution et apporter un gain lorsque la proposition, la vérification et l’implémentation sont favorables dans les conditions mesurées.
D’EAGLE à EAGLE-3 : la proposition change, pas le critère d’évaluation
EAGLE repense la prédiction spéculative en s’appuyant sur des informations issues des caractéristiques internes, au lieu de traiter le modèle de brouillon comme une simple source indépendante de tokens. Les travaux proposent une approche centrée sur l’incertitude de ces caractéristiques. Cette différence de conception importe, car le mécanisme de proposition influe sur les candidats soumis à vérification ainsi que sur le coût de leur génération.
EAGLE-3 est une variante ultérieure dont les travaux portent sur le passage à l’échelle de l’accélération au moyen d’une approche d’entraînement désignée dans le titre de l’article par l’expression « training-time test ». Il ne faut pas présenter ses chiffres comme s’ils étaient directement comparables à ceux de n’importe quelle implémentation d’EAGLE ou du schéma de base. Une comparaison valable exige d’identifier le modèle, le runtime, le matériel, la configuration de génération et la charge de chaque expérience.
En particulier, un résultat rapporté pour SGLang ne peut pas être transposé tel quel à vLLM, pas plus qu’un résultat obtenu avec une taille de lot donnée ne permet de prédire celui d’un autre profil de trafic. Les différences de méthode comptent, mais l’infrastructure et le protocole d’évaluation font aussi partie du résultat.
Éléments à distinguer pour comparer les variantes
| Aspect | Question à se poser | Pourquoi c’est important |
|---|---|---|
| Méthode | S’agit-il du décodage spéculatif de base, d’EAGLE, d’EAGLE-3 ou d’une autre variante ? | Les stratégies de proposition et leur coût ne sont pas nécessairement identiques. |
| Runtime | La mesure porte-t-elle sur vLLM, SGLang ou un autre environnement ? | La planification et l’implémentation peuvent modifier le travail réellement effectué. |
| Charge | Quelles tailles de lot, quel niveau de concurrence et quel profil de requêtes ont été mesurés ? | Un gain sur une charge ne prouve pas qu’il existe sur une autre. |
| Métrique | La mesure porte-t-elle sur la latence, le débit, l’acceptation ou un autre indicateur ? | Chaque métrique répond à une question différente. |
Ce que l’étude de 2026 apporte — et ce qu’elle ne permet pas de conclure
Le préprint « Speculative Decoding: Performance or Illusion? » propose une étude systématique de variantes du décodage spéculatif dans vLLM, avec différents modèles, charges et tailles de lot. Parmi les résultats mis en avant dans la description des travaux figurent le fait que la vérification par le modèle cible peut représenter une part importante de l’exécution et que l’acceptation des tokens varie selon leur position, la requête et le jeu de données. Ces observations remettent en question l’utilisation d’un unique taux moyen d’acceptation comme indicateur suffisant.
Il ne faut pas en conclure que la technique n’accélère jamais, mais plutôt que le résultat dépend de l’endroit où le temps est consacré. Si la vérification des candidats absorbe une grande partie du calcul, l’avantage attendu de l’acceptation de plusieurs tokens peut s’amenuiser. Et si le taux d’acceptation varie selon les positions ou les requêtes, une moyenne agrégée peut masquer des cas où le travail supplémentaire du modèle de brouillon n’est pas compensé.
Les informations vérifiées dont nous disposons pour cet article ne permettent pas de détailler précisément toutes les variantes, tous les modèles, toutes les charges, les tailles de lot, les métriques principales ni les configurations exactes du préprint. Elles ne suffisent pas non plus à reproduire les valeurs de chaque expérience. Nous ne rapportons donc pas de chiffres et n’affirmons pas qu’une variante donnée l’emporte dans tous les scénarios. Pour une analyse quantitative, ces détails doivent être vérifiés dans le texte intégral et dans la configuration de chaque expérience.
Le préprint et les travaux fondateurs répondent à des questions différentes. Le premier étudie le comportement d’implémentations et de charges dans un runtime ; les seconds étayent la possibilité de préserver la distribution au moyen de la procédure d’échantillonnage. Utiliser le résultat mathématique des travaux fondateurs comme preuve des performances d’une configuration vLLM reviendrait à confondre deux niveaux de preuve.
Pourquoi le taux d’acceptation ne suffit pas à expliquer la vitesse
Un taux ou une longueur d’acceptation indique quelle part de la proposition survit à la vérification, mais ne tient pas compte des autres coûts : exécuter le modèle de brouillon, préparer les états nécessaires, vérifier les candidats et coordonner les opérations au sein du runtime. Cette mesure ne dit pas non plus, à elle seule, combien de temps prend une requête complète ni combien de requêtes le système peut traiter par unité de temps.
La concurrence rend cette distinction encore plus importante. Un service partagé traite des requêtes qui se disputent les ressources et peuvent avoir des longueurs différentes. Lorsque la taille du lot ou le niveau de concurrence augmente, la quantité de travail utile par exécution peut changer, tout comme la pression sur la mémoire et la planification. Un gain de latence mesuré avec un petit lot ne prouve ni que la latence en file d’attente diminue dans un service concurrent, ni que sa capacité augmente.
Il convient de distinguer au moins trois résultats. La latence totale indique combien de temps une requête met à se terminer ; la latence par token décrit le rythme de génération selon une définition de mesure qui doit être précisée ; le débit mesure la quantité de travail achevée par unité de temps. Ces mesures ne sont pas interchangeables, et une optimisation peut favoriser l’une sans améliorer les autres dans la même proportion.
Comment évaluer une affirmation d’accélération
La comparaison doit partir d’une référence claire : le décodage autorégressif qui serait utilisé avec le même modèle et dans le même environnement. Si le runtime, le matériel ou la configuration changent en même temps, il devient impossible d’attribuer avec certitude la différence à la technique spéculative. Il faut aussi préciser les conditions de génération, car elles influent sur les distributions vérifiées et sur le profil de travail.
L’équipe doit ensuite choisir des métriques en fonction de son objectif. Pour une interaction individuelle, la latence perçue peut être déterminante ; pour un service soumis à une demande variable, la distribution des latences et la capacité sous concurrence peuvent être prioritaires ; pour la capacité totale, c’est le débit qui compte. L’acceptation des tokens et le coût de vérification aident à expliquer le résultat, mais ne remplacent pas les métriques du service.
La documentation officielle de vLLM indique que les résultats dépendent du modèle, du trafic, du matériel et de la configuration, et recommande d’effectuer les mesures dans l’environnement prévu. Cette recommandation ne dispense pas de publier le protocole : celui-ci permet de comprendre à quel contexte le résultat s’applique et si sa reproduction est raisonnable.
Protocole pratique d’évaluation
- 01Définir le modèle cible, la méthode de référence, le runtime, le matériel et la configuration de génération.
- 02Définir une charge représentative, notamment la taille de lot et les niveaux de concurrence à évaluer.
- 03Mesurer la latence et le débit correspondant aux objectifs du service ; consigner aussi l’acceptation et le coût de vérification pour expliquer les résultats.
- 04Répéter les mesures dans les mêmes conditions et documenter les différences entre tailles de lot et profils de trafic.
- 05Présenter séparément les résultats de chaque variante et de chaque environnement, sans les fusionner en un classement unique lorsque les chiffres proviennent de protocoles différents.
Conclusion : les preuves valables portent sur le système dans son ensemble
Le décodage spéculatif offre une stratégie pour réduire le coût séquentiel de la génération de tokens : proposer plusieurs candidats et les vérifier avec le modèle cible. La procédure d’échantillonnage peut préserver la distribution de sortie du modèle cible, mais cette propriété ne garantit pas, à elle seule, une latence moindre, un débit supérieur ou un coût opérationnel réduit.
Les travaux fondateurs, les variantes comme EAGLE et EAGLE-3, et l’étude de 2026 apportent des types de preuves différents. La théorie de l’échantillonnage explique une garantie ; les travaux sur les variantes décrivent d’autres mécanismes et leurs évaluations ; l’étude menée dans vLLM examine les interactions entre méthodes, charges et tailles de lot au sein d’un runtime. Il ne faut pas fusionner leurs résultats comme s’ils provenaient d’un unique test contrôlé.
Pour décider d’un déploiement en production, la question centrale est de savoir si la combinaison précise du modèle, du mécanisme de proposition, du runtime, de l’accélérateur et du profil des requêtes améliore les métriques qui comptent pour le service. Le minimum requis est une comparaison reproductible avec une référence équivalente et sous le niveau de concurrence prévu. En attendant, une accélération observée lors d’un test limité est une hypothèse à valider, et non une garantie de capacité.
Guide de décision pour les équipes d’inférence
| Si la question est… | Les preuves nécessaires |
|---|---|
| La distribution cible est-elle préservée ? | La procédure d’échantillonnage et les conditions dans lesquelles elle est correcte. |
| La latence d’une requête diminue-t-elle ? | Une mesure de latence comparée à une référence, avec des configurations équivalentes. |
| La capacité du service s’améliore-t-elle ? | Une mesure du débit sous le niveau de concurrence et le profil de trafic prévus. |
| Le résultat peut-il être généralisé ? | Des tests sur les modèles, le runtime, le matériel et les charges auxquels la technique est destinée. |
Questions ouvertes
- Les informations vérifiées disponibles pour cet article ne détaillent pas toutes les variantes, tous les modèles, toutes les charges, les tailles de lot ni les métriques principales évalués dans le préprint de 2026.
- Aucun chiffre expérimental ni détail suffisant pour reconstituer indépendamment chaque comparaison de l’étude de 2026 n’est fourni ici.
- L’ampleur de l’accélération et son évolution avec la concurrence dépendent de la configuration précise ; les sources résumées ne permettent pas d’en déduire une tendance quantitative universelle.
- Les évaluations d’EAGLE et d’EAGLE-3 ont été menées dans des conditions qui ne doivent pas être considérées comme équivalentes entre elles ni à celles de l’étude dans vLLM.
Poursuivre l’exploration
Sources consultées
Corrections et transparence
Si vous repérez une information incorrecte ou obsolète, envoyez-nous la page et la source à vérifier.
Proposer une correction