Definition in einem Satz
Aufteilung von Dokumenten in abrufbare Einheiten, die genügend Kontext beibehalten, um auf Fragen zu antworten.
Definition und Abgrenzung verwandter Konzepte
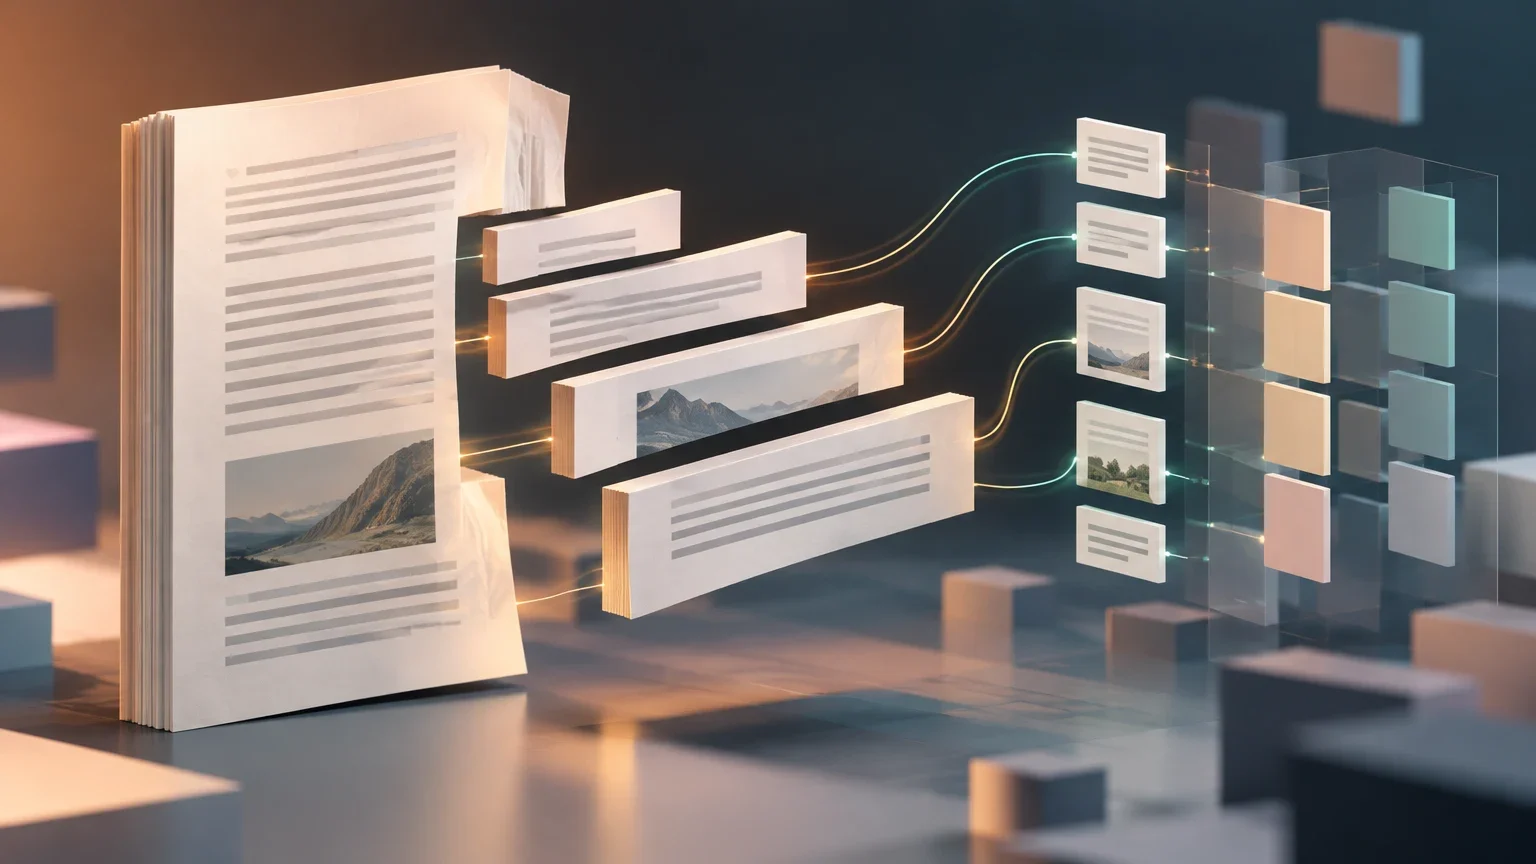
Die Dokumentfragmentierung, technisch als Chunking bezeichnet, ist der Prozess, ein Dokument oder eine Informationsquelle in kleinere Einheiten, sogenannte Chunks, aufzuteilen. Ziel ist es, die Speicherung, Verarbeitung und Abrufbarkeit von Informationen in KI-Systemen zu erleichtern, insbesondere in Architekturen der Retrieval-Augmented Generation (RAG). In diesen Systemen werden nicht vollständige Dokumente verarbeitet, sondern spezifische Fragmente abgerufen, die den nötigen Kontext für die Generierung einer kohärenten Antwort liefern.
Es ist entscheidend, die Fragmentierung von anderen Prozessen zu unterscheiden. Die Fragmentierung erstellt die Inhaltseinheiten; die Indexierung organisiert diese Informationen, um sie auffindbar zu machen; und die Passage-Retrieval (Abruf von Abschnitten) bestimmt, welche dieser Einheiten für eine bestimmte Anfrage relevant sind. Verwechslungen dieser Schritte können dazu führen, dass die Größe der Fragmente optimiert wird, ohne dass die Qualität der finalen Antwort steigt, da die Abrufbarkeit auch vom Suchalgorithmus, der Qualität der Embeddings und der Formulierung der Anfrage abhängt.
Die Abgrenzung dieser Schritte ist auch deshalb wichtig, weil sie unterschiedliche Probleme lösen. Ein Fragment kann sinnvoll zugeschnitten sein, aber im Index schlecht auffindbar bleiben; umgekehrt kann ein Suchverfahren einen Eintrag finden, dessen Inhalt für eine belastbare Antwort zu wenig Kontext enthält. Die Fragmentierung legt somit zunächst fest, welche Einheiten überhaupt für Suche und Verarbeitung bereitstehen. Ob eine bestimmte Einheit bei einer konkreten Anfrage gefunden und anschließend passend verwendet wird, hängt zusätzlich von den nachfolgenden Schritten ab. Eine Verbesserung an einer Stelle der Pipeline ist daher nicht automatisch eine Verbesserung des Gesamtergebnisses.
Im RAG-Ablauf bilden die abgerufenen Fragmente eine Informationsgrundlage für die Antwortgenerierung, ersetzen aber nicht die Prüfung ihrer Relevanz und Vollständigkeit. Ein passender Abschnitt kann einzelne Belege liefern, während wichtige Erläuterungen in einem anderen Fragment liegen. Werden solche Zusammenhänge beim Teilen des Dokuments aufgelöst, kann das die spätere Interpretation erschweren. Die Trennung zwischen Fragmentierung, Indexierung und Passage-Retrieval macht diese Abhängigkeiten sichtbar: Sie verhindert, dass Schwierigkeiten beim Abruf vorschnell allein der Fragmentgröße zugeschrieben werden, obwohl auch Suchalgorithmus, Embeddings und Anfrageformulierung eine Rolle spielen.
Unterschiede zwischen zentralen Konzepten
Tabelle, die die Funktion jedes Prozesses in der Retrieval-Pipeline unterscheidet.
| Konzept | Hauptfunktion |
|---|---|
| Fragmentierung (Chunking) | Teilt den Inhalt in kleinere Einheiten auf. |
| Indexierung | Organisiert Informationen zur Auffindbarkeit. |
| Passage-Retrieval | Findet relevante Fragmente für eine Anfrage. |
| RAG | Nutzt abgerufene Informationen zur Antwortgenerierung. |
Funktionsweise Schritt für Schritt
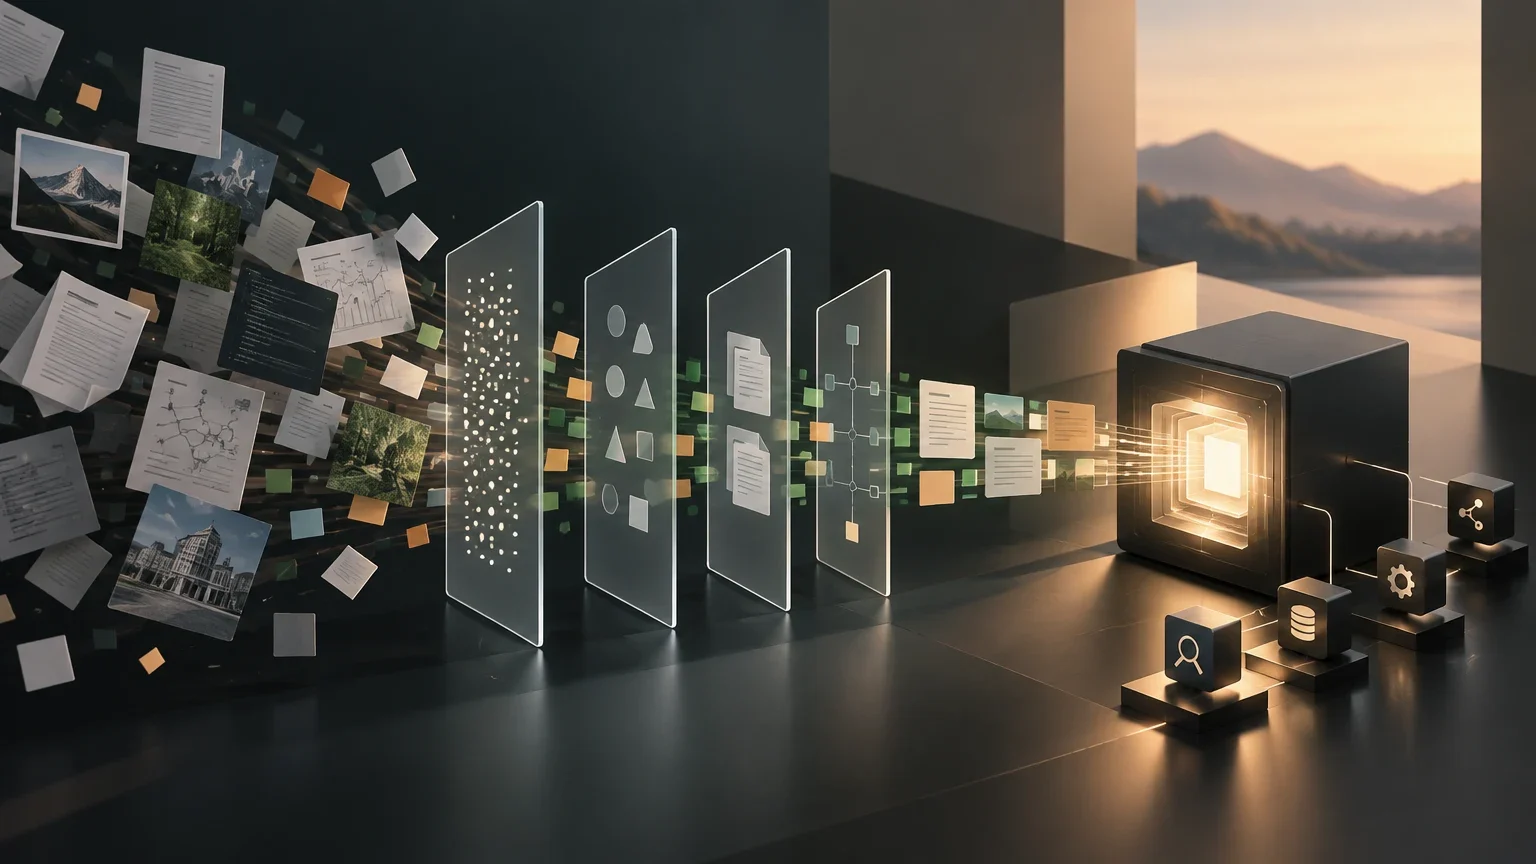
Der Fragmentierungsprozess folgt in der Regel einer logischen Abfolge, die mit der Vorbereitung des Inhalts beginnt. Bevor der Text geteilt wird, extrahiert das System die ursprüngliche Struktur, einschließlich Titel, Absätze, Tabellen und Metadaten. Die Qualität dieser Extraktion ist entscheidend: Wenn die Hierarchie des Dokuments verloren geht, können die resultierenden Fragmente den Kontext fehlen, der für ihre korrekte Interpretation notwendig ist.
Anschließend wird eine Fragmentierungsstrategie ausgewählt, die bestimmt, wie der Text geschnitten wird. Diese Entscheidung beeinflusst direkt die Länge der Fragmente und welche Informationen zusammengehalten werden. Sobald die Regeln definiert sind, werden die Fragmente generiert, denen Identifikatoren und Metadaten wie die Quell-URL oder die Position im Dokument zugewiesen werden. Schließlich werden diese Fragmente indexiert, oft durch die Erstellung vektorbasierter Embeddings, um bereit zu sein für den Abruf, wenn eine Benutzeranfrage eingeht.
Die Vorbereitung beeinflusst, welche Grenzen sich beim späteren Teilen überhaupt sinnvoll setzen lassen. Werden Titel, Absätze oder Tabellen bei der Textextraktion nicht zuverlässig erkannt, kann eine Fragmentierungsregel eine unpassende Stelle als Grenze behandeln. Dabei geht nicht nur die sichtbare Gliederung verloren: Auch der Bezug eines Absatzes zu seinem Abschnitt oder die Zuordnung von Werten zu Beschriftungen kann undeutlich werden. Deshalb ist die Prüfung der extrahierten Struktur ein eigener Teil der Vorbereitung und nicht bloß ein technischer Zwischenschritt vor der eigentlichen Aufteilung.
Die einzelnen Operationen bauen aufeinander auf, bleiben aber begrifflich verschieden. Zuerst wird der Inhalt samt seiner erkennbaren Ordnung vorbereitet; danach legt die Strategie fest, welche Textteile zusammenbleiben. Bei der Generierung entstehen daraus Einheiten, die mit Identifikatoren und Angaben zu ihrer Herkunft oder Position versehen werden können. Die Indexierung macht diese Einheiten für spätere Suchvorgänge zugänglich. Erst wenn eine Anfrage eingeht, werden daraus relevante Fragmente ausgewählt. Diese Abfolge verdeutlicht, weshalb die Erzeugung eines Chunks nicht mit dessen Auffindbarkeit gleichzusetzen ist: Die Einheit kann vorhanden sein, ohne für eine bestimmte Anfrage unter den passenden Ergebnissen zu erscheinen.
Metadaten wie die Position im Dokument oder die Quell-URL helfen dabei, ein Fragment seinem Ausgangsmaterial zuzuordnen. Sie können außerdem die Einordnung in die Dokumentstruktur unterstützen, sofern diese bei der Vorbereitung erhalten wurde. Ihre Anwesenheit garantiert jedoch nicht, dass der Inhalt einer Anfrage entspricht oder alle erforderlichen Informationen umfasst. Sie ergänzen den Text um Herkunfts- und Ordnungsangaben; die Auswahl relevanter Einheiten bleibt Aufgabe des Abrufs. Ebenso ist ein Vektor-Embedding eine mögliche Grundlage der Indexierung, nicht mit dem Chunk selbst oder mit dem gesamten Retrieval-Schritt gleichzusetzen.
Stufen der Fragmentierungspipeline
Abfolge von Operationen, um ein Dokument in abrufbare Einheiten zu verwandeln.
- 01Vorbereitung: Extraktion von Text und Struktur (Titel, Tabellen, Metadaten).
- 02Strategie: Auswahl der Aufteilungsmethode (fest, semantisch, hierarchisch).
- 03Generierung: Erstellung von Chunks mit Identifikatoren und Metadaten.
- 04Indexierung: Speicherung in Vektordatenbanken oder Suchindizes.
- 05Abruf: Auswahl relevanter Chunks bei einer Anfrage.
Hauptstrategien der Dokumentfragmentierung
Es gibt keine einzige richtige Art, ein Dokument zu fragmentieren. Die Wahl der Strategie hängt von der Art des Inhalts, der Komplexität der erwarteten Anfragen und den verfügbaren Rechenressourcen ab. Die häufigsten Strategien umfassen die Fragmentierung nach fester Länge, die einfach ist, aber Ideen mitten durchschneiden kann; die strukturbasierte Fragmentierung, die Überschriften und Absätze respektiert; und die semantische Fragmentierung, die Themenwechsel erkennt, um zusammenhängende Ideen beieinander zu halten.
Semantische und hierarchische Fragmentierung sind besonders nützlich für komplexe Dokumente. Die semantische Methode nutzt Sprachmodelle oder Embeddings, um zu identifizieren, wo die Bedeutung wechselt, und vermeidet willkürliche Aufteilungen. Die hierarchische Fragmentierung organisiert den Inhalt in Ebenen (Dokument, Abschnitt, Absatz), was es ermöglicht, eine kleine Einheit für die Präzision der Suche abzurufen und deren übergeordneten Abschnitt zu verwenden, um dem generativen Modell einen breiteren Kontext zu bieten.
Bei einer festen Länge entstehen klar kontrollierbare Grenzen, doch diese Grenzen müssen nicht mit den inhaltlichen Grenzen eines Dokuments übereinstimmen. Beginnt eine neue Aussage kurz vor dem Ende eines Fragments oder wird eine Erläuterung in die nächste Einheit verschoben, kann der jeweilige Ausschnitt ohne seinen Zusammenhang schwerer verständlich sein. Das macht die Methode nicht grundsätzlich ungeeignet; es zeigt vielmehr, dass ihre einfache und kontrollierbare Aufteilung gegen die Gefahr abgewogen werden muss, Sätze oder zusammengehörige Gedanken zu trennen. Welche Wirkung das im konkreten Fall hat, lässt sich aus der Strategie allein nicht abschließend ableiten.
Eine strukturbasierte Aufteilung orientiert sich dagegen an der vorhandenen Gliederung. Ihre Eignung hängt deshalb davon ab, ob Überschriften und Absätze im Ausgangsdokument aussagekräftig und zuverlässig extrahiert wurden. Sind die Grenzen unklar oder fehlen sie, kann die Struktur allein keine passende Gruppierung garantieren. Semantische Verfahren setzen an einer anderen Eigenschaft an: Sie versuchen, thematische beziehungsweise bedeutungsbezogene Wechsel zu erkennen, etwa mithilfe von Sprachmodellen oder Embeddings. Das kann zusammengehörige Ideen beieinanderhalten, bringt aber mehr Rechenaufwand und Komplexität mit sich und macht die Methode nicht in jedem Fall überlegen.
Die hierarchische Strategie behandelt Dokument, Abschnitt und Absatz als miteinander verbundene Ebenen. Dadurch kann eine kleinere Einheit für eine gezielte Suche dienen, während ihr übergeordneter Abschnitt zusätzlichen Zusammenhang bereitstellt. Diese Kombination eröffnet einen Ausgleich zwischen präziser Auswahl und breiterem Kontext, verlangt aber, dass die Beziehungen zwischen den Ebenen erhalten und im Retrieval berücksichtigt werden. Sie ist deshalb nicht einfach mit einer einzelnen größeren Einheit gleichzusetzen: Entscheidend ist, dass die kleinere Einheit innerhalb ihrer übergeordneten Gliederung eingeordnet bleibt. Auch bei dieser Strategie hängt das Ergebnis davon ab, ob die Struktur des Dokuments korrekt erfasst wurde und wie die Suche die Ebenen nutzt.
Vergleich der Chunking-Strategien
Zusammenfassung der Vorteile und Einschränkungen der am häufigsten verwendeten Methoden.
| Strategie | Hauptvorteil | Haupteinschränkung |
|---|---|---|
| Feste Länge | Einfach zu implementieren und zu kontrollieren. | Kann Sätze oder vollständige Ideen durchschneiden. |
| Strukturbasiert | Erhält den thematischen Kontext von Abschnitten. | Hängt von der Qualität der Dokumentstruktur ab. |
| Semantisch | Hält zusammenhängende Ideen nach Bedeutung zusammen. | Höhere Rechenkosten und Komplexität. |
| Hierarchisch | Balance zwischen Suchpräzision und breitem Kontext. | Fügt der Retrieval-Pipeline Komplexität hinzu. |
Drei ausgearbeitete Beispiele in relevanten Bereichen
Im Bereich der technischen Dokumentation ist die fragmentierung basierend auf Überschriften oft am effektivsten. Ein Softwarehandbuch wird beispielsweise in Abschnitte und Unterabschnitte unterteilt. Dies ermöglicht es, dass ein Fragment über 'Netzwerkkonfiguration' den Kontext des Abschnitts 'Netzwerke' beibehält, sodass das Modell die Anweisungen nicht ohne Kenntnis des zugrunde liegenden Systems interpretiert. Bei einer festen Fragmentierung könnte eine kritische Anweisung von ihrer Einleitung getrennt werden, was zu einer unvollständigen Antwort führt.
Für rechtliche Verträge muss die Fragmentierung die Struktur der Klauseln respektieren. Ein Vertrag wird in Artikel und rechtliche Absätze unterteilt. Hier ist Präzision von vitaler Bedeutung: Eine Haftungsklausel muss zusammen mit ihrem rechtlichen Kontext abgerufen werden. Semantische Fragmentierung kann nützlich sein, wenn der Vertrag Themen wechselt, aber die hierarchische Struktur ist in der Regel zuverlässiger, um die Integrität der rechtlichen Verpflichtungen zu wahren. In diesem Fall ist die Überlappung weniger relevant als die Integrität der rechtlichen Einheit.
In Kundenservice-Systemen mit FAQs kann die Fragmentierung unnötig sein, wenn die Einträge bereits kurz und in sich abgeschlossen sind. Jede Frage und ihre Antwort bilden ein natürliches Chunk. Das Erzwingen einer zusätzlichen Aufteilung fügt nur Rauschen hinzu. Wenn die Antworten jedoch umfangreich sind, ermöglicht eine rekursive Fragmentierung, die Absätze respektiert, den Abruf des spezifischen Teils der Antwort, der die Frage des Nutzers beantwortet, ohne das Modell mit irrelevanten Informationen aus anderen Fragen zu belasten.
Die Beispiele verdeutlichen, dass dieselbe Aufteilungsregel in unterschiedlichen Dokumenten verschiedene Folgen haben kann. Beim Softwarehandbuch bildet die Gliederung in Abschnitte und Unterabschnitte einen Bezugspunkt für die Interpretation einer Anweisung. Bleibt ein Fragment der passenden Überschrift zugeordnet, lässt sich eher erkennen, auf welches Thema es sich bezieht. Wird dagegen eine wichtige Anweisung von ihrem einleitenden Zusammenhang getrennt, kann der abgerufene Ausschnitt unvollständig wirken. Daraus folgt nicht, dass Überschriften in jedem Dokument automatisch die beste Grenze liefern; maßgeblich ist, ob sie die inhaltliche Ordnung tatsächlich abbilden.
Bei einem Vertrag steht die Einheit der Klausel im Vordergrund. Eine einzelne Passage kann ihren Sinn erst zusammen mit dem zugehörigen rechtlichen Zusammenhang entfalten. Die hierarchische Aufteilung kann diese Beziehung unterstützen, wenn Artikel und Absätze im Dokument zuverlässig erhalten bleiben. Eine semantische Gruppierung kann thematische Wechsel berücksichtigen, bietet aber nicht automatisch denselben Schutz für die formale Gliederung. Deshalb ist im beschriebenen Beispiel die Bewahrung der rechtlichen Einheit wichtiger als eine zusätzliche Wiederholung von Text an Fragmentgrenzen. Das ist eine kontextbezogene Gewichtung und kein allgemeiner Nachweis, dass eine Strategie für alle Verträge überlegen wäre.
Bei kurzen, eigenständigen FAQ-Einträgen kann die Frage zusammen mit ihrer Antwort bereits eine sinnvolle Einheit bilden. Eine weitere Aufteilung würde dann möglicherweise keinen zusätzlichen Suchnutzen schaffen und stattdessen Zusammengehöriges auseinanderziehen. Sind Antworten länger, kann eine an Absätzen orientierte rekursive Aufteilung kleinere, gezieltere Ausschnitte bereitstellen. Dabei bleibt wichtig, dass der abgerufene Teil die konkrete Nutzerfrage tatsächlich beantwortet und nicht durch den Verlust des umgebenden Zusammenhangs missverständlich wird. Die Beispiele zeigen somit keine universelle Rangfolge der Verfahren, sondern wie Dokumentstruktur, Länge und erwartete Anfrage die Wahl der Einheit beeinflussen.
Bewertung der Ergebnisse und häufige Fehler
Die Bewertung einer Fragmentierungsstrategie sollte nicht auf Intuition beruhen, sondern auf Metriken für Abrufbarkeit und Antwortqualität. Es ist notwendig zu messen, ob relevante Fragmente unter den ersten Ergebnissen erscheinen (Recall@k), ob sie alle Informationen enthalten, die für die Antwort benötigt werden (Beweisabdeckung), und ob das System Antworten generiert, die den Quellen treu sind. Auch Latenz, Speicherkosten und die Wartungsfreundlichkeit bei Dokumentaktualisierungen müssen berücksichtigt werden.
Ein häufiger Fehler ist die Annahme, dass es eine universell optimale Fragmentgröße gibt. Tatsächlich hängt die geeignete Größe von der Dokumentart und den Anfragen ab. Ein weiterer häufiger Fehler ist die Ignorierung der Überlappung (Overlap) oder deren übermäßige Nutzung. Eine moderate Überlappung kann helfen, Informationen zu erhalten, die die Grenzen zwischen Fragmenten überschreiten, aber ein Überschuss erzeugt Redundanz und kann das Modell verwirren. Schließlich können Tabellen und strukturierte Daten, die als Fließtext behandelt werden, die Beziehungen zwischen Werten und Labels verändern, was spezifische Vorverarbeitungsstrategien erfordert.
Für eine aussagekräftige Bewertung sollte eine Strategie an den Aufgaben gemessen werden, für die die Fragmente später verwendet werden. Recall@k beschreibt dabei, ob relevante Einheiten unter den ersten k Suchergebnissen erscheinen; die Beweisabdeckung fragt ergänzend, ob die abgerufenen Inhalte genügend Informationen für die Antwort enthalten. Diese Perspektiven sind nicht austauschbar: Ein relevantes Fragment kann gefunden werden und dennoch wesentliche Belege auslassen. Zusätzlich ist zu prüfen, ob die erzeugte Antwort den Quellen treu bleibt. Zusammen helfen diese Kriterien, eine gute Suchposition nicht fälschlich mit einer vollständigen und verlässlichen Antwort gleichzusetzen.
Auch die praktischen Folgen einer Aufteilung gehören in die Beurteilung. Latenz und Speicherkosten können sich mit der Anzahl und Größe der Einheiten verändern; die Wartungsfreundlichkeit zeigt sich, wenn Dokumente aktualisiert werden müssen. Eine Strategie, die bei der ersten Verarbeitung passende Fragmente erzeugt, kann bei Änderungen zusätzlichen Aufwand verursachen, wenn Einheiten oder ihre Zuordnungen erneut gepflegt werden müssen. Diese Kriterien sollten neben Abrufbarkeit und Antwortqualität betrachtet werden, weil eine Entscheidung für kleinere oder stärker strukturierte Einheiten nicht nur den Suchvorgang betrifft. Welches Gewicht jedes Kriterium erhält, hängt von der jeweiligen Anwendung ab; aus den genannten Kennzahlen ergibt sich kein einzelnes universelles Optimum.
Die Größe eines Fragments lässt sich daher nicht unabhängig von Dokumenttyp und Anfrage beurteilen. Kleine Einheiten können gezielte Ausschnitte ermöglichen, zugleich aber Zusammenhänge aufteilen; größere Einheiten können mehr Kontext bewahren, zugleich aber Informationen enthalten, die für die konkrete Anfrage nicht nötig sind. Ebenso ist Überlappung kein pauschaler Ersatz für eine passende Grenze. Die Wiederholung eines Teils im nächsten Fragment kann Randinformationen verfügbar halten, erhöht jedoch die Redundanz. Wie stark sich das auswirkt, hängt von Inhalt und konkreter Implementierung ab und sollte anhand der Abrufleistung geprüft werden; ein allgemein gültiger Prozentsatz lässt sich nicht festlegen.
Tabellen und andere strukturierte Daten erfordern besondere Aufmerksamkeit, weil ihre Bedeutung häufig aus der Beziehung zwischen Werten und Beschriftungen entsteht. Werden solche Inhalte schlicht wie fortlaufender Fließtext behandelt, kann eine Aufteilung diese Zuordnung auseinanderreißen oder weniger deutlich machen. Die Vorverarbeitung sollte daher darauf ausgerichtet sein, die vorhandenen Beziehungen zu erhalten, statt lediglich Text in gleichmäßige Abschnitte zu zerlegen. Das ergänzt die übrigen Bewertungsfragen: Auch ein formal auffindbares Fragment ist nur dann brauchbar, wenn die darin enthaltenen Angaben in ihrer ursprünglichen Beziehung interpretiert werden können.