Definición en una frase
División de documentos en unidades recuperables que conservan suficiente contexto para responder preguntas.
Definición y conceptos que no deben confundirse
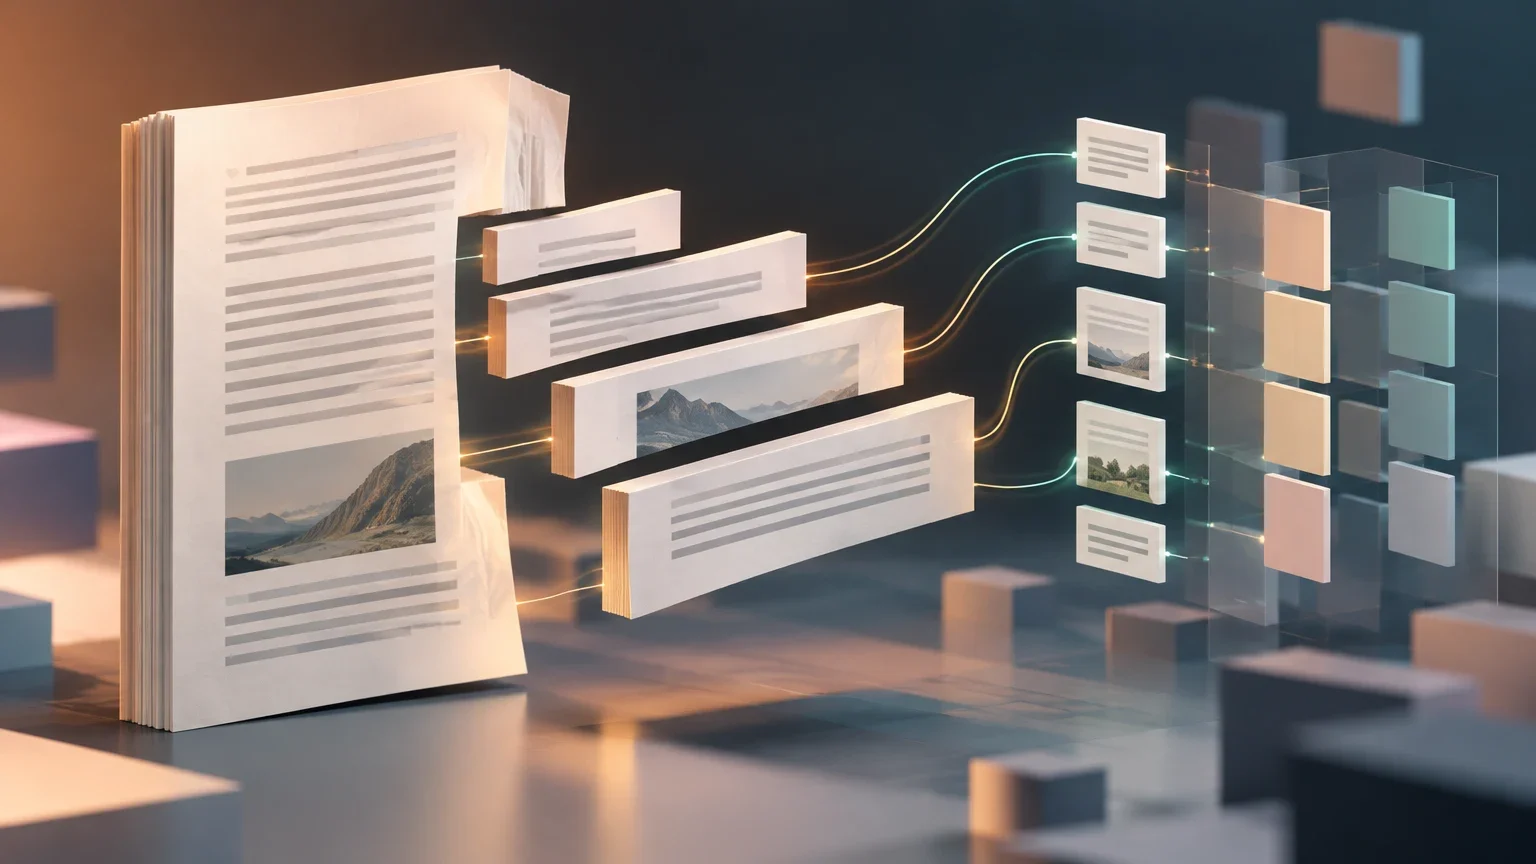
La fragmentación de documentos, conocida técnicamente como chunking, es el proceso de dividir un documento o fuente de información en unidades más pequeñas, denominadas fragmentos o chunks. El objetivo es facilitar el almacenamiento, el procesamiento y la recuperación de la información en sistemas de inteligencia artificial, especialmente en arquitecturas de Recuperación Aumentada por Generación (RAG). En estos sistemas, en lugar de procesar documentos completos, se recuperan fragmentos específicos que aportan el contexto necesario para generar una respuesta coherente.
Es fundamental distinguir la fragmentación de otros procesos relacionados. La fragmentación crea las unidades de contenido; la indexación organiza esa información para que sea localizable; y la recuperación de pasajes determina cuáles de esas unidades son pertinentes para una consulta concreta. Confundir estas etapas puede llevar a optimizar el tamaño de los fragmentos sin mejorar la calidad de la respuesta final, ya que la recuperación depende también del algoritmo de búsqueda, la calidad de los embeddings y la formulación de la consulta.
La distinción entre fragmentación e indexación es crucial porque cada etapa resuelve un problema técnico distinto dentro del flujo de trabajo. Mientras que la fragmentación se centra en la segmentación física o lógica del texto para adaptarlo a las ventanas de contexto de los modelos, la indexación se ocupa de la representación matemática de esos fragmentos. Si la fragmentación es deficiente, la indexación no puede compensar la pérdida de coherencia semántica, ya que los embeddings generados a partir de textos truncados o descontextualizados carecerán de la riqueza necesaria para ser recuperados con precisión ante consultas complejas.
Además, la recuperación de pasajes actúa como el puente entre el almacenamiento y la generación. No se trata simplemente de encontrar el fragmento más similar textualmente, sino de identificar aquel que contenga la evidencia necesaria para fundamentar la respuesta. Confundir la optimización del tamaño del chunk con la mejora de la recuperación puede llevar a un falso sentido de progreso, donde se ajustan parámetros de longitud sin abordar problemas más profundos como la relevancia semántica o la estructura de la base de datos vectorial subyacente.
Diferencias entre conceptos clave
Tabla que distingue la función de cada proceso en el pipeline de recuperación.
| Concepto | Función principal |
|---|---|
| Fragmentación (Chunking) | Divide el contenido en unidades más pequeñas. |
| Indexación | Organiza la información para su localización. |
| Recuperación de pasajes | Encuentra fragmentos pertinentes para una consulta. |
| RAG | Utiliza información recuperada para generar respuestas. |
Funcionamiento paso a paso
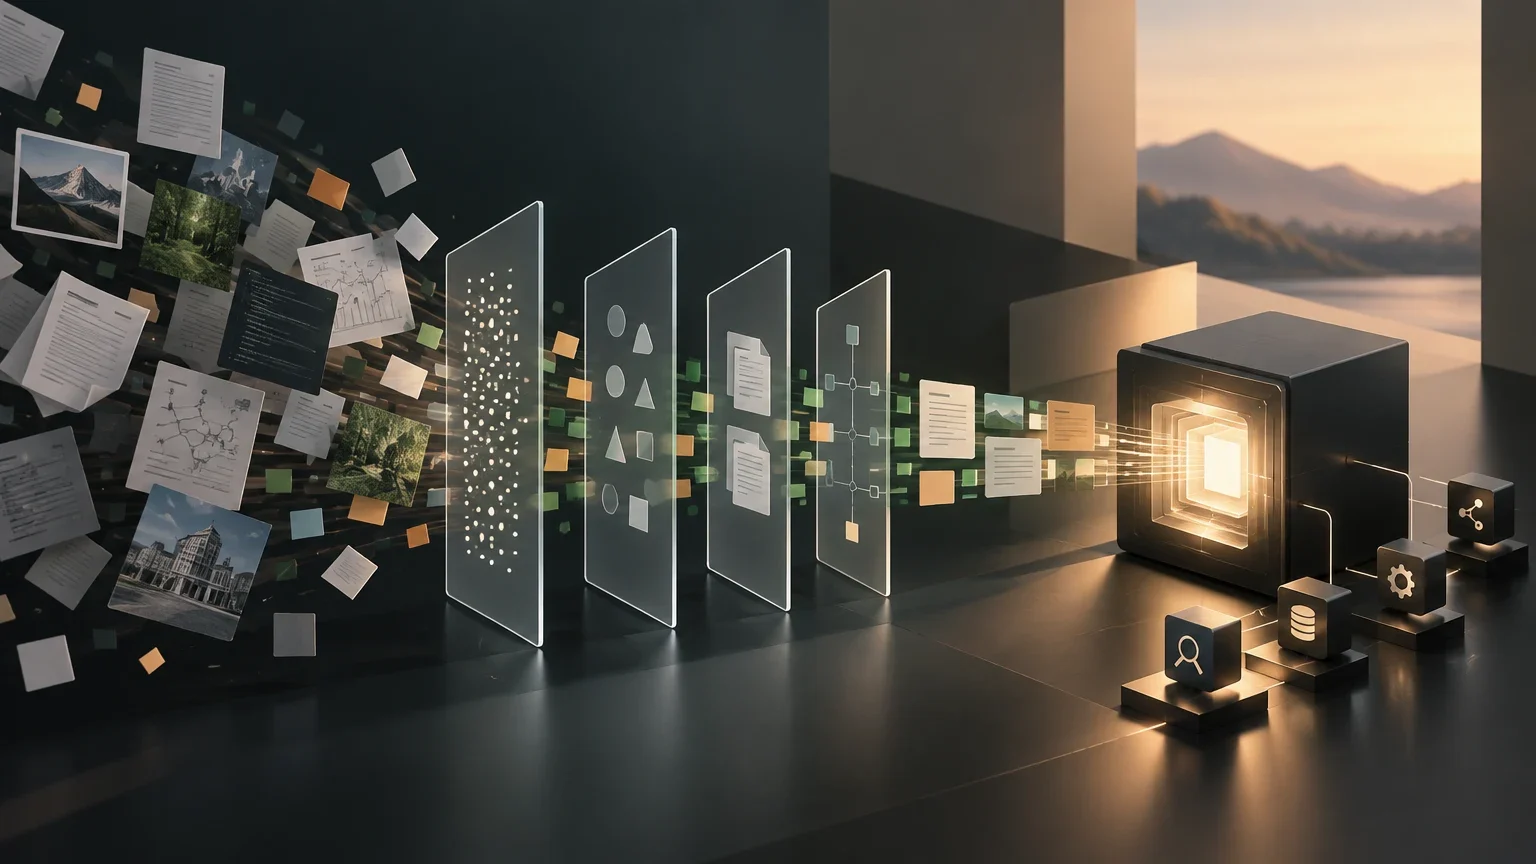
El proceso de fragmentación habitualmente sigue una secuencia lógica que comienza con la preparación del contenido. Antes de dividir el texto, el sistema extrae la estructura original, incluyendo títulos, párrafos, tablas y metadatos. La calidad de esta extracción es crítica: si se pierde la jerarquía del documento, los fragmentos resultantes pueden carecer del contexto necesario para ser interpretados correctamente.
A continuación, se selecciona una estrategia de fragmentación que determina cómo se cortará el texto. Esta decisión influye directamente en la longitud de los fragmentos y en qué información se mantiene unida. Una vez definidas las reglas, se generan los fragmentos, a los que se les asignan identificadores y metadatos como la URL de origen o la posición dentro del documento. Finalmente, estos fragmentos se indexan, a menudo mediante la creación de embeddings vectoriales, para estar listos para la recuperación cuando llegue una consulta del usuario.
La fase de preparación es a menudo subestimada, pero determina el techo de calidad de todo el sistema. La extracción de metadatos no es un paso opcional, sino una necesidad estructural. Al conservar la jerarquía de títulos y la posición relativa de cada fragmento, se permite al sistema de recuperación aplicar filtros contextuales posteriores. Por ejemplo, saber que un fragmento pertenece a la sección de 'Errores' en un manual técnico permite descartar automáticamente fragmentos de la sección de 'Instalación' cuando la consulta del usuario se centra en la resolución de fallos, mejorando así la precisión de la búsqueda.
La asignación de identificadores únicos y la vinculación con la fuente original son esenciales para la trazabilidad y la actualización. Cuando un documento se modifica, el sistema debe poder identificar qué fragmentos específicos han cambiado para reindexar solo esa parte, en lugar de procesar el documento completo. Esta granularidad en el mantenimiento reduce significativamente los costes computacionales y garantiza que la base de datos vectorial refleje siempre la versión más reciente del contenido, evitando respuestas basadas en información obsoleta.
Etapas del pipeline de fragmentación
Secuencia de operaciones para transformar un documento en unidades recuperables.
- 01Preparación: Extracción de texto y estructura (títulos, tablas, metadatos).
- 02Estrategia: Selección del método de división (fijo, semántico, jerárquico).
- 03Generación: Creación de chunks con identificadores y metadatos.
- 04Indexación: Almacenamiento en bases de datos vectoriales o de búsqueda.
- 05Recuperación: Selección de chunks relevantes ante una consulta.
Estrategias principales de fragmentación
No existe una única forma correcta de fragmentar un documento. La elección de la estrategia depende del tipo de contenido, la complejidad de las consultas esperadas y los recursos computacionales disponibles. Las estrategias más comunes incluyen la fragmentación por longitud fija, que es sencilla pero puede cortar ideas a la mitad; la fragmentación por estructura, que respeta encabezados y párrafos; y la fragmentación semántica, que detecta cambios de tema para mantener unidas las ideas relacionadas.
La fragmentación semántica y la jerárquica son particularmente útiles para documentos complejos. La semántica utiliza modelos de lenguaje o embeddings para identificar dónde cambia el significado, evitando divisiones arbitrarias. La fragmentación jerárquica, por su parte, organiza el contenido en niveles (documento, sección, párrafo), permitiendo recuperar una unidad pequeña para la precisión de la búsqueda y utilizar su sección superior para proporcionar contexto amplio al modelo generativo.
La elección entre una estrategia semántica y una jerárquica no es binaria, sino que a menudo requiere una combinación de ambas para abordar la complejidad de los documentos modernos. La fragmentación semántica, al depender de modelos de lenguaje para detectar cambios de tema, ofrece una gran flexibilidad ante textos no estructurados o con transiciones suaves. Sin embargo, su coste computacional puede ser prohibitivo para grandes volúmenes de datos, lo que la hace más adecuada para colecciones de documentos de alto valor o de tamaño moderado donde la precisión en la recuperación es prioritaria sobre la velocidad de procesamiento.
Por otro lado, la fragmentación jerárquica introduce una capa de abstracción que permite al sistema de recuperación operar a múltiples niveles de granularidad. Al recuperar un párrafo específico, el sistema puede optar por incluir también el encabezado de la sección o incluso el título del documento como contexto adicional. Esto mitiga el problema de la pérdida de contexto inherente a los fragmentos pequeños, permitiendo que el modelo generativo comprenda no solo el contenido local, sino también su ubicación dentro del marco conceptual más amplio del documento original.
Comparativa de estrategias de chunking
Resumen de ventajas y limitaciones de los métodos más utilizados.
| Estrategia | Ventaja principal | Limitación principal |
|---|---|---|
| Longitud fija | Sencilla de implementar y controlar. | Puede cortar oraciones o ideas completas. |
| Basada en estructura | Conserva el contexto temático de secciones. | Depende de la calidad de la estructura del documento. |
| Semántica | Mantiene unidas ideas relacionadas por significado. | Mayor coste computacional y complejidad. |
| Jerárquica | Equilibra precisión de búsqueda y contexto amplio. | Añade complejidad al pipeline de recuperación. |
Tres ejemplos desarrollados en ámbitos relevantes
En el ámbito de la documentación técnica, la fragmentación basada en encabezados es a menudo la más efectiva. Un manual de software, por ejemplo, se divide por secciones y subsecciones. Esto permite que un fragmento sobre 'Configuración de red' conserve el contexto de la sección 'Redes', evitando que el modelo interprete las instrucciones sin saber a qué sistema se aplican. Si se usara una fragmentación fija, una instrucción crítica podría quedar separada de su preámbulo, generando una respuesta incompleta.
Para contratos legales, la fragmentación debe respetar la estructura de cláusulas. Un contrato se divide por artículos y párrafos legales. Aquí, la precisión es vital: una cláusula de exclusión de responsabilidad debe recuperarse junto con su contexto legal. La fragmentación semántica puede ser útil si el contrato salta de temas, pero la estructura jerárquica suele ser más fiable para mantener la integridad de las obligaciones legales. En este caso, el solapamiento es menos relevante que la integridad de la unidad legal.
En sistemas de atención al cliente con FAQs, la fragmentación puede ser innecesaria si las entradas ya son cortas y autocontenidas. Cada pregunta y su respuesta forman un chunk natural. Forzar una división adicional solo añade ruido. Sin embargo, si las respuestas son extensas, una fragmentación recursiva que respete los párrafos permite recuperar la parte específica de la respuesta que responde a la duda del usuario, sin cargar al modelo con información irrelevante de otras preguntas.
En el contexto de la documentación técnica, la preservación de la estructura jerárquica es vital para mantener la coherencia de las instrucciones. Un manual de software suele seguir una lógica de dependencia donde una configuración depende de otra. Si la fragmentación rompe estas dependencias al dividir el texto por longitud fija, el modelo puede generar respuestas que omiten pasos previos necesarios. La fragmentación basada en encabezados asegura que cada chunk contenga la información suficiente para ser autoexplicativo, reduciendo la necesidad de que el modelo infiera contexto ausente y minimizando el riesgo de alucinaciones o errores de procedimiento.
En el caso de los contratos legales, la integridad de la unidad legal es el criterio rector. A diferencia de la documentación técnica, donde la fluidez narrativa es importante, en el ámbito legal cada cláusula tiene un alcance y una interpretación específica. La fragmentación debe garantizar que las excepciones, las definiciones y las condiciones estén siempre asociadas a la cláusula principal a la que se refieren. Una fragmentación que separe una definición de su uso o una condición de su obligación puede llevar a interpretaciones erróneas, por lo que la estructura jerárquica basada en artículos y párrafos es la estrategia más robusta para este tipo de contenido.
Cómo evaluar el resultado y errores habituales
La evaluación de una estrategia de fragmentación no debe basarse en la intuición, sino en métricas de recuperación y calidad de respuesta. Es necesario medir si los fragmentos relevantes aparecen entre los primeros resultados (Recall@k), si contienen toda la información necesaria para responder (cobertura de evidencia) y si el sistema genera respuestas fieles a las fuentes. También deben considerarse la latencia, el coste de almacenamiento y la facilidad de mantenimiento cuando los documentos se actualizan.
Un error frecuente es asumir que existe un tamaño de fragmento universal óptimo. En realidad, el tamaño adecuado depende del tipo de documento y de las consultas. Otro error común es ignorar el solapamiento (overlap) o usarlo de forma excesiva. Un solapamiento moderado puede ayudar a conservar información que atraviesa los límites entre fragmentos, pero un exceso genera redundancia y puede confundir al modelo. Finalmente, tratar tablas y datos estructurados como texto corrido puede alterar las relaciones entre valores y etiquetas, lo que requiere estrategias específicas de preprocesamiento.
La evaluación mediante métricas como Recall@k y la cobertura de evidencia permite cuantificar el impacto de la estrategia de fragmentación de manera objetiva. Sin embargo, estas métricas deben interpretarse en conjunto con la calidad de la respuesta generada. Es posible que un sistema tenga un alto Recall@k, recuperando muchos fragmentos relevantes, pero que el modelo generativo no sea capaz de sintetizarlos en una respuesta coherente debido a la falta de contexto o a la presencia de ruido. Por lo tanto, la evaluación debe incluir pruebas de extremo a extremo que midan la utilidad final de la respuesta para el usuario, no solo la eficiencia de la recuperación.
El manejo del solapamiento (overlap) requiere un equilibrio delicado que debe ser validado empíricamente. Un solapamiento insuficiente puede resultar en la pérdida de información crítica en los bordes de los fragmentos, mientras que un solapamiento excesivo aumenta la redundancia y puede saturar la ventana de contexto del modelo con información repetida. La optimización de este parámetro debe realizarse mediante pruebas A/B con conjuntos de consultas representativos, ajustando el porcentaje de solapamiento hasta encontrar el punto donde la mejora en la recuperación supera el coste en términos de almacenamiento y latencia de procesamiento.