Definizione in una frase
Divisione di documenti in unità recuperabili che conservano sufficiente contesto per rispondere alle domande.
Definizione e concetti da non confondere
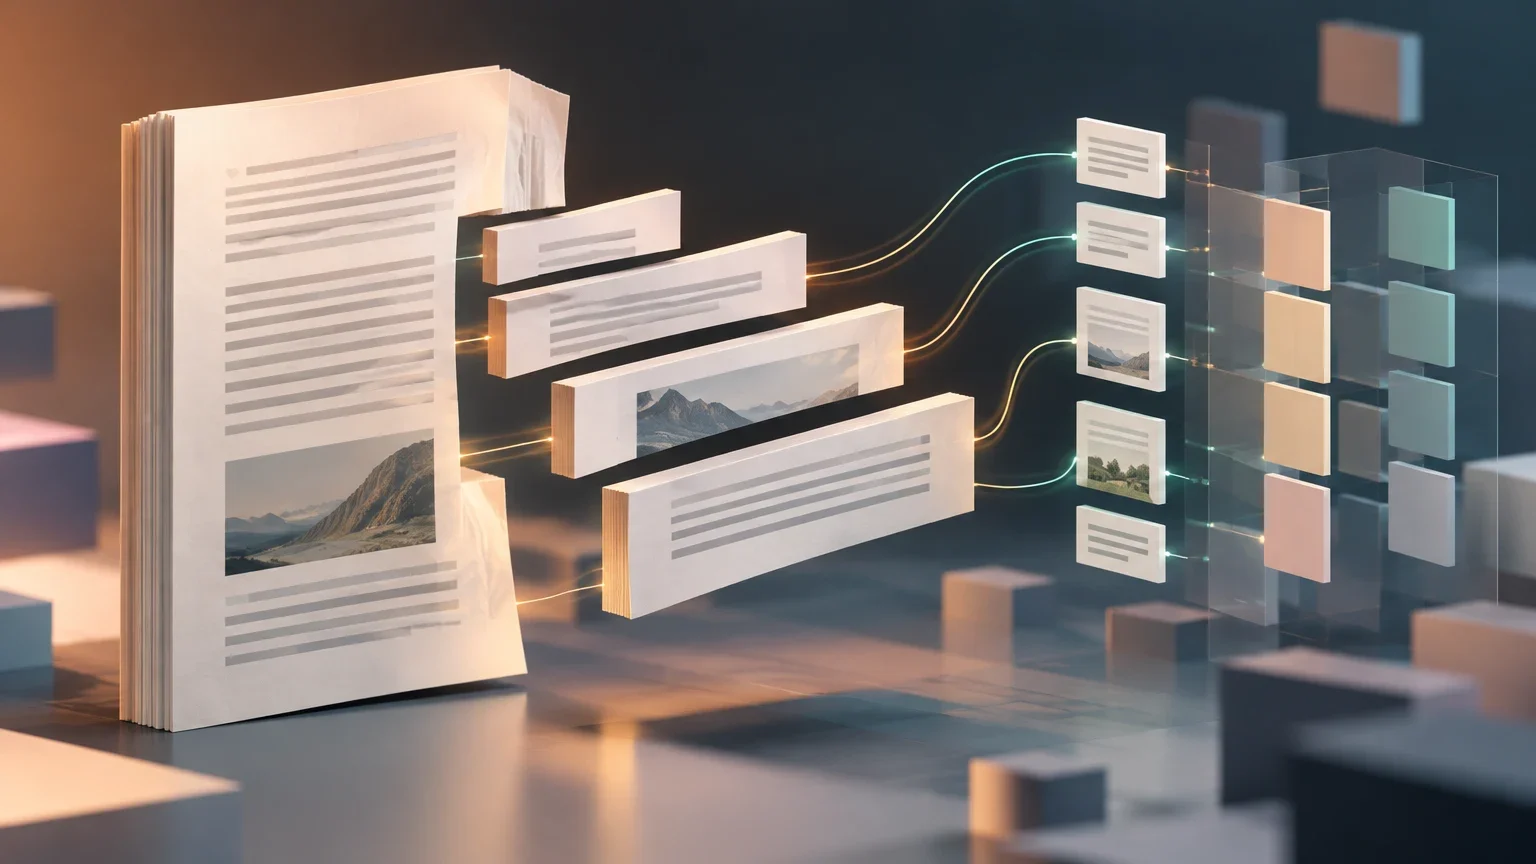
La frammentazione dei documenti, nota tecnicamente come chunking, è il processo di divisione di un documento o di una fonte di informazione in unità più piccole, denominate frammenti o chunk. L'obiettivo è facilitare lo stoccaggio, l'elaborazione e il recupero delle informazioni nei sistemi di intelligenza artificiale, in particolare nelle architetture di Generazione Aumentata dal Recupero (RAG). In questi sistemi, anziché elaborare documenti completi, vengono recuperati frammenti specifici che forniscono il contesto necessario per generare una risposta coerente.
È fondamentale distinguere la frammentazione da altri processi correlati. La frammentazione crea le unità di contenuto; l'indicizzazione organizza queste informazioni per renderle localizzabili; e il recupero dei passaggi determina quali di queste unità sono pertinenti per una specifica query. Confondere queste fasi può portare a ottimizzare la dimensione dei frammenti senza migliorare la qualità della risposta finale, poiché il recupero dipende anche dall'algoritmo di ricerca, dalla qualità degli embedding e dalla formulazione della query.
La distinzione tra frammentazione e indicizzazione è cruciale per comprendere dove si origina la perdita di contesto. Mentre la frammentazione determina la granularità delle unità informative, l'indicizzazione trasforma queste unità in rappresentazioni matematiche, come gli embedding vettoriali, che ne catturano il significato semantico. Se la frammentazione è troppo fine, gli embedding potrebbero perdere le connessioni logiche tra concetti adiacenti; se è troppo grossolana, l'embedding potrebbe diventare ambiguo, mescolando argomenti distinti. Pertanto, la qualità del recupero finale è il prodotto combinato di una segmentazione accurata e di una rappresentazione vettoriale fedele, rendendo inutile ottimizzare uno dei due aspetti a scapito dell'altro.
Differenze tra i concetti chiave
Tabella che distingue la funzione di ogni processo nel pipeline di recupero.
| Concetto | Funzione principale |
|---|---|
| Frammentazione (Chunking) | Divide il contenuto in unità più piccole. |
| Indicizzazione | Organizza le informazioni per la localizzazione. |
| Recupero dei passaggi | Trova frammenti pertinenti per una query. |
| RAG | Utilizza le informazioni recuperate per generare risposte. |
Funzionamento passo dopo passo
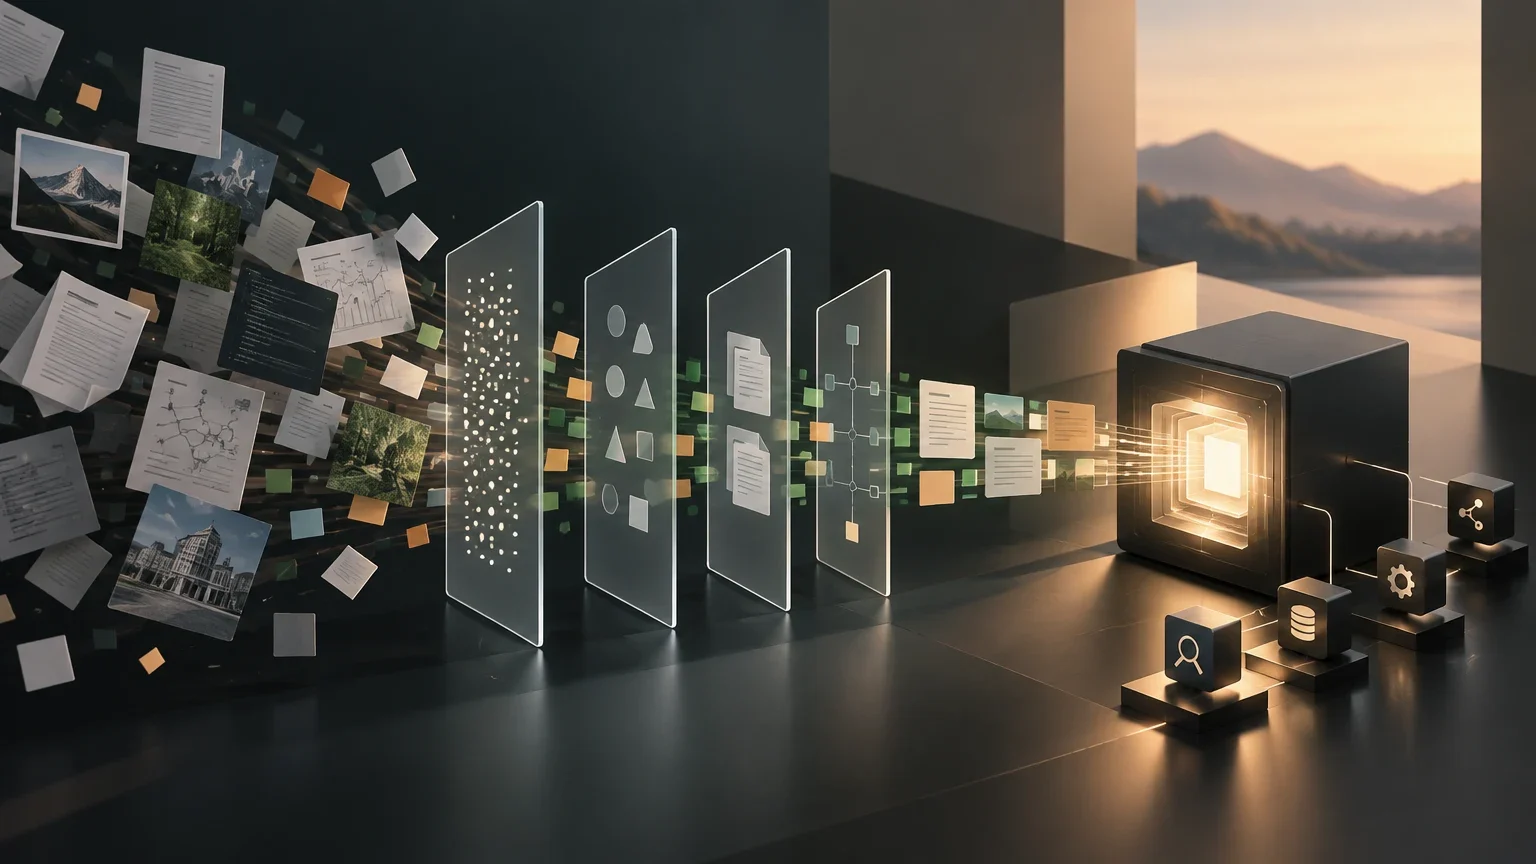
Il processo di frammentazione segue generalmente una sequenza logica che inizia con la preparazione del contenuto. Prima di dividere il testo, il sistema estrae la struttura originale, inclusi titoli, paragrafi, tabelle e metadati. La qualità di questa estrazione è critica: se si perde la gerarchia del documento, i frammenti risultanti potrebbero mancare del contesto necessario per essere interpretati correttamente.
Successivamente, viene selezionata una strategia di frammentazione che determina come verrà tagliato il testo. Questa decisione influisce direttamente sulla lunghezza dei frammenti e su quali informazioni vengono mantenute unite. Una volta definite le regole, vengono generati i frammenti, a cui vengono assegnati identificatori e metadati come l'URL di origine o la posizione all'interno del documento. Infine, questi frammenti vengono indicizzati, spesso mediante la creazione di embedding vettoriali, per essere pronti per il recupero quando arriva una query dell'utente.
La fase di preparazione del contenuto richiede un'attenzione particolare alla gestione dei metadati, che fungono da ancoraggio per il recupero successivo. Assegnare identificatori univoci e informazioni di provenienza, come la posizione gerarchica o l'URL di origine, permette non solo di tracciare l'origine di ogni frammento, ma anche di applicare filtri contestuali durante la ricerca. Ad esempio, in un sistema che gestisce documenti multilingue o di versioni diverse, i metadati consentono di restringere il campo di ricerca a un sottoinsieme specifico, migliorando la precisione senza dover aumentare la complessità dell'algoritmo di similarità vettoriale.
Fasi del pipeline di frammentazione
Sequenza di operazioni per trasformare un documento in unità recuperabili.
- 01Preparazione: Estrazione di testo e struttura (titoli, tabelle, metadati).
- 02Strategia: Selezione del metodo di divisione (fisso, semantico, gerarchico).
- 03Generazione: Creazione di chunk con identificatori e metadati.
- 04Indicizzazione: Stoccaggio in database vettoriali o di ricerca.
- 05Recupero: Selezione di chunk rilevanti in risposta a una query.
Principali strategie di frammentazione
Non esiste un unico modo corretto per frammentare un documento. La scelta della strategia dipende dal tipo di contenuto, dalla complessità delle query attese e dalle risorse computazionali disponibili. Le strategie più comuni includono la frammentazione per lunghezza fissa, che è semplice ma può tagliare le idee a metà; la frammentazione per struttura, che rispetta titoli e paragrafi; e la frammentazione semantica, che rileva i cambi di argomento per mantenere unite le idee correlate.
La frammentazione semantica e quella gerarchica sono particolarmente utili per documenti complessi. La semantica utilizza modelli linguistici o embedding per identificare dove cambia il significato, evitando divisioni arbitrarie. La frammentazione gerarchica, d'altra parte, organizza il contenuto in livelli (documento, sezione, paragrafo), permettendo di recuperare un'unità piccola per la precisione della ricerca e di utilizzare la sua sezione superiore per fornire un contesto ampio al modello generativo.
La scelta tra frammentazione semantica e gerarchica spesso dipende dalla natura delle transizioni nel testo. La frammentazione semantica eccelle quando il documento presenta salti tematici improvvisi, poiché si basa sulla variazione del significato vettoriale per identificare i punti di taglio. Al contrario, la frammentazione gerarchica è preferibile quando la struttura logica è esplicita e rigida, come nei manuali o nei contratti, dove i confini sono definiti da convenzioni formali piuttosto che da flussi di pensiero. In molti casi, un approccio ibrido che combina la struttura gerarchica con una suddivisione semantica all'interno delle sezioni può offrire il miglior equilibrio tra coerenza strutturale e adattamento al contenuto.
Confronto delle strategie di chunking
Riepilogo dei vantaggi e dei limiti dei metodi più utilizzati.
| Strategia | Vantaggio principale | Limite principale |
|---|---|---|
| Lunghezza fissa | Semplice da implementare e controllare. | Può tagliare frasi o idee complete. |
| Basata sulla struttura | Conserva il contesto tematico delle sezioni. | Dipende dalla qualità della struttura del documento. |
| Semantica | Mantiene unite le idee correlate per significato. | Maggiore costo computazionale e complessità. |
| Gerarchica | Bilancia precisione della ricerca e contesto ampio. | Aggiunge complessità al pipeline di recupero. |
Tre esempi sviluppati in ambiti rilevanti
Nel campo della documentazione tecnica, la frammentazione basata sui titoli è spesso la più efficace. Un manuale di software, ad esempio, viene diviso per sezioni e sottosezioni. Questo permette a un frammento su 'Configurazione di rete' di conservare il contesto della sezione 'Reti', evitando che il modello interpreti le istruzioni senza sapere a quale sistema si applicano. Se si utilizzasse una frammentazione fissa, un'istruzione critica potrebbe rimanere separata dal suo preambolo, generando una risposta incompleta.
Per i contratti legali, la frammentazione deve rispettare la struttura delle clausole. Un contratto viene diviso per articoli e paragrafi legali. Qui, la precisione è vitale: una clausola di esclusione di responsabilità deve essere recuperata insieme al suo contesto legale. La frammentazione semantica può essere utile se il contratto cambia argomento, ma la struttura gerarchica è solitamente più affidabile per mantenere l'integrità delle obbligazioni legali. In questo caso, la sovrapposizione è meno rilevante dell'integrità dell'unità legale.
Nei sistemi di assistenza clienti con FAQ, la frammentazione può essere inutile se le voci sono già brevi e autocontenute. Ogni domanda e la sua risposta formano un chunk naturale. Forzare una divisione aggiuntiva aggiunge solo rumore. Tuttavia, se le risposte sono estese, una frammentazione ricorsiva che rispetti i paragrafi permette di recuperare la parte specifica della risposta che risponde al dubbio dell'utente, senza caricare il modello con informazioni irrilevanti di altre domande.
Nei sistemi di assistenza clienti, la gestione delle FAQ estese richiede un bilanciamento tra la completezza della risposta e la rilevanza del frammento recuperato. Una frammentazione ricorsiva che rispetti i paragrafi permette di isolare la porzione di testo che risponde direttamente alla domanda specifica dell'utente, evitando di sovraccaricare il modello generativo con dettagli superflui provenienti da altre sezioni della stessa risposta. Questo approccio riduce il rischio di allucinazioni, poiché il modello si concentra su un contesto più ristretto e pertinente, migliorando la fedeltà della risposta finale rispetto alla fonte originale.
Come valutare il risultato e errori comuni
La valutazione di una strategia di frammentazione non deve basarsi sull'intuizione, ma su metriche di recupero e qualità della risposta. È necessario misurare se i frammenti rilevanti appaiono tra i primi risultati (Recall@k), se contengono tutte le informazioni necessarie per rispondere (copertura delle prove) e se il sistema genera risposte fedeli alle fonti. Devono essere considerati anche la latenza, il costo di stoccaggio e la facilità di manutenzione quando i documenti vengono aggiornati.
Un errore frequente è assumere che esista una dimensione universale ottimale per i frammenti. In realtà, la dimensione adeguata dipende dal tipo di documento e dalle query. Un altro errore comune è ignorare la sovrapposizione (overlap) o usarla in modo eccessivo. Una sovrapposizione moderata può aiutare a conservare informazioni che attraversano i limiti tra i frammenti, ma un eccesso genera ridondanza e può confondere il modello. Infine, trattare tabelle e dati strutturati come testo continuo può alterare le relazioni tra valori ed etichette, richiedendo strategie specifiche di pre-elaborazione.
La valutazione della sovrapposizione (overlap) deve essere condotta attraverso test empirici che misurino l'impatto sulla ridondanza e sulla copertura delle informazioni. Un tasso di sovrapposizione troppo elevato può saturare il database vettoriale con duplicati, aumentando i costi di stoccaggio e il tempo di ricerca, mentre un tasso troppo basso può lasciare zone cieche ai confini dei frammenti. La strategia ottimale richiede quindi un'analisi iterativa, in cui si varia il parametro di sovrapposizione e si osserva come cambiano le metriche di recupero e la qualità percepita delle risposte, adattando la configurazione alle specifiche esigenze del dominio applicativo.