Définition en une phrase
Division des documents en unités récupérables qui conservent suffisamment de contexte pour répondre aux questions.
Définition et concepts à ne pas confondre
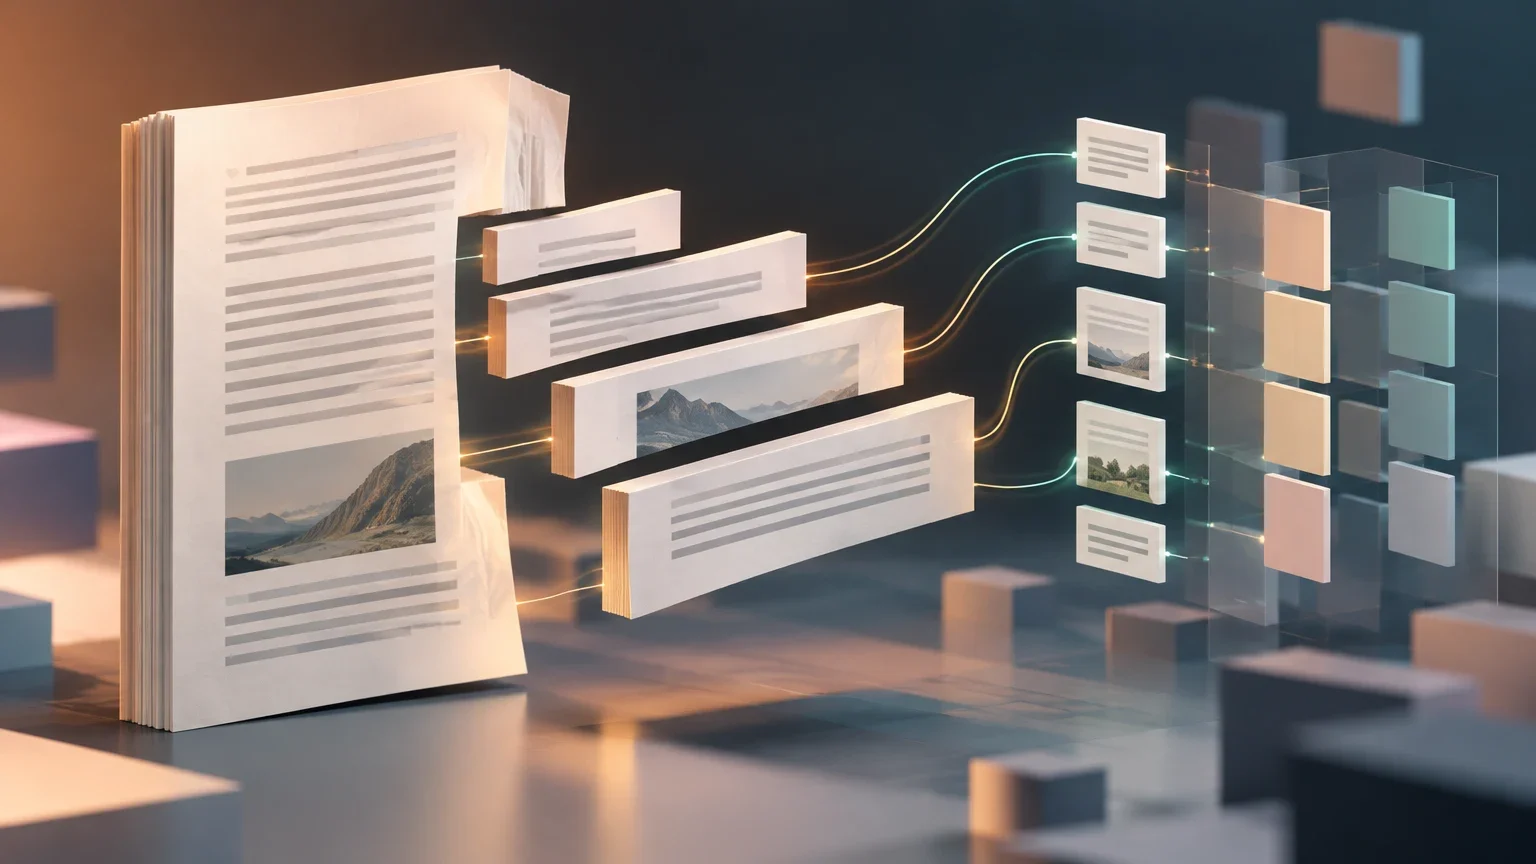
Le découpage de documents, techniquement appelé chunking, est le processus de division d'un document ou d'une source d'information en unités plus petites, appelées fragments ou chunks. L'objectif est de faciliter le stockage, le traitement et la récupération de l'information dans les systèmes d'intelligence artificielle, en particulier dans les architectures de Récupération Augmentée par Génération (RAG). Dans ces systèmes, au lieu de traiter des documents complets, on récupère des fragments spécifiques qui apportent le contexte nécessaire pour générer une réponse cohérente.
Il est fondamental de distinguer le découpage d'autres processus liés. Le découpage crée les unités de contenu ; l'indexation organise cette information pour qu'elle soit localisable ; et la récupération de passages détermine lesquelles de ces unités sont pertinentes pour une requête donnée. Confondre ces étapes peut conduire à optimiser la taille des fragments sans améliorer la qualité de la réponse finale, car la récupération dépend également de l'algorithme de recherche, de la qualité des embeddings et de la formulation de la requête.
Différences entre les concepts clés
Tableau distinguant la fonction de chaque processus dans le pipeline de récupération.
| Concept | Fonction principale |
|---|---|
| Découpage (Chunking) | Divise le contenu en unités plus petites. |
| Indexation | Organise l'information pour sa localisation. |
| Récupération de passages | Trouve des fragments pertinents pour une requête. |
| RAG | Utilise l'information récupérée pour générer des réponses. |
Fonctionnement étape par étape
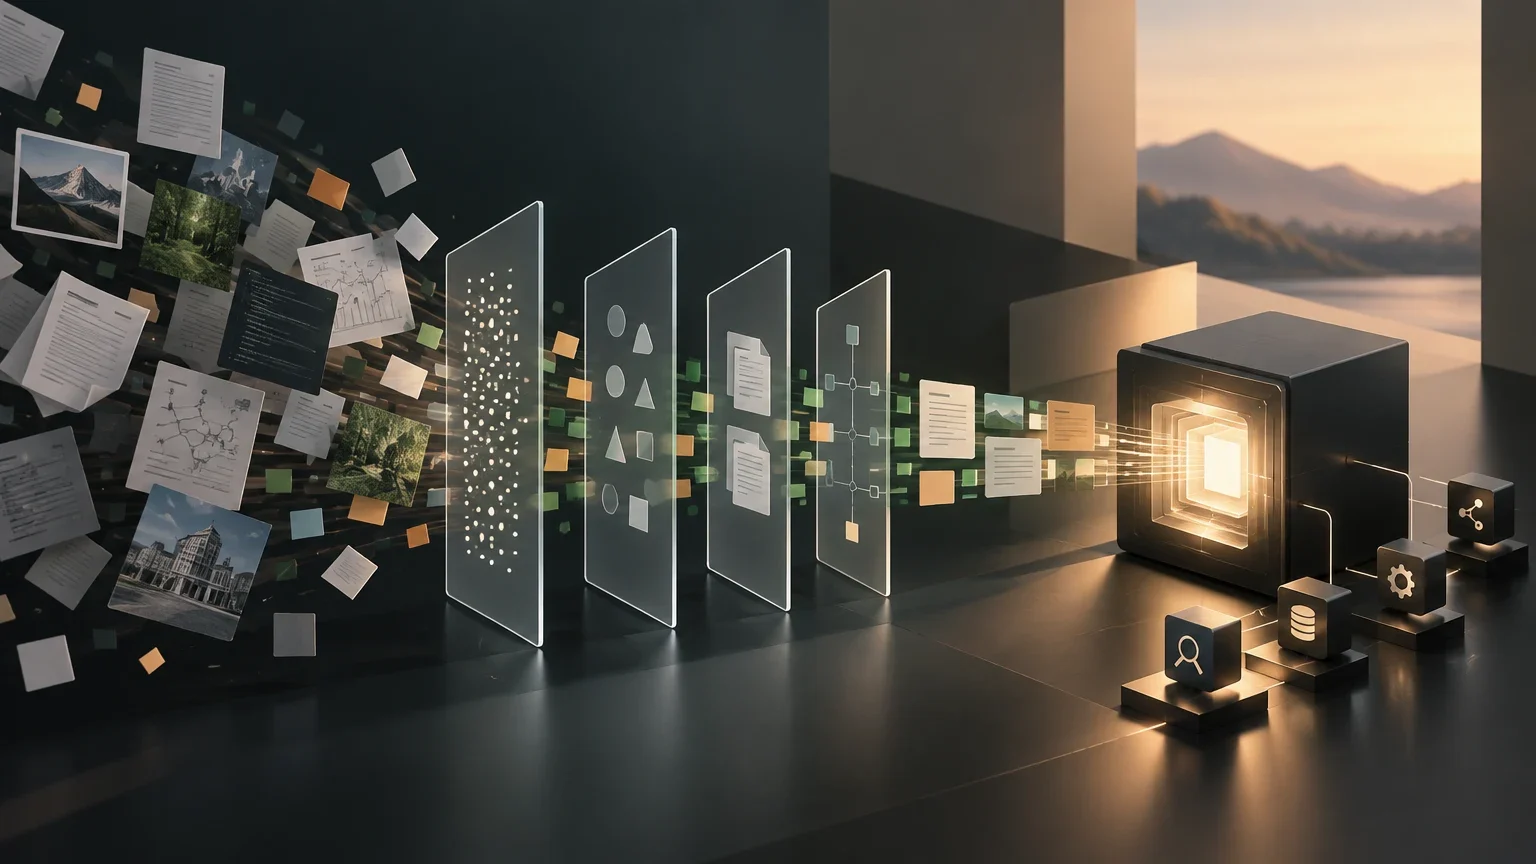
Le processus de découpage suit habituellement une séquence logique qui commence par la préparation du contenu. Avant de diviser le texte, le système extrait la structure originale, y compris les titres, les paragraphes, les tableaux et les métadonnées. La qualité de cette extraction est critique : si la hiérarchie du document est perdue, les fragments résultants peuvent manquer du contexte nécessaire pour être interprétés correctement.
Ensuite, une stratégie de découpage est sélectionnée, déterminant comment le texte sera coupé. Cette décision influence directement la longueur des fragments et quelles informations restent groupées. Une fois les règles définies, les fragments sont générés, auxquels sont attribués des identifiants et des métadonnées telles que l'URL d'origine ou la position dans le document. Enfin, ces fragments sont indexés, souvent par la création d'embeddings vectoriels, pour être prêts à la récupération lorsqu'une requête utilisateur arrive.
Étapes du pipeline de découpage
Séquence d'opérations pour transformer un document en unités récupérables.
- 01Préparation : Extraction du texte et de la structure (titres, tableaux, métadonnées).
- 02Stratégie : Sélection de la méthode de division (fixe, sémantique, hiérarchique).
- 03Génération : Création de chunks avec identifiants et métadonnées.
- 04Indexation : Stockage dans des bases de données vectorielles ou de recherche.
- 05Récupération : Sélection des chunks pertinents face à une requête.
Stratégies principales de découpage
Il n'existe pas une seule façon correcte de découper un document. Le choix de la stratégie dépend du type de contenu, de la complexité des requêtes attendues et des ressources computationnelles disponibles. Les stratégies les plus courantes incluent le découpage par longueur fixe, simple mais susceptible de couper des idées en deux ; le découpage par structure, qui respecte les en-têtes et les paragraphes ; et le découpage sémantique, qui détecte les changements de sujet pour maintenir les idées liées ensemble.
Le découpage sémantique et hiérarchique sont particulièrement utiles pour les documents complexes. Le sémantique utilise des modèles de langage ou des embeddings pour identifier où le sens change, évitant les divisions arbitraires. Le découpage hiérarchique, quant à lui, organise le contenu en niveaux (document, section, paragraphe), permettant de récupérer une unité petite pour la précision de la recherche et d'utiliser sa section supérieure pour fournir un contexte large au modèle génératif.
Comparatif des stratégies de chunking
Résumé des avantages et des limites des méthodes les plus utilisées.
| Stratégie | Avantage principal | Limite principale |
|---|---|---|
| Longueur fixe | Simple à implémenter et à contrôler. | Peut couper des phrases ou des idées complètes. |
| Basée sur la structure | Conserve le contexte thématique des sections. | Dépend de la qualité de la structure du document. |
| Sémantique | Maintient les idées liées ensemble par le sens. | Coût computationnel et complexité plus élevés. |
| Hiérarchique | Équilibre précision de recherche et contexte large. | Ajoute de la complexité au pipeline de récupération. |
Trois exemples développés dans des domaines pertinents
Dans le domaine de la documentation technique, le découpage basé sur les en-têtes est souvent le plus efficace. Un manuel de logiciel, par exemple, est divisé par sections et sous-sections. Cela permet à un fragment sur la 'Configuration réseau' de conserver le contexte de la section 'Réseaux', empêchant le modèle d'interpréter les instructions sans savoir à quel système elles s'appliquent. Si un découpage fixe était utilisé, une instruction critique pourrait être séparée de son préambule, générant une réponse incomplète.
Pour les contrats juridiques, le découpage doit respecter la structure des clauses. Un contrat est divisé par articles et paragraphes juridiques. Ici, la précision est vitale : une clause d'exclusion de responsabilité doit être récupérée avec son contexte juridique. Le découpage sémantique peut être utile si le contrat change de sujet, mais la structure hiérarchique est généralement plus fiable pour maintenir l'intégrité des obligations légales. Dans ce cas, le chevauchement est moins pertinent que l'intégrité de l'unité légale.
Dans les systèmes d'assistance client avec des FAQ, le découpage peut être inutile si les entrées sont déjà courtes et auto-contenues. Chaque question et sa réponse forment un chunk naturel. Forcer une division supplémentaire n'ajoute que du bruit. Cependant, si les réponses sont étendues, un découpage récursif respectant les paragraphes permet de récupérer la partie spécifique de la réponse qui répond à la question de l'utilisateur, sans charger le modèle avec des informations non pertinentes d'autres questions.
Comment évaluer le résultat et erreurs courantes
L'évaluation d'une stratégie de découpage ne doit pas se baser sur l'intuition, mais sur des métriques de récupération et de qualité de réponse. Il est nécessaire de mesurer si les fragments pertinents apparaissent parmi les premiers résultats (Recall@k), s'ils contiennent toutes les informations nécessaires pour répondre (couverture de la preuve) et si le système génère des réponses fidèles aux sources. La latence, le coût de stockage et la facilité de maintenance lors des mises à jour des documents doivent également être pris en compte.
Une erreur fréquente est de supposer qu'il existe une taille de fragment universellement optimale. En réalité, la taille appropriée dépend du type de document et des requêtes. Une autre erreur commune est d'ignorer le chevauchement (overlap) ou de l'utiliser de manière excessive. Un chevauchement modéré peut aider à conserver des informations qui traversent les limites entre les fragments, mais un excès génère de la redondance et peut confondre le modèle. Enfin, traiter les tableaux et les données structurées comme du texte continu peut altérer les relations entre les valeurs et les étiquettes, ce qui nécessite des stratégies de prétraitement spécifiques.