Definição numa frase
Divisão de documentos em unidades recuperáveis que conservam contexto suficiente para responder perguntas.
Definição e conceitos que não devem ser confundidos
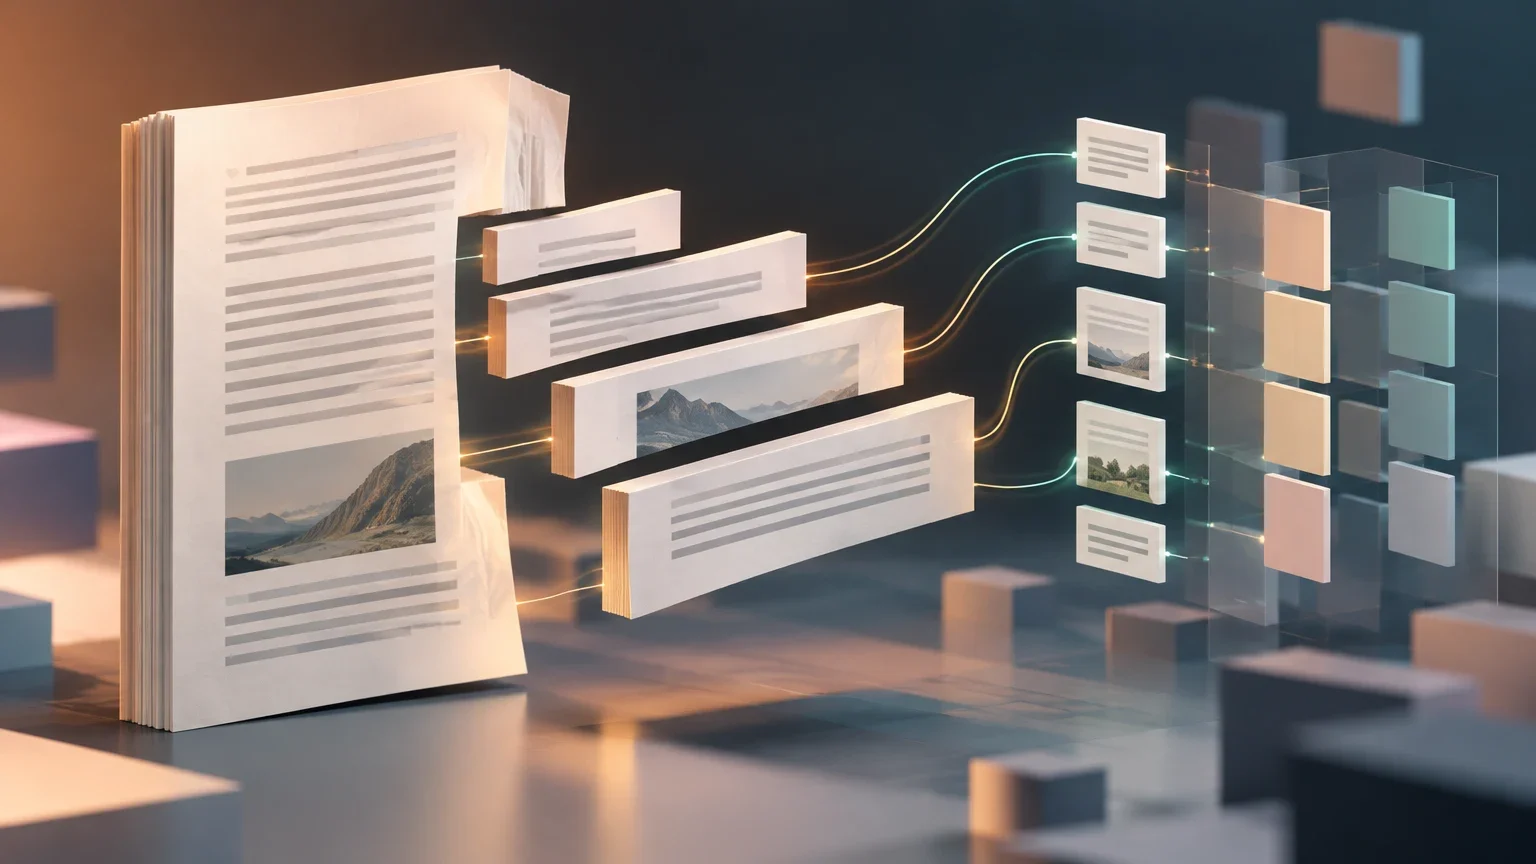
A fragmentação de documentos, conhecida tecnicamente como chunking, é o processo de dividir um documento ou fonte de informação em unidades menores, denominadas fragmentos ou chunks. O objetivo é facilitar o armazenamento, o processamento e a recuperação da informação em sistemas de inteligência artificial, especialmente em arquiteturas de Recuperação Aumentada por Geração (RAG). Nesses sistemas, em vez de processar documentos completos, recuperam-se fragmentos específicos que fornecem o contexto necessário para gerar uma resposta coerente.
É fundamental distinguir a fragmentação de outros processos relacionados. A fragmentação cria as unidades de conteúdo; a indexação organiza essa informação para que seja localizável; e a recuperação de trechos determina quais dessas unidades são pertinentes para uma consulta específica. Confundir essas etapas pode levar a otimizar o tamanho dos fragmentos sem melhorar a qualidade da resposta final, já que a recuperação depende também do algoritmo de busca, da qualidade dos embeddings e da formulação da consulta.
Diferenças entre conceitos-chave
Tabela que distingue a função de cada processo no pipeline de recuperação.
| Conceito | Função principal |
|---|---|
| Fragmentação (Chunking) | Divide o conteúdo em unidades menores. |
| Indexação | Organiza a informação para sua localização. |
| Recuperação de trechos | Encontra fragmentos pertinentes para uma consulta. |
| RAG | Utiliza informação recuperada para gerar respostas. |
Funcionamento passo a passo
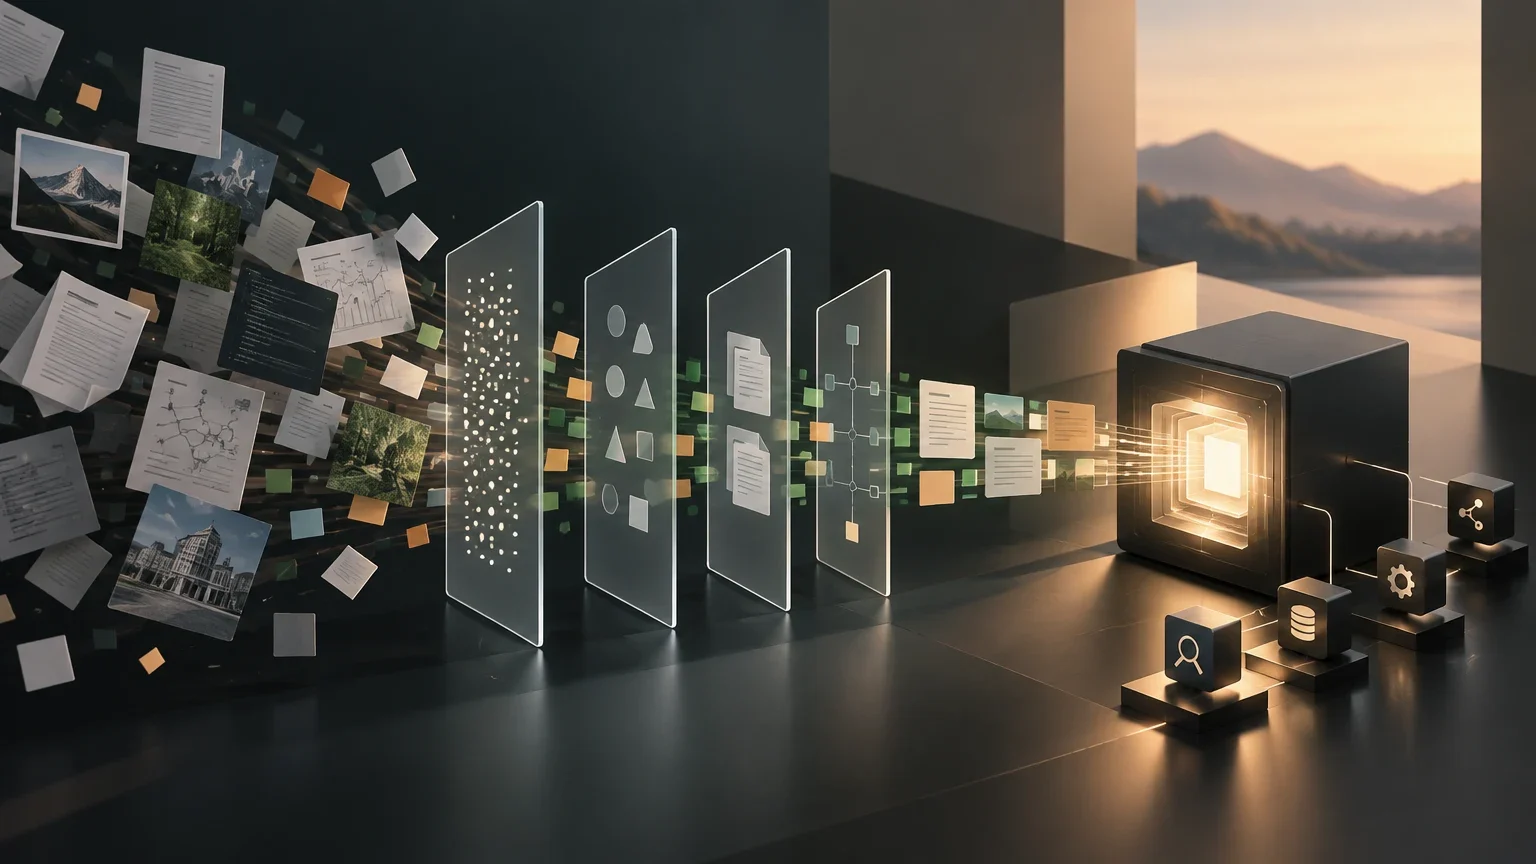
O processo de fragmentação habitualmente segue uma sequência lógica que começa com a preparação do conteúdo. Antes de dividir o texto, o sistema extrai a estrutura original, incluindo títulos, parágrafos, tabelas e metadados. A qualidade dessa extração é crítica: se a hierarquia do documento for perdida, os fragmentos resultantes podem carecer do contexto necessário para serem interpretados corretamente.
Em seguida, seleciona-se uma estratégia de fragmentação que determina como o texto será cortado. Essa decisão influencia diretamente o comprimento dos fragmentos e em que informação se mantém unida. Uma vez definidas as regras, geram-se os fragmentos, aos quais são atribuídos identificadores e metadados como a URL de origem ou a posição dentro do documento. Finalmente, esses fragmentos são indexados, muitas vezes mediante a criação de embeddings vetoriais, para estarem prontos para a recuperação quando chegar uma consulta do usuário.
Etapas do pipeline de fragmentação
Sequência de operações para transformar um documento em unidades recuperáveis.
- 01Preparação: Extração de texto e estrutura (títulos, tabelas, metadados).
- 02Estratégia: Seleção do método de divisão (fixo, semântico, hierárquico).
- 03Geração: Criação de chunks com identificadores e metadados.
- 04Indexação: Armazenamento em bases de dados vetoriais ou de busca.
- 05Recuperação: Seleção de chunks relevantes diante de uma consulta.
Principais estratégias de fragmentação
Não existe uma única forma correta de fragmentar um documento. A escolha da estratégia depende do tipo de conteúdo, da complexidade das consultas esperadas e dos recursos computacionais disponíveis. As estratégias mais comuns incluem a fragmentação por comprimento fixo, que é simples mas pode cortar ideias ao meio; a fragmentação por estrutura, que respeita cabeçalhos e parágrafos; e a fragmentação semântica, que detecta mudanças de tema para manter unidas as ideias relacionadas.
A fragmentação semântica e a hierárquica são particularmente úteis para documentos complexos. A semântica utiliza modelos de linguagem ou embeddings para identificar onde o significado muda, evitando divisões arbitrárias. A fragmentação hierárquica, por sua vez, organiza o conteúdo em níveis (documento, seção, parágrafo), permitindo recuperar uma unidade pequena para a precisão da busca e utilizar sua seção superior para fornecer contexto amplo ao modelo generativo.
Comparativo de estratégias de chunking
Resumo de vantagens e limitações dos métodos mais utilizados.
| Estratégia | Vantagem principal | Limitação principal |
|---|---|---|
| Comprimento fixo | Simples de implementar e controlar. | Pode cortar frases ou ideias completas. |
| Baseada em estrutura | Preserva o contexto temático das seções. | Depende da qualidade da estrutura do documento. |
| Semântica | Mantém unidas ideias relacionadas por significado. | Maior custo computacional e complexidade. |
| Hierárquica | Equilibra precisão de busca e contexto amplo. | Adiciona complexidade ao pipeline de recuperação. |
Três exemplos desenvolvidos em âmbitos relevantes
No âmbito da documentação técnica, a fragmentação baseada em cabeçalhos é frequentemente a mais eficaz. Um manual de software, por exemplo, divide-se por seções e subseções. Isso permite que um fragmento sobre 'Configuração de rede' preserve o contexto da seção 'Redes', evitando que o modelo interprete as instruções sem saber a qual sistema se aplicam. Se fosse usada uma fragmentação fixa, uma instrução crítica poderia ficar separada de seu preâmbulo, gerando uma resposta incompleta.
Para contratos legais, a fragmentação deve respeitar a estrutura de cláusulas. Um contrato divide-se por artigos e parágrafos legais. Aqui, a precisão é vital: uma cláusula de exclusão de responsabilidade deve ser recuperada junto com seu contexto legal. A fragmentação semântica pode ser útil se o contrato mudar de temas, mas a estrutura hierárquica costuma ser mais confiável para manter a integridade das obrigações legais. Neste caso, a sobreposição é menos relevante do que a integridade da unidade legal.
Em sistemas de atendimento ao cliente com FAQs, a fragmentação pode ser desnecessária se as entradas já forem curtas e autocontidas. Cada pergunta e sua resposta formam um chunk natural. Forçar uma divisão adicional apenas adiciona ruído. No entanto, se as respostas forem extensas, uma fragmentação recursiva que respeite os parágrafos permite recuperar a parte específica da resposta que responde à dúvida do usuário, sem carregar o modelo com informação irrelevante de outras perguntas.
Como avaliar o resultado e erros habituais
A avaliação de uma estratégia de fragmentação não deve basear-se na intuição, mas em métricas de recuperação e qualidade de resposta. É necessário medir se os fragmentos relevantes aparecem entre os primeiros resultados (Recall@k), se contêm toda a informação necessária para responder (cobertura de evidência) e se o sistema gera respostas fiéis às fontes. Também devem ser considerados a latência, o custo de armazenamento e a facilidade de manutenção quando os documentos são atualizados.
Um erro frequente é assumir que existe um tamanho de fragmento universal ótimo. Na realidade, o tamanho adequado depende do tipo de documento e das consultas. Outro erro comum é ignorar a sobreposição (overlap) ou usá-la de forma excessiva. Uma sobreposição moderada pode ajudar a preservar informação que atravessa os limites entre fragmentos, mas um excesso gera redundância e pode confundir o modelo. Finalmente, tratar tabelas e dados estruturados como texto corrido pode alterar as relações entre valores e rótulos, o que requer estratégias específicas de pré-processamento.