O que foi lançado e quando
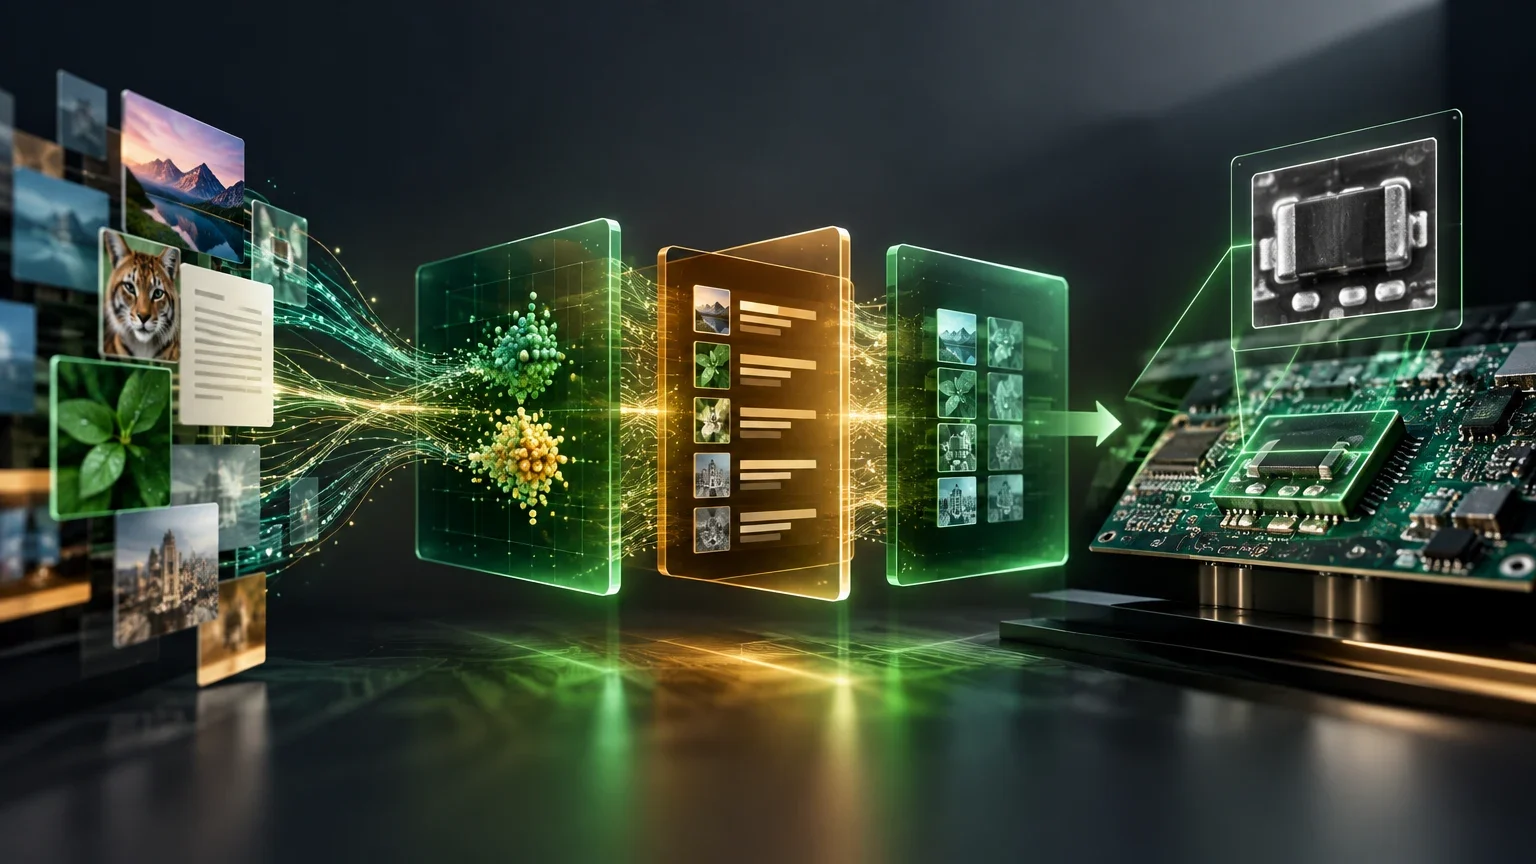
A NVIDIA publicou quatro modelos de inteligência artificial em 20 de outubro de 2026. Estes incluem duas variantes de embeddings (Nemotron 3.5 Embed 8B BF16 e Nemotron 3.5 Embed 1B BF16), um modelo de reranking (Nemotron 3.5 Rerank 8B BF16) e um modelo de edição de imagem específico para a indústria eletrônica (CDF Sim2Real SMT Solderlight).
A publicação foi realizada simultaneamente em repositórios oficiais, confirmando a disponibilidade imediata dos pesos em formato BF16. Não foi anunciada uma data de lançamento diferida nem uma fase beta; os modelos estão prontos para download e implantação pelos usuários finais.
Resumo dos modelos publicados
Lista dos quatro modelos com sua função principal e data de publicação.
| Modelo | Função principal | Data de publicação |
|---|---|---|
| Nemotron 3.5 Rerank 8B BF16 | Reranking multimodal | 20 OUT 2026 |
| Nemotron 3.5 Embed 8B BF16 | Embeddings de texto e imagem | 20 OUT 2026 |
| Nemotron 3.5 Embed 1B BF16 | Embeddings de texto e imagem | 20 OUT 2026 |
| CDF Sim2Real SMT Solderlight | Edição de imagem para PCB | 20 OUT 2026 |
Variantes, modalidades e acesso
Os modelos da família Nemotron 3.5 são multimodais, aceitando tanto texto quanto imagens de página como entrada. O modelo de reranking pontua a relevância de cada par consulta-documento, enquanto os modelos de embeddings geram vetores normalizados (4.096 dimensões para o 8B e 2.048 para o 1B).
O acesso é direto através dos repositórios oficiais. Não existe uma API comercial gerenciada pela NVIDIA para estes modelos específicos, o que implica que o usuário deve gerenciar sua própria infraestrutura de computação. A licença OpenMDW 1.1 permite o uso comercial, sujeita aos seus termos e à conservação dos avisos de copyright.
O que muda para o usuário
Para as equipes de engenharia de software, a principal novidade é a capacidade de processar documentos mistos (texto e imagem) em uma única etapa de recuperação ou reranking. Isso simplifica as arquiteturas de busca que anteriormente exigiam pipelines separados para texto e visão.
O modelo CDF Sim2Real SMT Solderlight é mais específico: foi projetado para transformar recortes sintéticos de componentes de circuitos impressos (PCB) em um estilo de iluminação de inspeção óptica. Não é um decisor de qualidade, mas uma ferramenta de pré-processamento visual que requer um sistema posterior de inspeção e revisão humana.
Preço, limites e o que falta por verificar
Não há tarifas por API publicadas. O custo para o usuário se limita à infraestrutura própria: GPU, memória, armazenamento e operação. Os modelos de 8B parâmetros exigem hardware mais potente que a variante de 1B, que está projetada para ambientes com recursos limitados.
Um limite importante é o contexto de 32.768 tokens compartilhados entre texto e imagem. Além disso, as imagens são processadas com um lado maior de 1.120 pixels por padrão, ampliable para 1.540. Não foram publicados benchmarks numéricos independentes para estes checkpoints específicos, portanto a avaliação de desempenho deve ser realizada pelo usuário em seu próprio contexto.
Especificações técnicas principais
Comparativo de parâmetros, dimensões de saída e limites de contexto.
| Modelo | Parâmetros | Dimensão de saída | Limite de contexto |
|---|---|---|---|
| Nemotron 3.5 Rerank 8B | 8,38B | Logit de relevância | 32.768 tokens |
| Nemotron 3.5 Embed 8B | 8,38B | 4.096 (L2 normalizado) | 32.768 tokens |
| Nemotron 3.5 Embed 1B | 1,55B | 2.048 (L2 normalizado) | 32.768 tokens |
Considerações técnicas e implantação
A implantação requer atenção às dependências de software. Os exemplos oficiais utilizam a versão 5.20.0 do Transformers com Flash Attention 2, enquanto o vLLM 0.32.0 requer um ambiente com uma versão inferior do Transformers. É crucial revisar qualquer código remoto (trust_remote_code) antes de executá-lo em produção.
Para o modelo de imagem CDF Sim2Real SMT Solderlight, o treinamento foi realizado com uma área de 262.144 pixels (512x512). Usar resoluções muito diferentes pode degradar a qualidade da saída. O modelo deriva do Qwen-Image-Edit com um ajuste LoRA fundido, o que significa que é entregue como um pipeline completo, não como um adaptador independente.
Passos para a implantação inicial
Processo recomendado para integrar os modelos em um ambiente de produção.
- 01Verificar a compatibilidade da versão do Transformers e vLLM com o modelo específico.
- 02Baixar os pesos BF16 do repositório oficial.
- 03Configurar o ambiente de GPU com memória suficiente para o tamanho do modelo.
- 04Realizar testes de inferência com dados de amostra para validar a latência e a qualidade.
- 05Implementar mecanismos de revisão humana para os modelos de inspeção de imagem.
Questões em aberto
- Não foram publicados benchmarks numéricos independentes para estes checkpoints específicos; as métricas mencionadas nas fichas oficiais não estão verificadas de forma externa.
- O desempenho real em ambientes de produção pode variar significativamente dependendo do hardware e da configuração do software.
- Não foi verificada a disponibilidade de uma API comercial futura para estes modelos.
Continue a explorar
Fontes consultadas
Correções e transparência
Se encontrar informação incorreta ou desatualizada, envie-nos a página e a fonte que devemos rever.
Propor uma correção