Qué se ha lanzado y cuándo
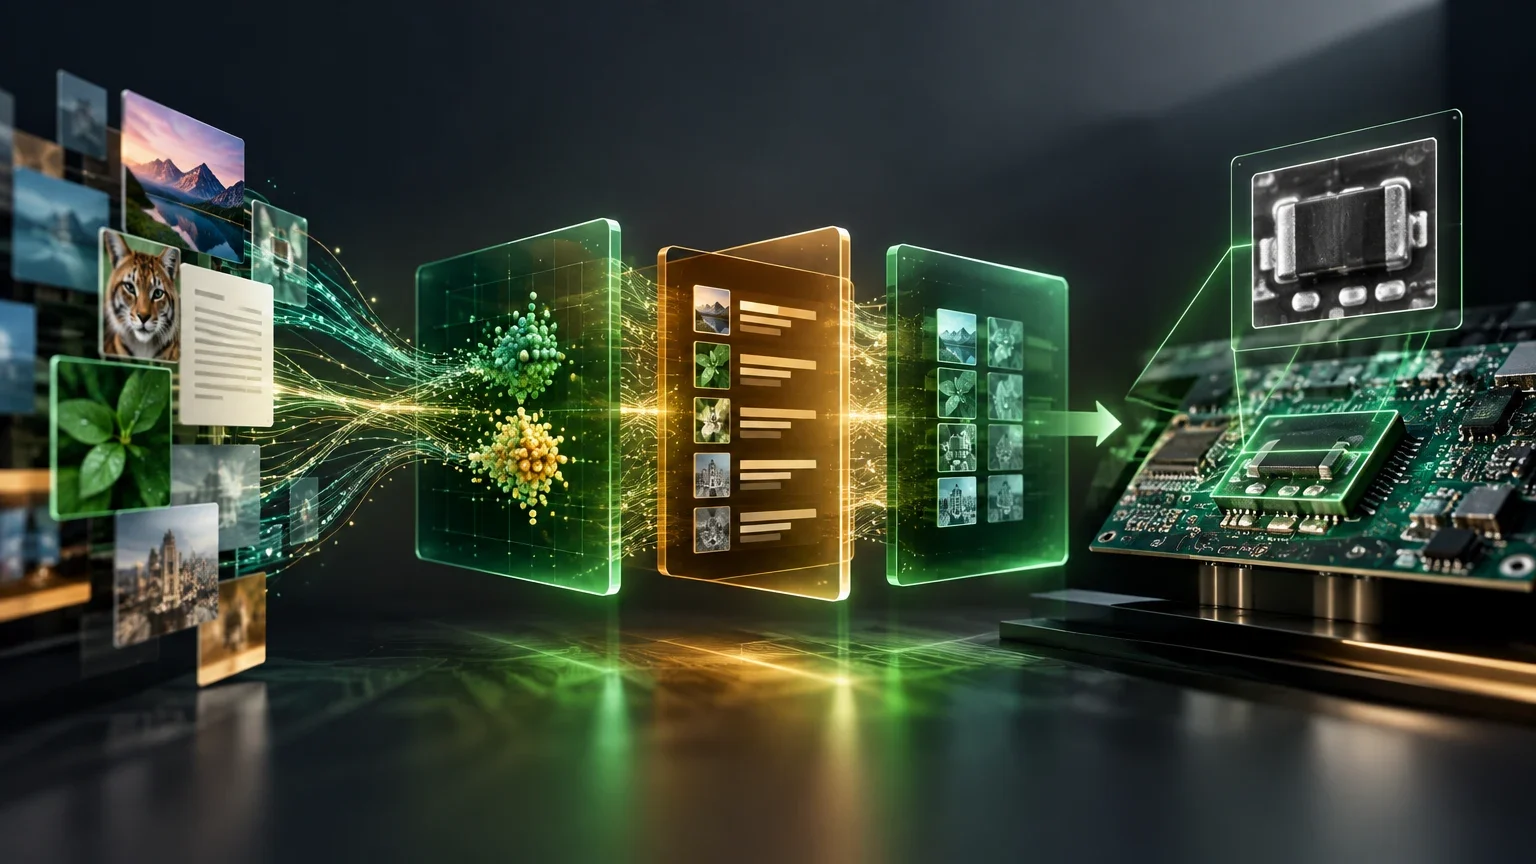
NVIDIA ha publicado cuatro modelos de inteligencia artificial el 20 de octubre de 2026. Estos incluyen dos variantes de embeddings (Nemotron 3.5 Embed 8B BF16 y Nemotron 3.5 Embed 1B BF16), un modelo de reranking (Nemotron 3.5 Rerank 8B BF16) y un modelo de edición de imagen específico para la industria electrónica (CDF Sim2Real SMT Solderlight).
La publicación se ha realizado de forma simultánea en repositorios oficiales, confirmando la disponibilidad inmediata de los pesos en formato BF16. No se ha anunciado una fecha de lanzamiento diferida ni una fase beta; los modelos están listos para su descarga y despliegue por parte de los usuarios finales.
Resumen de modelos publicados
Lista de los cuatro modelos con su función principal y fecha de publicación.
| Modelo | Función principal | Fecha de publicación |
|---|---|---|
| Nemotron 3.5 Rerank 8B BF16 | Reranking multimodal | 20 OCT 2026 |
| Nemotron 3.5 Embed 8B BF16 | Embeddings de texto e imagen | 20 OCT 2026 |
| Nemotron 3.5 Embed 1B BF16 | Embeddings de texto e imagen | 20 OCT 2026 |
| CDF Sim2Real SMT Solderlight | Edición de imagen para PCB | 20 OCT 2026 |
Variantes, modalidades y acceso
Los modelos de la familia Nemotron 3.5 son multimodales, aceptando tanto texto como imágenes de página como entrada. El modelo de reranking puntúa la relevancia de cada par consulta-documento, mientras que los modelos de embeddings generan vectores normalizados (4.096 dimensiones para el 8B y 2.048 para el 1B).
El acceso es directo a través de los repositorios oficiales. No existe una API comercial gestionada por NVIDIA para estos modelos específicos, lo que implica que el usuario debe gestionar su propia infraestructura de cómputo. La licencia OpenMDW 1.1 permite el uso comercial, sujeto a sus términos y a la conservación de los avisos de copyright.
La multimodalidad de la familia Nemotron 3.5 se manifiesta en la capacidad de aceptar entradas heterogéneas, combinando texto e imágenes de página en el mismo proceso de inferencia. Esta característica técnica permite que el modelo procese documentos que no son puramente textuales, como manuales o fichas técnicas que incluyen diagramas, sin necesidad de separar las modalidades en etapas previas de preprocesamiento. El resultado es una representación unificada donde la información visual y textual se trata dentro del mismo flujo de cómputo, facilitando la integración en sistemas de recuperación que manejan formatos diversos.
El modelo de reranking opera evaluando la relevancia de cada par consulta-documento, asignando una puntuación que refleja la pertinencia del contenido recuperado. Por su parte, los modelos de embeddings generan vectores normalizados que sirven como base para la comparación de similitud. La diferencia en la dimensión de salida, 4.096 para la variante de 8B y 2.048 para la de 1B, responde a la capacidad de representación de cada arquitectura, permitiendo a los usuarios elegir el nivel de detalle vectorial adecuado para sus necesidades de indexación y búsqueda.
Qué cambia para el usuario
Para los equipos de ingeniería de software, la principal novedad es la capacidad de procesar documentos mixtos (texto e imagen) en una sola etapa de recuperación o reranking. Esto simplifica las arquitecturas de búsqueda que anteriormente requerían pipelines separados para texto y visión.
El modelo CDF Sim2Real SMT Solderlight es más específico: está diseñado para transformar recortes sintéticos de componentes de circuitos impresos (PCB) en un estilo de iluminación de inspección óptica. No es un decisor de calidad, sino una herramienta de preprocesamiento visual que requiere un sistema posterior de inspección y revisión humana.
La simplificación de las arquitecturas de búsqueda es una consecuencia directa de la capacidad de procesar documentos mixtos en una sola etapa. Anteriormente, los sistemas de recuperación a menudo requerían pipelines separados para el texto y la visión, lo que implicaba una mayor complejidad en la orquestación de servicios y en la gestión de la latencia. Al integrar ambas modalidades en un único modelo, los equipos de ingeniería pueden reducir la cantidad de componentes intermedios y optimizar el flujo de datos, lo que se traduce en una infraestructura más coherente y potencialmente más eficiente en el manejo de consultas complejas.
En el caso específico del modelo CDF Sim2Real SMT Solderlight, su función se limita estrictamente al preprocesamiento visual. Está diseñado para transformar recortes sintéticos de componentes de circuitos impresos en un estilo de iluminación que imita la inspección óptica. Es fundamental destacar que este modelo no actúa como un decisor de calidad ni realiza una clasificación de defectos; su rol es preparar la imagen para etapas posteriores. Por lo tanto, cualquier sistema de inspección que utilice esta herramienta debe incorporar mecanismos de revisión humana o sistemas de detección de defectos independientes para garantizar la validez de los resultados finales.
Precio, límites y lo que falta por comprobar
No hay tarifas por API publicadas. El coste para el usuario se limita a la infraestructura propia: GPU, memoria, almacenamiento y operación. Los modelos de 8B parámetros requieren hardware más potente que la variante de 1B, que está diseñada para entornos con recursos limitados.
Un límite importante es el contexto de 32.768 tokens compartidos entre texto e imagen. Además, las imágenes se procesan con un lado mayor de 1.120 píxeles por defecto, ampliable a 1.540. No se han publicado benchmarks numéricos independientes para estos checkpoints específicos, por lo que la evaluación de rendimiento debe realizarse por el usuario en su propio contexto.
La ausencia de tarifas por API publicadas implica que la inversión económica se centra exclusivamente en la infraestructura de cómputo propia. El usuario debe provisionar GPUs, memoria y almacenamiento adecuados para soportar la carga de trabajo de inferencia. La variante de 1B parámetros está orientada a entornos con recursos limitados, ofreciendo una opción más ligera, mientras que los modelos de 8B parámetros demandan hardware más potente para gestionar su mayor complejidad. Esta distinción permite a las organizaciones adaptar su despliegue a sus capacidades de cómputo disponibles, equilibrando el rendimiento esperado con el coste operativo de la infraestructura.
El límite de contexto de 32.768 tokens compartidos entre texto e imagen es una restricción técnica que debe ser considerada en el diseño de las consultas. Además, el procesamiento de imágenes se realiza por defecto con un lado mayor de 1.120 píxeles, aunque este parámetro es ampliable hasta 1.540 píxeles. Dado que no se han publicado benchmarks numéricos independientes para estos checkpoints específicos, la evaluación del rendimiento no puede basarse en métricas externas preestablecidas. En consecuencia, es responsabilidad del usuario realizar pruebas exhaustivas en su propio contexto de aplicación para validar la latencia, la precisión y la escalabilidad del sistema antes de su implementación en producción.
Especificaciones técnicas clave
Comparativa de parámetros, dimensiones de salida y límites de contexto.
| Modelo | Parámetros | Dimensión de salida | Límite de contexto |
|---|---|---|---|
| Nemotron 3.5 Rerank 8B | 8,38B | Logit de relevancia | 32.768 tokens |
| Nemotron 3.5 Embed 8B | 8,38B | 4.096 (L2 normalizado) | 32.768 tokens |
| Nemotron 3.5 Embed 1B | 1,55B | 2.048 (L2 normalizado) | 32.768 tokens |
Consideraciones técnicas y despliegue
El despliegue requiere atención a las dependencias de software. Los ejemplos oficiales utilizan Transformers versión 5.20.0 con Flash Attention 2, mientras que vLLM 0.32.0 requiere un entorno con una versión inferior de Transformers. Es crucial revisar cualquier código remoto (trust_remote_code) antes de ejecutarlo en producción.
Para el modelo de imagen CDF Sim2Real SMT Solderlight, el entrenamiento se realizó con un área de 262.144 píxeles (512x512). Usar resoluciones muy diferentes puede degradar la calidad de la salida. El modelo deriva de Qwen-Image-Edit con un ajuste LoRA fusionado, lo que significa que se entrega como una pipeline completa, no como un adaptador independiente.
La gestión de dependencias de software es un aspecto crítico en el despliegue de estos modelos. Los ejemplos oficiales proporcionados utilizan la versión 5.20.0 de la librería Transformers junto con Flash Attention 2, mientras que el uso de vLLM 0.32.0 requiere un entorno con una versión inferior de Transformers. Esta incompatibilidad potencial exige una revisión cuidadosa de las versiones de las librerías para evitar errores de ejecución. Asimismo, la presencia de código remoto marcado con trust_remote_code requiere una auditoría de seguridad previa a su ejecución en entornos de producción, garantizando que no se introduzcan vulnerabilidades o comportamientos no deseados en el sistema.
Para el modelo de edición de imagen CDF Sim2Real SMT Solderlight, el entrenamiento se realizó con un área de 262.144 píxeles, correspondiente a una resolución de 512x512. El uso de resoluciones significativamente diferentes a la de entrenamiento puede degradar la calidad de la salida generada, por lo que se recomienda mantener las dimensiones de entrada dentro de rangos compatibles. Este modelo se entrega como una pipeline completa derivada de Qwen-Image-Edit con un ajuste LoRA fusionado, lo que significa que no es un adaptador independiente que pueda integrarse fácilmente en otras arquitecturas, sino un flujo de trabajo autónomo que debe ser desplegado como tal.
Pasos para el despliegue inicial
Proceso recomendado para integrar los modelos en un entorno de producción.
- 01Verificar la compatibilidad de la versión de Transformers y vLLM con el modelo específico.
- 02Descargar los pesos BF16 desde el repositorio oficial.
- 03Configurar el entorno de GPU con la memoria suficiente para el tamaño del modelo.
- 04Realizar pruebas de inferencia con datos de muestra para validar la latencia y la calidad.
- 05Implementar mecanismos de revisión humana para los modelos de inspección de imagen.
Qué sigue abierto
- No se han publicado benchmarks numéricos independientes para estos checkpoints específicos; las métricas mencionadas en las fichas oficiales no están verificadas de forma externa.
- El rendimiento real en entornos de producción puede variar significativamente dependiendo del hardware y la configuración del software.
- No se ha verificado la disponibilidad de una API comercial futura para estos modelos.
Continúa explorando
Fuentes consultadas
Correcciones y transparencia
Si detectas un dato incorrecto o desactualizado, puedes enviarnos una corrección indicando la página y la fuente que debemos revisar.
Proponer una corrección